懶人包
- 我把「英文 YouTube 副業影片 → 繁中可執行步驟」做成一支 87 行的 Python:抓字幕、交給
claude -p拆步驟、每條步驟逐條對回原字幕。- 關鍵設計是要求 AI 每條步驟都附一段逐字照抄的英文原句和秒數,程式再到該秒數前後 90 秒的字幕裡找這句話。
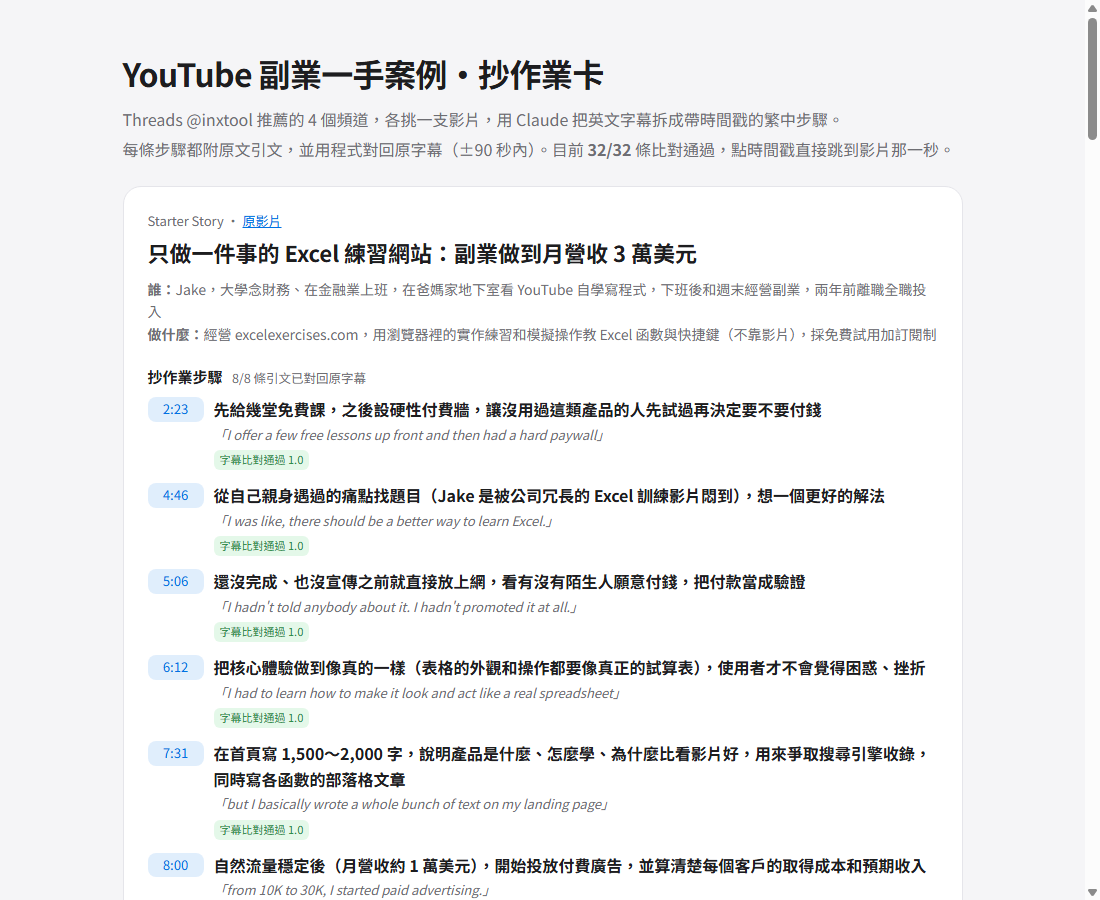
- Starter Story、Noah Kagan、Justin Welsh、Brett Malinowski 四支影片共 32 條步驟,32 條全部對得回原字幕。
- 反向測試 4 組:真引文通過;捏造句(0.13)、改寫句(0.30)、真引文配錯秒數(0.16)三組都被擋下,門檻 0.6。
- 它能證明「這句話影片裡真的有、而且在那個時間點」,證明不了繁中翻譯準不準,也證明不了影片裡的營收數字是真的。
Threads 上 @inxtool(臺大玩AI)有一篇貼文,建議做副業的人直接去 YouTube 看一手案例,點名 Starter Story、Noah Kagan、Justin Welsh、Brett Malinowski 四個人;英文有門檻的話,用沉浸式翻譯對照看,再用 Glasp 這類工具抓時間戳、畫線存下操作步驟。我截圖時這篇有 89 讚、152 次分享。
「翻譯加抓重點」這一段,我想交給 AI 自動做。AI 摘要影片的速度沒問題,我要處理的是另一件事:摘要裡每一條步驟,我要能一秒鐘找回影片裡的出處,而且這個比對由程式做,不靠我回去重看。
成果頁在 html.yanchen.app/yt-side-hustle-playbook,下面是它怎麼做的。
這套流程長什麼樣子?
四個步驟,兩支檔案:playbook.py(87 行)負責抓字幕、呼叫 Claude、驗證;render.py(102 行)把結果轉成一頁 HTML。用到的版本:
| 元件 | 版本 |
|---|---|
| youtube-transcript-api | 1.2.2 |
Claude Code CLI(claude -p) | 2.1.312 |
Python 標準庫 difflib | 內建 |
四個頻道實際在哪?
動手前我先用 yt-dlp 把四個頻道查了一遍,有兩個跟貼文的寫法對不太上:
| 貼文寫法 | 實際查到的 | 這次用的影片 |
|---|---|---|
| Starter Story | @StarterStory,專訪小生意創辦人 | pwvnH9S4j60,Excel 練習網站 |
| Noah Kagan | @noahkagan,AppSumo 創辦人自己的頻道 | 9Rcbt6Ydk0U,2023 年收入拆解 |
| Justin Welsh | @JustinWelsh 沒有影片分頁,他主要在 LinkedIn、X 和電子報 | ZkwYxYfkfYU,Peter Yang 訪談他 |
| Brett Malinowski | 頻道叫 The Brett Way(@thebrettway),@brettmalinowski 是另一個人 | E0WGLoVtNE4,讓 AI 7 天開廣告代操公司 |
怎麼抓 YouTube 字幕?
我先試 yt-dlp,抓字幕被 YouTube 回 429。換成 youtube-transcript-api 就抓得到,四支影片都有英文字幕:
pip install youtube-transcript-api==1.2.2from youtube_transcript_api import YouTubeTranscriptApi
def fetch_transcript(video_id: str) -> list[dict]:
snippets = YouTubeTranscriptApi().fetch(video_id, languages=["en"])
return [{"start": s.start, "text": s.text.replace("\n", " ")} for s in snippets]每行字幕帶一個 start 秒數。餵給 Claude 時我把它攤成 [142] I offer a few free lessons up 這種格式,讓模型看得到每句話的時間點。
怎麼讓 Claude 輸出可以驗證的步驟?
prompt 的重點只有兩條:只能根據逐字稿,以及每條步驟都要附原文。JSON 格式裡的 steps 長這樣:
"steps": [{"t": 秒數整數,
           "action": "繁中可執行動作(動詞開頭)",
           "quote": "逐字稿原文英文片段,6~20 個字,必須逐字照抄同一行或相鄰行"}]
action 是給人看的繁中步驟,quote 是給程式驗的證據。限制 6~20 個字是為了讓引文短到能落在相鄰幾行字幕內,又長到不會隨便撞到別的句子。
呼叫方式是把逐字稿從 stdin 丟進 claude -p:
proc = subprocess.run(
    ["claude", "-p", PROMPT, "--output-format", "text"],
    input=body, capture_output=True, text=True, encoding="utf-8", timeout=600,
)
同一個 JSON 裡我還要了 numbers(影片講到的營收、成本,各附秒數)和 caveats(照抄前要想清楚的前提)。
怎麼用程式驗證 AI 給的原句?
驗證函式不到 20 行:
WINDOW_SEC = 90
MATCH_THRESHOLD = 0.6

def norm(s: str) -> str:
    return re.sub(r"[^a-z0-9 ]", "", s.lower())

def verify_step(step: dict, lines: list[dict]) -> dict:
    quote = norm(step.get("quote", ""))
    best, best_t = 0.0, None
    nearby = [i for i, l in enumerate(lines) if abs(l["start"] - step["t"]) <= WINDOW_SEC]
    for i in nearby:
        chunk = norm(" ".join(l["text"] for l in lines[i:i + 3]))
        if quote in chunk:
            return {"verified": True, "score": 1.0, "matched_t": int(lines[i]["start"])}
        m = SequenceMatcher(None, quote, chunk).find_longest_match(0, len(quote), 0, len(chunk))
        score = m.size / max(len(quote), 1)
        if score > best:
            best, best_t = score, int(lines[i]["start"])
    return {"verified": best >= MATCH_THRESHOLD, "score": round(best, 2), "matched_t": best_t}
三個設計決定:
- 相鄰 3 行串起來比。YouTube 自動字幕常把一句話切在兩三行,
I offer a few free lessons up和front and then had a hard paywall就是分開的兩行。 - 只在 ±90 秒內找。這樣引文本身是真的、但秒數標錯的情況也會被擋,時間戳才有意義。
- 分數 = 最長共同片段 ÷ 引文長度。去掉標點和大小寫後整句包含就給 1.0;否則看最長連續相同的字元有多長,0.6 以上算通過。
四支影片跑出來的結果
python playbook.py pwvnH9S4j60 9Rcbt6Ydk0U ZkwYxYfkfYU E0WGLoVtNE4
python render.py
pwvnH9S4j60: 457 行字幕, 8 步, 對字幕驗證通過 8/8
9Rcbt6Ydk0U: 438 行字幕, 8 步, 對字幕驗證通過 8/8
ZkwYxYfkfYU: 1234 行字幕, 8 步, 對字幕驗證通過 8/8
E0WGLoVtNE4: 372 行字幕, 8 步, 對字幕驗證通過 8/8
site/index.html: 4 張卡, 32/32 驗證通過, 23493 bytes第一支從抓字幕到驗證完花了 57 秒。拆出來的步驟長這樣(節錄,分數都是 1.0):
| 影片 | 秒數 | 繁中步驟 | AI 附的原句 |
|---|---|---|---|
| Starter Story | 143 | 先給幾堂免費課,之後設硬性付費牆 | I offer a few free lessons up front and then had a hard paywall |
| Noah Kagan | 126 | 自己先領固定底薪,年底有利潤才分紅 | if we have profit at the end of the year do I get a distribution |
| Justin Welsh | 580 | 每季列出一週工作,算時數與貢獻,只做前 20% | something I do generally quarterly is I'll just like lay out my week |
| Brett Malinowski | 83 | 月費 1,500 美元,1,200 當廣告預算、300 當服務費 | would allocate $1,200 to the ads budget and keep $300 as the fee |
驗證器擋得住什麼?
32/32 只證明 AI 這次沒亂編,證明不了驗證器真的會擋。所以我拿 Starter Story 那支的字幕,手動餵四組輸入給 verify_step:
| 測試 | 輸入 | 分數 | 結果 |
|---|---|---|---|
| 真引文 | 143 秒,I offer a few free lessons up front and then had a hard paywall | 1.00 | 通過 |
| 捏造句 | 143 秒,I spent ten thousand dollars on Facebook ads in the first month | 0.13 | 擋下 |
| 改寫句 | 143 秒,gave away some free lessons and then put up a paywall | 0.30 | 擋下 |
| 秒數錯 | 600 秒,跟真引文同一句 | 0.16 | 擋下 |
字幕比對證明不了什麼?
這個驗證只回答一個問題:AI 附的那句英文,影片裡在那個時間點真的有人說過。以下三件事它管不到:
- 繁中
action有沒有翻過頭。原句是真的,但 AI 寫的繁中步驟可以比原句多講一點。卡片上原句跟步驟並排,就是為了讓人一眼對照。 - 影片裡的數字是不是真的。月營收、年收入都是當事人自述,字幕比對只能證明他有這樣說。
- 這套做法換一個人還有沒有效。這部分我交給
caveats欄位,每張卡都附幾條「照抄前先想清楚」。
- Brett 那支:影片結束時第一個客戶還是免費試用,1,500 美元月費還沒收到。
- Justin Welsh 那支:他自己說 2018 年選 LinkedIn 時那裡還很少人寫長文,算是搭上時機。
- Starter Story 那支:網站是五、六年前做的,主持人也提到這幾年 web app 圈變化很大。
跟 Glasp 手動畫線怎麼選?
Glasp 是瀏覽器擴充,在 YouTube 旁邊顯示逐字稿,畫線就存下時間戳。兩種做法解的是不同的事:
| 情境 | 選哪個 |
|---|---|
| 一支影片、邊看邊想 | Glasp 或沉浸式翻譯手動看,自己判斷什麼重要 |
| 一次整理多支影片、要可分享的成品 | 這支腳本,跑完直接得到帶出處的卡片頁 |
| 影片沒有字幕 | 兩個都不行,要先轉錄,可以參考 WhisperX 逐字時間戳 |