懶人包
- 個人知識庫是寫給未來自己的筆記系統,價值在「要做事時查得到、看得懂」,不在存了多少。
- 照著做最省事的是 Tiago Forte 的 CODE 四步:收集(Capture)、整理(Organize)、提煉(Distill)、產出(Express)。
- 整理有兩派:PARA 按「能不能行動」分成專案、領域、資源、封存四格;卡片盒(Zettelkasten)一張卡一個想法,靠固定編號和連結長成網。
- 我的實測:把 2026-10-22 到 11-08 透過 LINE 交辦的 196 筆任務,串成 92 條任務鏈、分成固定 7 類,每筆回填
topic,每類一頁索引。- 規則分類只做對大部分,92 條鏈裡有 25 條要人工改判;分類固定不擴充,換來的是新網址進來時判讀穩定。
- 跟 LLM Wiki 的分工:LLM Wiki 讓 AI 把資料寫成知識頁,這套把「做過的事」當收件匣,重點是下次接續而不是重做。
個人知識庫是什麼?
個人知識庫(Personal Knowledge Base,也常被叫「第二大腦」)是你為未來的自己整理的筆記系統。它跟資料夾、書籤、聊天紀錄的差別只有一個:它被設計成要做事時拿得出來用。
判斷一套知識庫有沒有在運作,看的不是筆記數量,是這兩件事:
- 要開始一件事時,你會不會先查它。
- 查到的東西,你幾秒內看不看得懂。
從零開始怎麼建?CODE 四步
我採用的框架是 Tiago Forte 在 Building a Second Brain 提出的 CODE,Forte Labs 的概覽文把四步定義得很清楚:
| 步驟 | 做什麼 | 最小可行做法 |
|---|---|---|
| Capture 收集 | 把有共鳴的想法、資料存到「同一個地方」 | 手機、瀏覽器、通訊軟體都丟進一個收件匣,不當下整理 |
| Organize 整理 | 按「能不能行動」分類,以進行中的專案優先 | 每週一次把收件匣清掉,搬進 PARA 四格 |
| Distill 提煉 | 每次重讀就把重點再壓縮一層(漸進式摘要) | 先粗體標重點,第二次再寫一句自己的話 |
| Express 產出 | 把存下來的東西變成作品或決定 | 寫文章、做簡報、開新專案前先搜一次知識庫 |
整理要按什麼分?PARA 與卡片盒
整理這一步有兩種主流做法,解決的問題不一樣。
PARA:按行動性分四格
PARA 同樣是 Tiago Forte 提出,四格的定義是:
- Projects 專案:有明確目標、有結束日的短期工作。
- Areas 領域:需要長期持續照顧的責任,例如健康、財務、某個職責。
- Resources 資源:你有興趣、正在學的主題。
- Archives 封存:前三格裡已經不活躍、但之後可能會用到的東西。
卡片盒:一張卡一個想法,靠連結長成網
卡片盒(Zettelkasten)來自德國社會學家 Niklas Luhmann。zettelkasten.de 的入門文整理了三個核心原則:
- 原子化:一張卡只寫一個想法。
- 連結:卡和卡互相連,而且每條連結要說明為什麼連。
- 固定編號:每張卡有不會變的位址,才能被引用。
[[頁名]] 雙向連結,就是卡片盒在數位工具裡的樣子。
兩種怎麼選?
| 你的需求 | 適合 |
|---|---|
| 筆記主要服務手上的工作、想快速找到「這個專案的資料」 | PARA |
| 筆記主要服務思考與寫作、想讓舊想法互相碰撞 | 卡片盒 |
| 兩者都要 | PARA 管資料夾,卡片盒的連結寫在筆記內容裡 |
知識庫平常怎麼用?
建好之後,日常使用只有三個固定動作:
- 做事前先查:開新專案、寫文章、回答別人問題前,先搜一次知識庫。這是整套系統唯一會產生價值的時刻。
- 定期清收件匣:一週一次,把收件匣的東西搬到該去的格子,不想要的直接刪。
- 用到才提煉:查到某則筆記、真的拿來用了,順手把重點再壓一層。沒被用到的筆記自然沉到封存,不必花力氣維護。
實測:把 196 筆 LINE 交辦整理成知識庫
我的情境比一般筆記多一層:我在 LINE 丟網址給 Claude Code,它在背景開 session 做研究、寫部落格、做 Shorts 或做 demo,每筆任務都會留下一個 markdown 檔(我叫它 item),frontmatter 記著標題、類型、狀態、可以接續的 sessionId 和報告路徑。
從 2026-10-22 到 11-08,累積了 196 筆:
| 類型 | 筆數 |
|---|---|
| 研究 | 74 |
| Shorts | 65 |
| 部落格 | 48 |
| demo(build) | 9 |
第一步:把任務串成鏈
一則網址常會長出好幾筆任務:先研究,研究完接著寫部落格,再接著做 Shorts。後續任務的 request 欄位會寫「延續任務 summary 開頭寫「已由任務
def parent(d):
    ids = [x for x in re.findall(r'[延接]續任務 ?(\d{8}-\d{6}(?:-\d)?)', d.get('request', '') or '')
           if x in items and x != d['id']]
    m = re.match(r'已由任務 ?(\d{8}-\d{6}(?:-\d)?) ?完成', d.get('summary', '') or '')
    if m and m.group(1) in items: ids.append(m.group(1))
    return ids[-1] if ids else None
結果是 92 條鏈,其中 47 條不只一筆,最長的一條有 6 筆。鏈的意義是:同一件事的研究、文章、影片放在一起,下次要接續時只要找到鏈頭。
第二步:用固定 7 類分類
分類規則是「由上往下,第一個符合的為準」,越窄的類放越前面:
| 主題 | 筆數 | 鏈 |
|---|---|---|
| line-talk 與頻道營運 | 10 | 10 |
| 內容取得失敗 | 3 | 1 |
| AI 原創短劇 | 25 | 16 |
| 小遊戲與互動網頁 | 21 | 12 |
| 爆款拆解與副業 | 31 | 11 |
| AI 影片與動畫製作 | 39 | 17 |
| Claude Code 與 AI 工具實測 | 67 | 25 |
這一步的取捨是:分類固定 7 個、不新增。好處是新網址進來時只有 7 個選項,判讀結果穩定、舊鏈找得到;代價是邊界案例要硬塞進最接近的一類。
第三步:回填欄位、每類一頁索引
196 筆 item 全部加上 topic: "<分類>" 欄位(改之前先整包備份)。每類另外產一頁索引,按鏈列出每筆的類型、狀態、sessionId 和報告路徑:
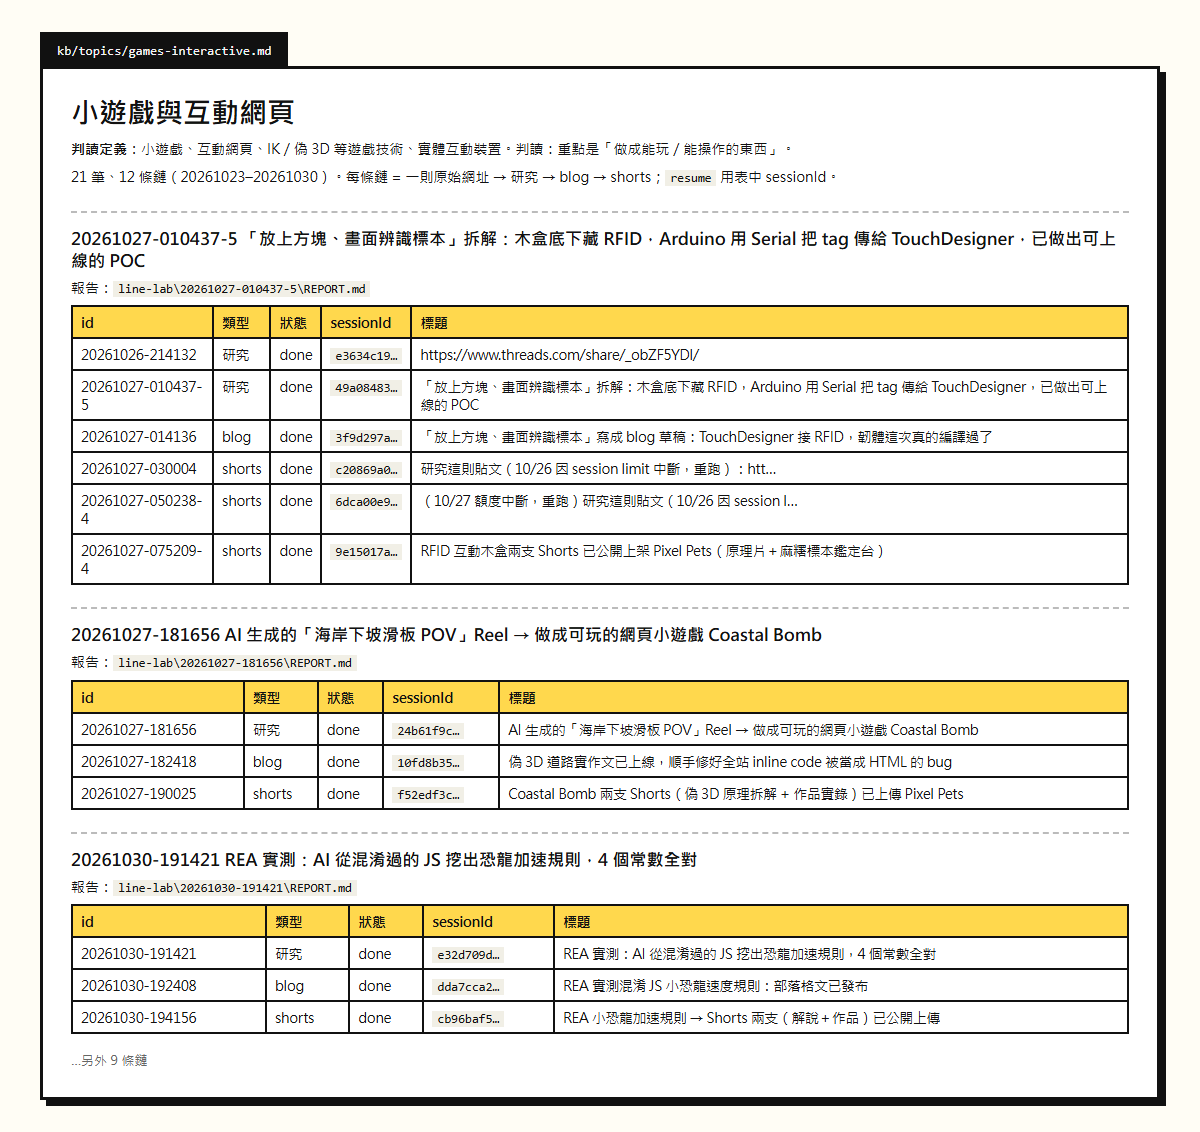
總索引頁則放 7 類的判讀定義,例如「小遊戲與互動網頁」的判讀是「重點是做成能玩、能操作的東西」,「爆款拆解與副業」的判讀是「重點是這能不能賺錢、數字是不是真的」。
第四步:接回使用端
知識庫要被用到,才有價值。我把它接在兩個地方:
- 新網址判讀:Claude 收到新網址時,先查同主題頁的舊鏈,決定要開新 session 還是接續舊的,並把
topic填成 7 類之一。 - 接收端提示:LINE 接收端本來就會把每筆舊任務的分類列給模型看,並要求沿用既有分類,所以新任務會自然落在這 7 類裡。
這套對應到 CODE 的哪一步?
| CODE | 照書的做法 | 這次的對應 |
|---|---|---|
| 收集 | 手動丟進收件匣 | LINE 交辦自動產生 item,不用額外動作 |
| 整理 | PARA 四格、每週清收件匣 | 任務鏈 + 固定 7 類 + 每類一頁索引 |
| 提煉 | 重讀時標重點、寫成自己的話 | item 標題本身寫成結論,細節在每筆的報告檔 |
| 產出 | 要做事前先查 | 新網址判讀時先查同主題舊鏈,決定接續或新開 |
跟 LLM Wiki 差在哪?
同一天我也照 Karpathy 的 LLM Wiki 做過一次實測:把 12 份研究報告丟給 Claude Code,讓它寫出 75 頁互相連結的知識頁,過程寫在 LLM Wiki 實作:Claude Code + Obsidian 把 12 份筆記編成 75 頁知識庫。
| LLM Wiki | 這次的任務知識庫 | |
|---|---|---|
| 原始資料 | 報告、文章等「讀過的東西」 | 交辦紀錄等「做過的事」 |
| AI 做什麼 | 寫摘要頁、概念頁、補連結 | 判讀分類、找舊鏈 |
| 結構 | 卡片盒式,概念頁互相連 | PARA 式,固定分類 + 鏈 |
| 主要用途 | 問問題、找概念關聯 | 接續舊任務、避免重做 |
限制與還沒做完的
- 規則分類需要人工改判:92 條鏈有 25 條要人工改,關鍵字規則適合當第一輪,不能直接當最終結果。
- 固定分類會有邊界案例:一則「用 AI 做遊戲宣傳影片」的網址,同時像遊戲也像影片,只能照判讀順序歸到第一個符合的類。
- 接收端還沒強制:目前接收端給模型的提示是「分類 2 到 8 字、盡量沿用舊分類」,沒有鎖死在 7 類;要完全鎖住需要再改接收端的提示。
- 還沒驗過新網址的完整流程:分類、回填和索引都做完了,但還沒用一則新的 LINE 網址從頭跑一次,確認新任務真的落在 7 類並接上舊鏈。
從今天開始建,先做哪三件事?
- 選一個收件匣:手機、電腦、通訊軟體的東西都丟同一個地方,可以是 Obsidian 的一個資料夾,也可以是傳給自己的聊天室。
- 每週清一次:搬進 PARA 四格,或至少分成「進行中」和「封存」兩格。
- 下次開工前先搜一次:這是讓知識庫活下來的唯一習慣。搜到了就順手提煉一層,搜不到就把這次做完的結果存回去。