懶人包
- LLM Wiki 起手包的核心只有三樣:
raw/、wiki/兩個資料夾,一份寫給 Claude Code 的CLAUDE.md,以及 ingest/query/lint 三個指令。- 我拿 12 份自己的研究報告實跑:
claude -p逐份 ingest 共 632 秒,長出 73 頁、180 條連結;lint 再花 1 分 56 秒補到 75 頁、207 條連結,死連結和孤兒頁都是 0。- 前 4 份 ingest 只新建頁、不改舊頁;第 5 份之後每份會回頭編輯 1–3 頁既有頁面。連結變密是從這裡開始的。
- lint 找出一個我沒整理過的共通做法:「
claude -p當 LLM 後端」出現在 4 個不同專案,它自己建了一頁把它們串起來。- 整套在 Windows 11 + Git Bash 跑完,Claude Code 版本 2.1.318;限制是規則遵守不到 100%(query 沒照規定寫 log),還有登入憑證會到期,排程前要先處理。
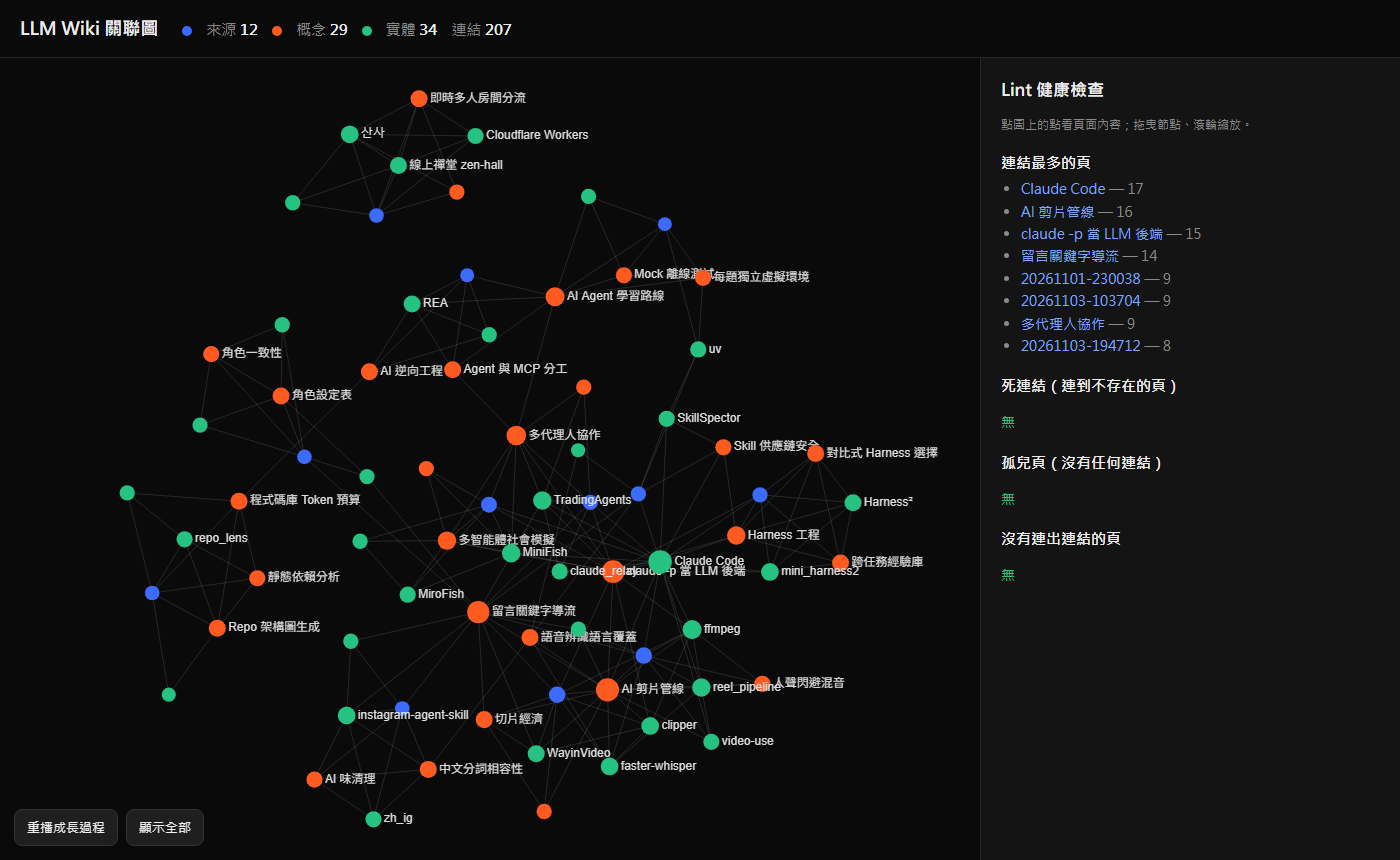
這篇要回答一個問題:照著 Karpathy 的 LLM Wiki 做法,用 Claude Code 自動整理筆記,實際跑起來會長成什麼樣子、要準備哪些檔案、花多少時間。
起因是 Facebook 粉專「不加班社畜」的一支 Reel。作者說他的 Obsidian 知識庫有 297 頁筆記(概念 36、實體 5、來源 254,加上目錄與紀錄 2 頁),從 2026-04-16 長到現在,頁面之間的連結都是 Claude Code 補的,不是他自己拉的。他整理了一份「第二大腦起手包」,內容是建資料夾、寫 CLAUDE.md、每天用三個指令,但要留言才私訊給你。
我沒去拿那份起手包。做法本身出自 Karpathy 公開的 LLM Wiki gist,我直接照 gist 寫一份自己的規則檔,拿手邊 12 份研究報告跑一遍。下面是完整的檔案、指令和數據。
🧱 起手包裡到底有什麼?
Karpathy 的 gist 把系統分成三層:
| 層 | 內容 | 誰寫 |
|---|---|---|
| raw | 原始資料(文章、報告、逐字稿) | 你放進去,LLM 只讀不改 |
| wiki | 摘要頁、概念頁、實體頁、index.md、log.md | LLM 寫,你只讀 |
| schema | CLAUDE.md(Claude Code)或 AGENTS.md(Codex) | 你和 LLM 一起改 |
- ingest:丟一份新資料進 raw,LLM 讀完寫摘要頁,順便更新相關的概念頁和實體頁。
- query:對 wiki 發問,LLM 先讀
index.md找頁,再讀頁面回答,每個論點附來源。好的答案可以存回 wiki 變成新頁。 - lint:定期體檢,找死連結、孤兒頁、近義重複頁、該有頁面卻沒有的概念。
[[頁名]] wikilink,Obsidian 打開資料夾就會畫出關聯圖。
📄 CLAUDE.md 規則檔要寫什麼?
整套系統的品質幾乎都押在這份檔案上。這是我實際用的版本,放在 vault 根目錄(frontmatter 範例和 lint 的腳本路徑兩段我精簡成一句,其餘照原文):
# LLM Wiki 規則(Claude 維護,人只讀)

本資料夾是一個 Obsidian vault。`raw/` 是原始資料,**只讀不改**。`wiki/` 由 Claude 寫。


| 路徑 | 內容 |
|------|------|
| `raw/` | 原始資料(每份一個 .md),不可修改 |
| `wiki/sources/` | 每份原始資料一頁摘要,檔名 = raw 檔名 |
| `wiki/concepts/` | 概念頁(技術、方法、現象),檔名用繁中短名詞 |
| `wiki/entities/` | 實體頁(具名的工具、產品、專案、平台、人),檔名用原名 |
| `wiki/index.md` | 全部頁面目錄,每頁一行:`- [[頁名]] — 一句話摘要` |
| `wiki/log.md` | 只追加的操作紀錄,格式 `## [YYYY-MM-DD] ingest | <標題>` |

## 頁面格式

每頁開頭 frontmatter:type(source / concept / entity)、tags、sources。
連結一律用 Obsidian wikilink `[[頁名]]`(不加路徑、不加 .md)。頁名必須是實際存在的檔名。

## ingest <raw 檔名>

1. 讀 `raw/<檔名>` 與 `wiki/index.md`。
2. 寫 `wiki/sources/<檔名>`:一句話結論、3–6 條重點、`## 相關` 列出連到的概念與實體。
3. 找出這份資料涉及的 2–5 個概念、1–4 個實體:
   - 已存在的頁 → **編輯**加入新資訊與回連,不要重開近義頁。
   - 不存在 → 新建。新建前先看 index 有沒有近義頁。
4. 概念頁之間若有關係,互相加 `[[ ]]`。
5. 更新 `wiki/index.md`、追加 `wiki/log.md`。

## 規則

- 繁體中文。只寫 raw 裡有的事實,不推測。
- 每頁至少有一個連出連結,不可留孤兒頁。

## query <問題>

1. 先讀 `wiki/index.md` 找相關頁,再讀那些頁;不夠才回頭讀 `raw/`。
2. 回答時每個論點附來源頁 `[[頁名]]`。
3. 答案有長期價值 → 存成概念頁或補進既有概念頁,更新 index,log 追加一筆。

## lint

1. 跑結構檢查,取得死連結、孤兒頁、無連出頁清單。
2. 修:死連結改連到正確頁或建頁;孤兒頁補連結;近義重複頁合併。
3. log 追加 `## [日期] lint | 修了什麼`。
三個設計決定影響最大:
- 「已存在就編輯,不要重開近義頁」。少了這句,LLM 每份資料都會開新頁,最後變成一堆互不相連的孤島。
- ingest 第一步就讀
index.md。這是 LLM 知道「已經有哪些頁」的唯一途徑。gist 提到這個做法在中等規模(約 100 份來源、數百頁)不需要向量資料庫。 - 「只寫 raw 裡有的事實」。LLM 寫摘要時很容易順手補背景知識,規則要明講。
⚙️ 怎麼讓 Claude Code 自動跑 ingest?
互動模式下直接打「依 CLAUDE.md 的 ingest 流程處理 raw/xxx.md」就行。我要一次跑 12 份,所以寫了一支迴圈,用 claude -p(非互動模式)逐份處理:
#!/bin/bash
# 依序把 vault/raw/ 每份資料交給 claude -p 做 ingest
cd "$(dirname "$0")/../vault"
for f in $(ls raw/*.md | xargs -n1 basename); do
  if grep -q "ingest | .*$f" wiki/log.md 2>/dev/null || [ -f "wiki/sources/$f" ]; then echo "skip $f"; continue; fi
  start=$(date +%s)
  echo "=== $(date +%H:%M:%S) ingest $f"
  claude -p "依 CLAUDE.md 的 ingest 流程處理 raw/$f。log 標題寫 $f。完成後只回一行:新建幾頁、編輯幾頁。" \
    --model sonnet --allowedTools "Read,Write,Edit,Glob,Grep" --permission-mode acceptEdits < /dev/null
  echo "--- $f done in $(( $(date +%s) - start ))s"
done
幾個參數的用途:
--allowedTools只開讀寫檔案和搜尋,不給 Bash,LLM 就沒辦法在 vault 裡亂跑指令。--permission-mode acceptEdits讓寫檔不用每次確認,迴圈才能無人值守。< /dev/null避免claude -p卡在等 stdin。- log 已有紀錄或已經有摘要頁的就跳過,中斷後重跑不會重做。
📊 12 份報告跑完長出什麼?
素材是我 2026-10-30 到 11-03 的 12 份研究報告,主題橫跨 AI 剪片、多代理人模擬、Claude Code harness、IG 經營。逐份 ingest 的實際輸出:
| 順序 | 耗時 | 新建頁 | 編輯既有頁 |
|---|---|---|---|
| 1 | 40 秒 | 7 | 0 |
| 2 | 64 秒 | 7 | 0 |
| 3 | 51 秒 | 6 | 0 |
| 4 | 69 秒 | 7 | 0 |
| 5 | 43 秒 | 5 | 1 |
| 6 | 45 秒 | 6 | 1 |
| 7 | 43 秒 | 6 | 2 |
| 8 | 70 秒 | 6 | 1 |
| 9 | 54 秒 | 7 | 2 |
| 10 | 44 秒 | 5 | 3 |
| 11 | 50 秒 | 5 | 2 |
| 12 | 59 秒 | 6 | 2 |
| 合計 | 632 秒 | 73 | 14 |
index.md 和 log.md,那兩個每次都會更新。
這張表最值得看的是右邊那欄。前 4 份資料主題各自獨立,LLM 只有新建頁的份。從第 5 份開始,新資料碰到的概念已經有頁了,它就回頭去改舊頁、加回連。例如第 11 份報告(TradingAgents 多代理人交易)同時編輯了「留言關鍵字導流」和「Claude Code」兩頁。連結密度是靠這種回頭編輯長出來的,資料越多、重疊越多,每份 ingest 碰到的舊頁就越多。
Karpathy 在 gist 裡寫一份資料「可能碰到 10–15 頁」。我這批每份碰 5–10 頁(新建加編輯),比他少,原因是我的 wiki 才剛起步、能編輯的舊頁還不多。
ingest 完的 lint 結構檢查:73 頁、180 條連結,死連結、孤兒頁都是 0。
🔍 lint 能找出你沒發現的關聯嗎?
lint 我分兩段做:
- 一支 Python 腳本掃所有
[[頁名]],算出死連結、孤兒頁、沒有連出的頁,以及連結最多的節點。 - 把結果丟給
claude -p,讓它照 CLAUDE.md 的 lint 規則修。
## [2026-11-08] lint | 無近義重複頁可合併;補 9 頁互連;新建概念「claude -p 當 LLM 後端」與實體「ffmpeg」「claude -p 當 LLM 後端」這頁是整次實驗最有價值的產出。四份不同時間做的研究,各自用了 claude -p 當腳本裡的 LLM:一個是 330 行的 mini harness,一個是長片切 Shorts 的工具,一個是把 OpenAI 格式請求轉給 claude -p 的 relay,一個是多代理人社會模擬。我做的時候沒有把它們當成同一件事,ingest 時也各自寫在不同頁裡。lint 讀完全部頁面後,把這個共通做法抽成獨立概念頁,連到四份來源,還整理出一條規律:量大的子任務用 haiku,需要判斷的編輯與反思用 sonnet。
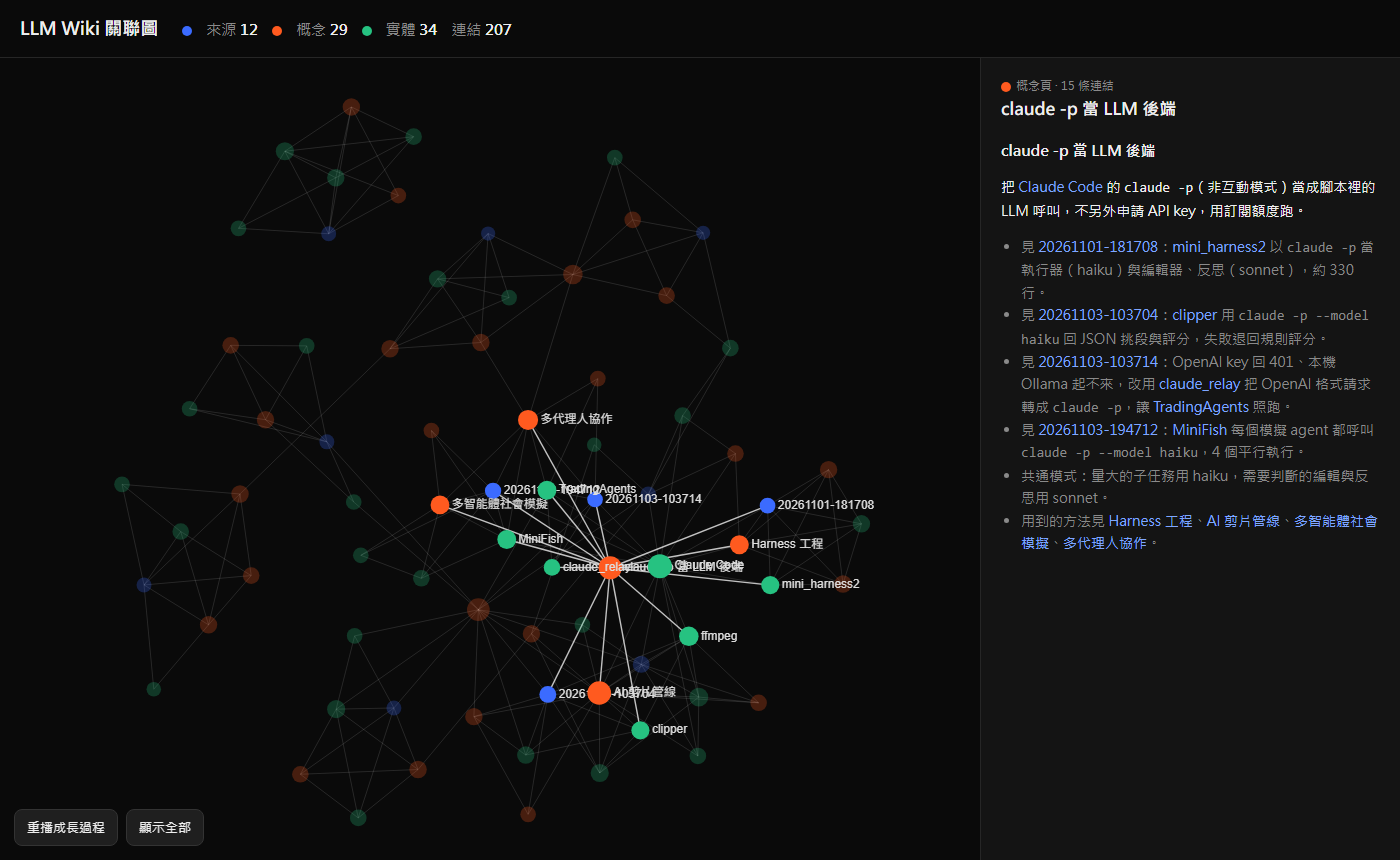
這頁新建後立刻變成第三大節點(15 條連結),只輸給 Claude Code(17)和 AI 剪片管線(16)。我用 grep 回頭對過 raw 裡的四份原始報告,頁面內容都有出處。
lint 前後對照:
| 項目 | ingest 後 | lint 後 |
|---|---|---|
| 來源頁 | 12 | 12 |
| 概念頁 | 28 | 29 |
| 實體頁 | 33 | 34 |
| 連結數 | 180 | 207 |
| 死連結/孤兒頁/無連出頁 | 0/0/0 | 0/0/0 |
💬 query 好不好用?
我問了一題:「Shorts 產線可以直接重用之前研究過的哪些做法?」花 40 秒,回答是一張表,列出 5 個可直接用的做法、每個的驗證程度和對應頁面,後面再分四段寫各自的風險。每一行都附 [[頁名]],點下去就是來源。
它也懂得說「不知道」:回答開頭就寫「這幾次研究沒有直接講 YouTube Shorts,Shorts 的規格和政策只能從切片與政策那兩篇推導」。另外它把一條「YouTube 改名政策」的說法標成「來自新聞報導,不是官方條文」,這是 raw 裡原本就有的保留意見,它照實帶過來了。
⚠️ 實測踩到的坑與限制
規則遵守不是 100%。 CLAUDE.md 規定 query 有長期價值的答案要存回 wiki 並寫 log,但這次 query 沒寫 log。ingest 和 lint 都有照做。要靠 lint 或腳本檢查把關,不能假設 LLM 每次都照規則。
前期不會變密。 前 4 份的「編輯既有頁」都是 0。只放幾份資料就去看關聯圖,會看到一群各自分開的小團,這是正常的。
實體頁的比例看素材。 Reel 作者的知識庫實體只有 5 頁,我這批卻有 34 頁,因為我的研究報告裡具名工具很多(ffmpeg、faster-whisper、Three.js……)。比例差異來自素材,不是做法不同。
中心節點會擠。 Claude Code、AI 剪片管線這種大節點連了十幾條線,關聯圖中央的標籤會疊在一起,要拖曳或縮放才看得清楚。
排程前要處理登入。 每次 claude -p 執行都印出警告:目前的登入會在 2026-11-13 到 11-16 之間到期。手動跑沒差,要做成每晚自動 ingest 的話,先跑 claude setup-token 拿長效 token。
不要直接套在你現有的筆記上。 LLM 有寫入權限,會改既有頁面。已經有自己結構的 vault,先複製一份出來實驗。
近義頁合併沒有人工全檢。 lint 回報「無近義重複頁」,這是 LLM 自己的判斷,我沒有逐頁核對。
🖥️ Windows 能跑嗎?
可以。Reel 作者說他只在 Mac 測過,我這次全程在 Windows 11 上跑:Claude Code 2.1.318、Git Bash 執行上面那支 shell 迴圈、Python 跑 lint 腳本。CLAUDE.md 和 wiki 頁面都是純 markdown,跟作業系統無關。唯一要注意的是迴圈用的是 bash 語法,在 PowerShell 裡要改寫,或直接用 Git Bash 執行。
門檻和作者講的一樣:要有能用 Claude Code 的方案(Claude Pro 以上),claude -p 消耗的是訂閱額度,不需要另外申請 API key。
📚 延伸資源
- Karpathy LLM Wiki gist:原始做法說明,三層、三個操作、index 與 log 的設計都在裡面。
- 這次實驗的互動關聯圖:可以拖曳、點節點看頁面內容,還有「重播成長過程」按鈕,照 ingest 順序重現圖怎麼長出來。
- Karpathy LLM Wiki 是什麼?跟 RAG 差在哪:概念與現有實作整理。
- 個人知識庫怎麼讓 AI 真的用上?Obsidian + Claude Code hook 讀寫兩條路實作:我另一套用 hook 自動寫入、BM25 檢索的卡片庫,跟 LLM Wiki 是不同取向。
raw/ 跟上面那份 CLAUDE.md,丟 5 份以上主題有重疊的筆記進 raw,逐份 ingest 完再跑一次 lint,用 Obsidian 打開資料夾看圖。