懶人包
- Academic Humanizer 是 MorphMind 團隊(明尼蘇達大學 Jie Ding)開源的 Claude skill,MIT 授權,2026-11-08 查 3,740 星,本體是一份 261 行的 SKILL.md,專改 AI 輔助的論文和 NSF、NIH 計畫書。
- 我用同一個 Sonnet 跑三組對照,改寫同一份塞滿 AI 腔的中英文段落:skill 把英文 AI 套話從 29 個降到 1 個,只下一句「改到不像 AI 寫的」也是 1 個。
- 只下那一句的對照組會補內容:英文 9 處、中文 7 處原文沒有的說法,包含原稿沒寫的機制和實驗設定;skill 是 6 處和 3 處,多半是定義句、待填空格或語氣收窄這類輕微項目。
- 再加一句「不准新增事實」,捏造降到 4 處和 0 處,但「outperforms all prior approaches」「速度快、使用簡單」這些沒證據的誇大全部留著。
- 這個 skill 我會留下的是第 4 層規則:沒證據的主張砍掉或收窄,缺的東西列給作者補,英文那份列了 6 條。
- 每格只跑 1 次,「原文沒有的說法」由另一個 LLM 判定,結果只代表方向;用它改過的論文,AI 使用揭露義務照舊。
Academic Humanizer 是我從一支 YouTube Short 看到的,標題寫「Nature 報道的這個 Skill」。我想回答的問題很單純:一個 261 行的 prompt,比起自己下一句「幫我去 AI 味」,到底多做了什麼?
Academic Humanizer 是什麼?
它是放在 GitHub 上的純 prompt 型 skill,沒有程式碼,主體是一份 SKILL.md(我讀的是 v0.3.3,commit 94b88b2)。規則分六層:
| 層 | 內容 |
|---|---|
| 1 | 通用 AI 腔目錄,基於 blader/humanizer |
| 2 | 學術 AI 腔 11 類:過度宣稱的動詞、novelty padding、引用堆砌、Moreover 連發等 |
| 3 | 要保留的學術慣例,避免改過頭 |
| 4 | 主張與證據對齊:沒有數字、圖表或引用支撐的主張,補證據或降級語氣 |
| 5 | 模仿作者本人的文風與投稿場地 |
| 6 | NSF、NIH 計畫書模式 |
Nature 和 The Register 報導了什麼?
Nature 在 2026 年 7 月報導了這個工具,標題是〈'Humanizer' tool can erase signs of AI-written text — alarming scientists〉。我沒讀到 Nature 全文,以下取自 bioethics.com 的轉載摘錄:工具 6 月 20 日釋出,開發者是 Jie Ding,有研究者稱讚,也有人表達擔憂。
The Register 7 月 8 日的報導多了一個細節:README 原本寫「strip the tells of AI writing」,後來改成強調它是 writing-clarity tool。該文的疑慮是工具可能只把有問題的內容修飾得更像人寫,並不驗證論證本身。
這個疑慮可以測,所以我做了下面的對照。
三組對照怎麼設計?
原稿是我刻意塞滿 AI 腔的聯邦學習段落,中英各一份,方法 FedCal 是虛構的,數字和引用都放在裡面當作不可改動的基準。
A 組我沒有安裝成 skill,是把 SKILL.md 當 system prompt 傳進去,指令如下,在 Windows 的 Git Bash 跑:
claude -p --model sonnet \
  --append-system-prompt "$(cat SKILL.md)" \
  "Apply the academic-humanizer skill to the paper section below (document type: paper, venue: NeurIPS). Run non-interactively. ...$(cat en_draft.md)"
C 組比 B 組多這一句:
Do not add any fact, mechanism, experimental setting, result, or comparison that the original does not state.實測結果:誰會編內容?
| 指標(每格跑 1 次) | 原稿 | A 載入 skill | B 只叫它去 AI 味 | C 再加不准新增 |
|---|---|---|---|---|
| 英文 AI 套話命中 | 29 | 1 | 1 | 7 |
| 中文 AI 套話命中 | 27 | 2 | 2 | 5 |
| 英文:原文沒有的說法 | — | 6 | 9 | 4 |
| 中文:原文沒有的說法 | — | 3 | 7 | 0 |
| 沒證據的誇大 | 有 | 刪除或收窄 | 刪除,但補上新內容 | 大多留著 |
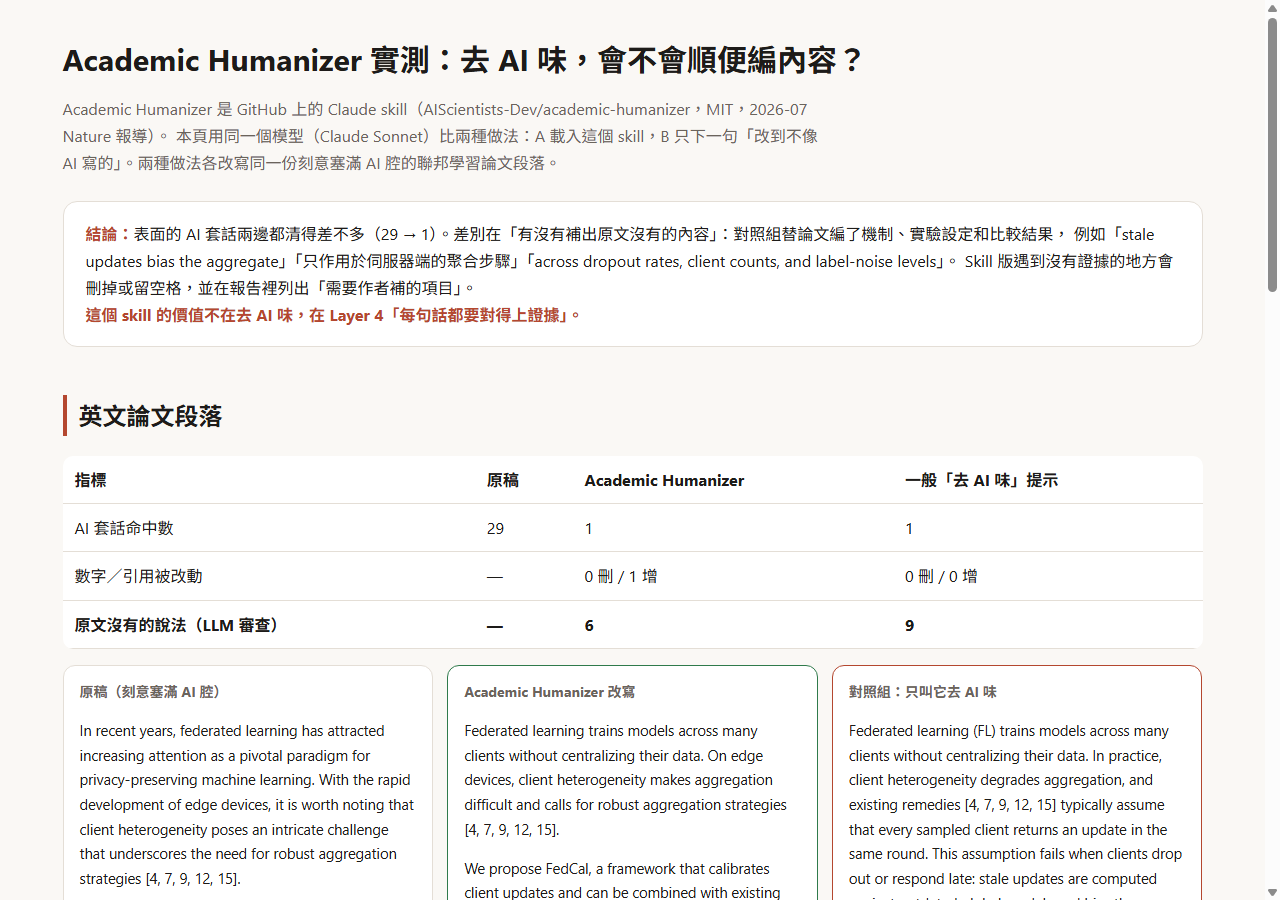
上圖是前兩組的完整比較頁,C 組是後來補跑的,沒有放進那一頁。
B 組的文字最順,也最危險。原稿只說 FedCal 會校準客戶端更新,B 組替它補了一段機制和實驗設計:
stale updates are computed against outdated global models and bias the aggregate
FedCal wraps existing server and client optimizers without modifying them
We evaluate FedCal on multiple benchmarks across dropout rates, client counts, and label-noise levels
原稿的實驗設定只有 20% dropout 一種。這幾句放進論文,讀起來完全合理,作者校稿時很容易放過。中文那份也一樣,B 組寫了原稿沒有的「FedCal 只作用於伺服器端的聚合步驟」。
C 組守住了事實,代價是原稿的毛病幾乎原封不動。英文版還留著 outperforms all prior approaches、FedCal is fast, simple,中文版留著「優於所有現有方法」「速度快、使用簡單」。它把「不准新增」理解成保留原文的所有主張,這個行為符合指令,只是對論文沒有幫助。
A 組的處理是第三種。整句「significantly outperforms all prior approaches」改成唯一有數字的那個比較:CIFAR-100、20% dropout、61.4% 對 FedProx 的 55.2%。「fast」「simple」沒有證據,直接刪除。它的 6 處裡,有 2 處是審查員自己註明「placeholder is not a claim」的待填空格,另外幾處是補了一句聯邦學習的定義這類輕微項目。
它多做的事:列出作者要補什麼
改寫稿後面附的報告才是我覺得最值得看的部分。英文那份列了 6 條「Needs your input」,節錄三條:
- 37% 的通訊成本降幅,比較基準是什麼?
- 原稿宣稱 wide range of benchmarks,只點名了 CIFAR-100,其他的列出來,或把這句拿掉。
- delayed participation 和 dropout 可能不是同一件事,要確認實驗真的測到前者。
怎麼安裝?誰適合用?
README 給的 Claude Code 安裝方式是 clone 進 skills 資料夾。這行我沒有實際裝進全域設定,我的實測走上面的 system prompt:
git clone https://github.com/AIScientists-Dev/academic-humanizer ~/.claude/skills/academic-humanizer適合:手上有 AI 輔助的論文、rebuttal 或計畫書初稿,而且數字和引用是自己掌握的人。
不適合:想直接拿到能交出去的成品。A 組會留下 [list the remaining benchmarks here] 這種空格,要作者自己填。
如果你只改部落格或一般文件,用不到學術規則,看通用版的 blader/humanizer 就夠了。想裝任何第三方 skill 之前,可以先照我掃 skill 的做法檢查內容。
限制與倫理邊界
- 樣本數小:每組中英各跑 1 次,模型換一次輸出就會不同,6 比 9 這種差距不能當統計結果。
- 原稿是我寫的虛構段落,AI 腔刻意灌滿,真實論文的命中數不會這麼高。
- 「原文沒有的說法」由 LLM 判定,判得偏嚴,所以我逐條看過並在上面區分了輕重。
- AI 套話偵測是我自己寫的 regex,沒有測任何第三方 AI 偵測器,所以這篇無法回答它能不能躲過偵測。
- A 組有套用 SKILL.md 的整套流程,B、C 組只有一句話,比較的是「這份 prompt」對「隨手一句」,不是對精心寫過的自訂 prompt。
- A 組的指令要求附上改寫報告,B、C 組只要求改寫文字,所以「列出作者要補的項目」只能看 A 組做了什麼,不能算成 B、C 組做不到。
拿對照組評估 skill 的做法,我也用在 i-have-adhd skill 的 A/B 測試。要評估一個 skill,先跑一次你自己會下的那句 prompt 當對照,差在哪裡通常很快就看得出來。