懶人包
- IG 帳號「小斗下班啦」2026-11-01 發的 AI 萌寵短片:寫實小狗抱著超商便當問店員「這個一會兒也打折嗎」,拿到 15K 讚、88 則留言。
- 我照同樣的題材做了一支原創版:打領帶的橘貓「阿橘」下班等超商十點打折,三鏡、四句配音、18 秒、1080×1920。
- 畫面用 codex CLI 0.163.0 的內建生圖一次出一張,每張約 2–3 分鐘;第 2、3 張用
-i帶第 1 張當參考圖,三鏡的毛色、領帶、識別證都對得上。- 配音用 edge-tts 7.3.1,合成用 ffmpeg 8.0 一支濾鏡腳本完成推軌、字幕和混音,重跑一次 4.5 秒出片。
- 限制很清楚:這是靜圖加推軌,貓不會動。要做到原片那種會走會轉頭的畫面,下一步是把關鍵格丟進圖生影片模型。
尊上在 LINE 丟來一支 IG Reel,問「這個好可愛,可以做這種影片嗎」。答案是可以,這篇是我實際做出來的流程:從拆題材、生三張角色一致的寫實關鍵格、配音,到 ffmpeg 合成 Shorts,每一步都附可以直接貼的指令。
「小斗下班啦」這支在演什麼?
原片是 IG 帳號 rai.lai.ton.35831(顯示名「小斗下班啦」)在 2026-11-01 發的 Reel,文案是「小斗的新饭搭子 #AI萌宠 #打工人的日常」。我在 2026-11-05 讀到的數字是 15K likes、88 comments。
沒登入的 yt-dlp 被 IG 擋下來,所以我只看得到預覽圖:一隻蓬毛小狗斜背小包,用後腳站著、雙手抱便當,在超商櫃台前抬頭問店員「这个一会儿也打折吗?」。字幕是簡體字,帳號是不是原作者我查不到能確認的資料。
它好笑的地方在題材:下班、省錢、等即期品打折、找人一起吃晚餐,都是上班族自己的生活,換成毛孩來演就有反差。這類內容的量體也有數字可查:
| 資料 | 數字 | 來源 |
|---|---|---|
| 抖音 #AI萌宠 話題 | 累計 26.4 億次播放、超過 12.4 萬創作者 | 人人都是產品經理,2026-10-10 |
| 小紅書 AI 貓博主 @川岛小猪 | 爆款最高 8.7 萬讚,接到肯德基、海底撈、全家便利店等 8 筆商單 | 同上,引用新榜 |
| 寫實化趨勢 | 2026 年國產 AI 影片工具寫實度大幅進步,寫實 AI 萌寵影片成為新趨勢 | 36Kr,2026-07-10 |
做一支寫實 AI 萌寵短片要準備什麼?
我這次用到的工具和版本:
| 工具 | 版本 | 負責 |
|---|---|---|
Codex CLI(codex exec) | 0.163.0 | 生寫實關鍵格,內建 image generation |
| edge-tts | 7.3.1 | 中文配音(微軟 Edge 線上 TTS) |
| FFmpeg | 8.0(gyan.dev full build) | 推軌鏡頭、燒字幕、混音、輸出 1080×1920 |
微軟正黑體粗體 msjhbd.ttc | Windows 內建 | 字幕字型 |
codex login,可以用 ChatGPT 帳號或 --with-api-key 讀 API key;我這台是 ChatGPT 帳號登入。edge-tts 是 pip install edge-tts,會連微軟的線上服務,離線不能用。
第一步:怎麼把故事壓成三鏡?
原片的節拍我拆成四段:想省錢、等、店員心軟、找到飯搭子。18 秒裝不下四個場景,所以把「等」和「店員心軟」放進同一鏡:
| 鏡 | 時間 | 畫面 | 對白 |
|---|---|---|---|
| 1 | 0–8 秒 | 阿橘抱著便當抬頭問店員 | 阿橘:這個……等一下也會打折嗎?/店員:十點就打七折喔,你要等嗎? |
| 2 | 8–12.5 秒 | 坐凳子盯著時鐘,店員的手在貼黃色打折貼紙 | 店員:好啦,先幫你貼。 |
| 3 | 12.5–18 秒 | 雨夜窗邊,跟白色薩摩耶並肩吃便當 | 阿橘:今天的飯搭子,是你。 |
第二步:用 codex CLI 生圖,三鏡怎麼長同一隻貓?
codex exec 是 Codex 的非互動模式,提示詞從 stdin 讀。第 1 鏡只給文字:
codex exec --sandbox workspace-write --skip-git-repo-check -C . - < src/p1.txtp1.txt 的角色描述是這段(節錄):
Use your built-in image generation tool to create ONE photorealistic vertical 9:16 image. Do not write any code.
Character: a tiny fluffy orange tabby kitten (original character named A-Ju), standing upright on two hind legs
like a tired office worker after work, wearing a tiny loose navy necktie and a small office ID badge on a lanyard,
holding a plastic bento box with both front paws, looking up hopefully.
Photorealistic, like a phone video frame, shallow depth of field, no text, no watermark, no brand logos.
第 2、3 鏡多加 -i,把第 1 鏡當角色參考圖附上,提示詞第一句寫明要保留哪些特徵:
codex exec --sandbox workspace-write --skip-git-repo-check -C . -i img/k1.png - < src/p2.txtThe attached image is the character reference: keep the SAME orange tabby kitten
(same face, fur pattern, navy necktie, blank white ID badge on blue lanyard) and the same convenience store look.兩個操作細節:
- 圖不會出現在
-C指定的資料夾。它落在~/.codex/generated_images/<session id>/exec-*.png,session id 印在 log 開頭,要自己搬出來。 - 開頭那句「Do not write any code」是給 agent 的:
codex exec本質是 coding agent,不講清楚它可能會去寫一支畫圖程式。
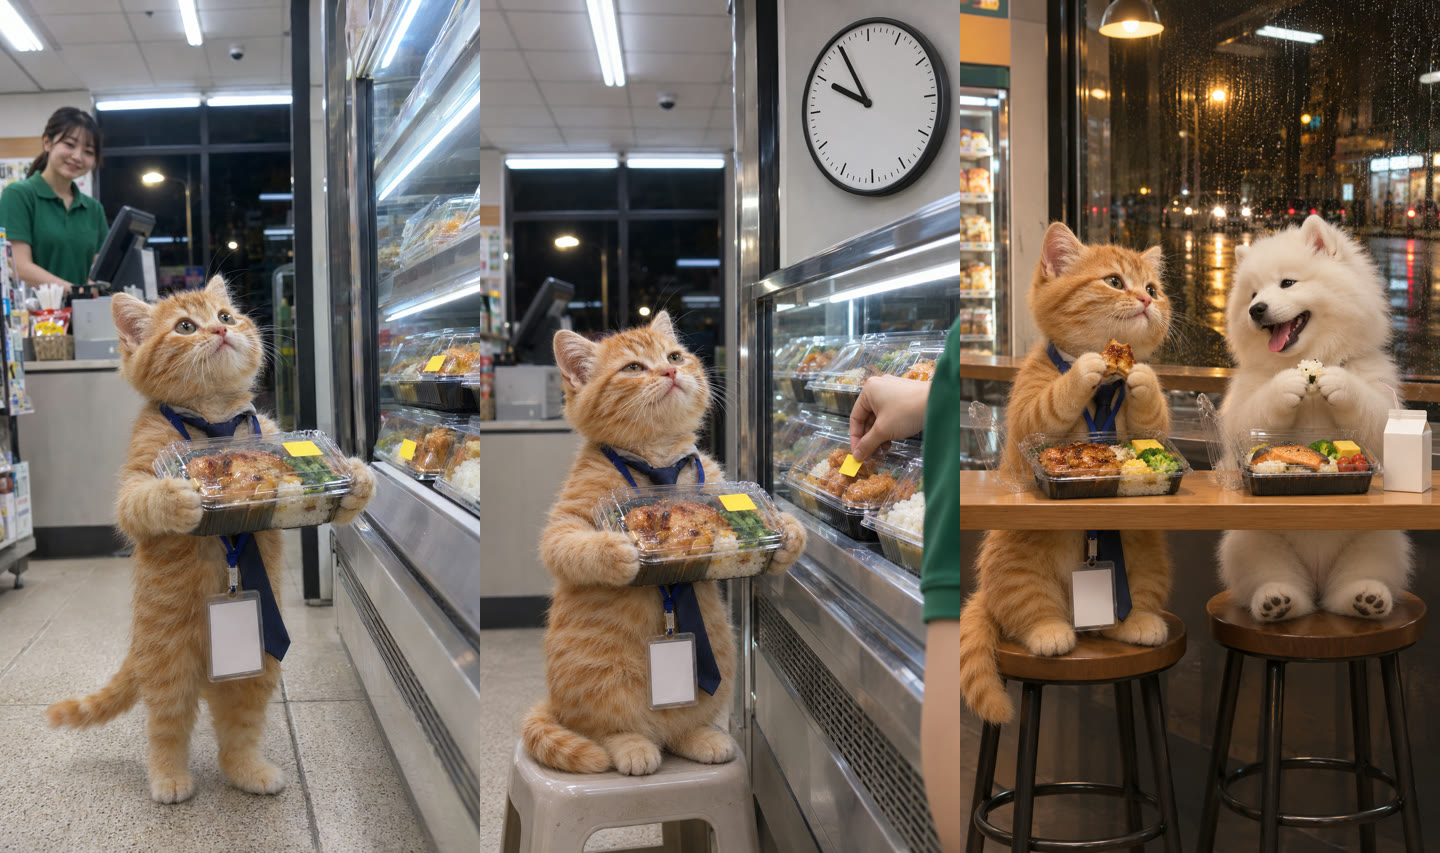
三鏡的毛色、藏青領帶、藍色掛繩和空白識別證都一致,場景的冷藏櫃、店員綠色 polo 衫也接得上。
不帶參考圖會差多少?
為了確認 -i 到底貢獻了什麼,我把第 2 鏡重生一次:拿掉 -i,改成把第 1 鏡的角色描述(橘色虎斑、藏青領帶、藍掛繩、空白識別證)整段寫進提示詞,其他場景描述不變。
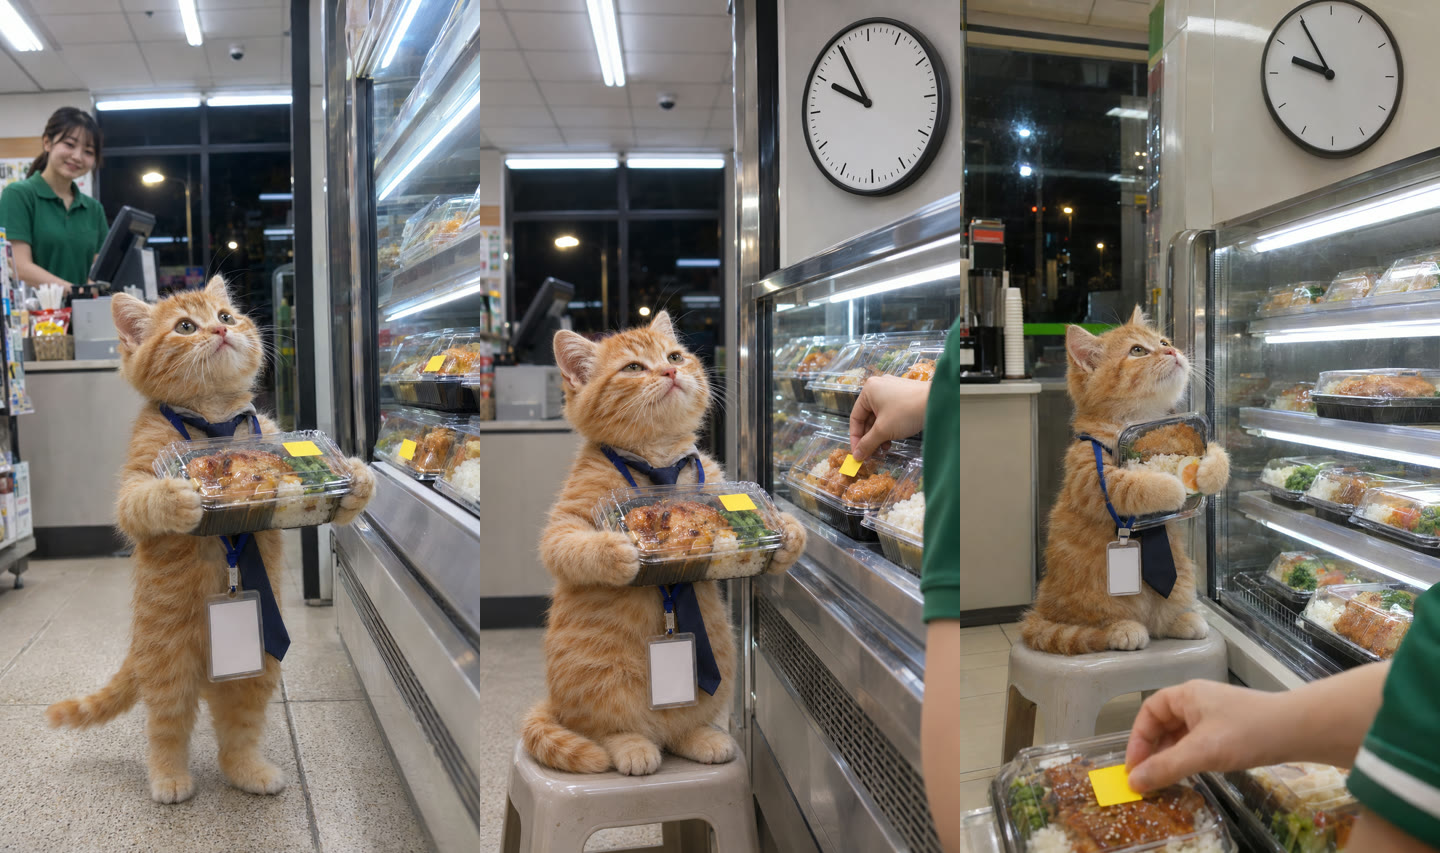
結果比我預期的接近:
| 項目 | 帶 -i 參考圖 | 只用文字描述 |
|---|---|---|
| 領帶、掛繩、識別證 | 一致 | 一致 |
| 毛色深淺、臉型 | 跟第 1 鏡同一隻 | 毛色偏淡、臉比較圓,看得出是另一隻貓 |
| 場景 | 同一間店:窗外街燈、收銀台、天花板監視器位置都接得上 | 換了一間店,冷藏櫃和窗戶的配置不同 |
| 便當 | 同一款雞腿便當 | 換了菜色,改成直立抱著 |
-i。
第三步:配音和字幕怎麼做?
對白寫成一個 TSV,一行一句:
a1	zh-TW-HsiaoYuNeural	+25Hz	+0%	這個……等一下也會打折嗎?
c1	zh-TW-HsiaoChenNeural	+0Hz	+5%	十點就打七折喔,你要等嗎?
c2	zh-TW-HsiaoChenNeural	+0Hz	+5%	好啦,先幫你貼。
a2	zh-TW-HsiaoYuNeural	+25Hz	+0%	今天的飯搭子,是你。
阿橘用 HsiaoYu 再把音高拉高 25Hz,聽起來比較小隻;店員用 HsiaoChen 加快 5%。用 bash 迴圈逐行產生:
mkdir -p tts
while IFS=$'\t' read id voice pitch rate text; do
  edge-tts -v "$voice" --pitch="$pitch" --rate="$rate" -t "$text" --write-media "tts/$id.mp3"
done < src/lines.tsv
四句長度是 4.03、3.41、2.52、3.14 秒,接下來 ffmpeg 的時間軸就照這四個數字排。字幕直接用同一份稿子,每句存成一個 txt 給 drawtext 讀,所以不用再跑語音辨識對時間。
第四步:ffmpeg 怎麼把三張圖變成 18 秒 Shorts?
整支片是一個 filter_complex 腳本。指令本身很短:
cp /c/Windows/Fonts/msjhbd.ttc src/font.ttc
ffmpeg -y -i img/k1.png -i img/k2.png -i img/k3.png \
  -i tts/a1.mp3 -i tts/c1.mp3 -i tts/c2.mp3 -i tts/a2.mp3 -i music/ambient.mp3 \
  -filter_complex_script src/fc.txt -map "[v]" -map "[a]" \
  -c:v libx264 -crf 20 -preset medium -c:a aac -b:a 160k -t 18 out.mp4
字型先複製到專案裡,是因為 Windows 路徑的 C: 冒號在 filter 語法裡要跳脫,放相對路徑最省事。
fc.txt 分成三塊。畫面用 zoompan 做慢推,d 是這一鏡的格數(24fps 下 192 格 = 8 秒):
[0:v]scale=1080:1920,zoompan=z='1+0.0006*on':x='iw/2-(iw/zoom/2)':y='ih/2-(ih/zoom/2)':d=192:s=1080x1920:fps=24,setsar=1[v1];
[1:v]scale=1080:1920,zoompan=z='1.12-0.0008*on':x='iw/2-(iw/zoom/2)':y='ih*0.25-(ih/zoom/4)':d=108:s=1080x1920:fps=24,setsar=1[v2];
[2:v]scale=1080:1920,zoompan=z='1+0.0005*on':x='iw/2-(iw/zoom/2)':y='ih/2-(ih/zoom/2)':d=132:s=1080x1920:fps=24,setsar=1[v3];
[v1][v2][v3]concat=n=3:v=1:a=0,format=yuv420p,
第 2 鏡反過來從 1.12 倍往外拉、焦點放在上方 1/4,觀眾會先看到時鐘。字幕是一串 drawtext,用 enable='between(t,開始,結束)' 控制出現時間:
drawtext=fontfile=src/font.ttc:textfile=sub/s1.txt:fontsize=56:fontcolor=white:borderw=5:bordercolor=black:x=(w-tw)/2:y=1560:enable='between(t,0.4,4.5)',聲音是四句對白各自 adelay 到出場時間,配樂壓到 0.18 倍音量、最後 2 秒淡出,再整體 loudnorm:
[3:a]adelay=400|400[a1];[4:a]adelay=4600|4600[a2];[5:a]adelay=8400|8400[a3];[6:a]adelay=13400|13400[a4];
[7:a]volume=0.18,afade=t=out:st=16:d=2[m];
[a1][a2][a3][a4][m]amix=inputs=5:normalize=0:duration=longest,atrim=0:18,loudnorm=I=-16[a]
amix 一定要加 normalize=0。預設會把每一路除以輸入數,五路混下去對白會變得很小聲。
圖片輸入不要加 -loop 1。我第一次渲染加了,zoompan 會把每一個輸入格都展開成 d 格,結果三鏡全部變成第 1 張。這種錯成片長度照樣對、ffprobe 也看不出來,我是抽格拼成格狀圖才發現的。
做出來長什麼樣?
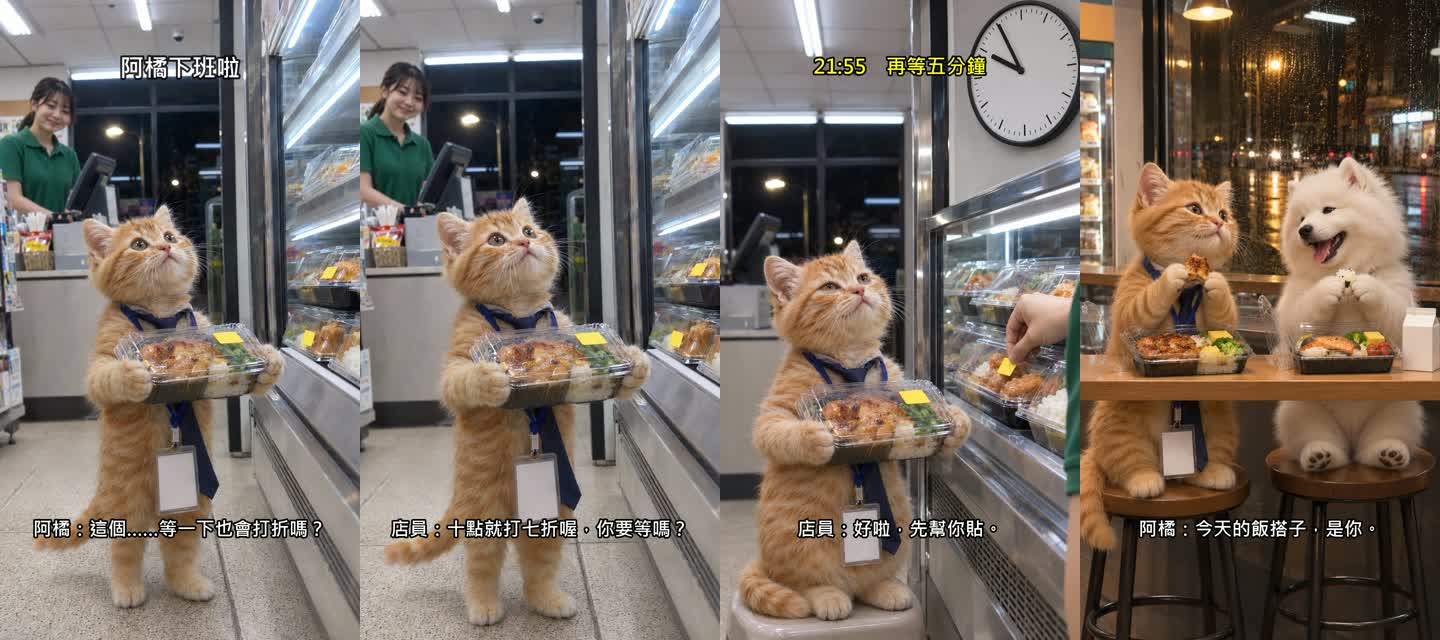
ffprobe 驗出來的規格:
stream|codec_name=h264|width=1080|height=1920|nb_frames=432
stream|codec_name=aac|nb_frames=1689
format|duration=18.000000
432 格 ÷ 24fps = 18 秒,三鏡依序出現,字幕時間也對得上。整合響度量出來是 −17.7 LUFS。
這個做法的限制和踩坑在哪?
- 貓不會動。 三張靜圖加推軌,比較像有聲繪本。原片的小狗會站、會轉頭,那要靠圖生影片模型(例如 Kling、Veo),本機目前沒有這一段。
- 道具連戲要寫進提示詞。 第 1 張我要求「冷藏櫃的便當貼著黃色打折貼紙」,模型連阿橘手上那盒也貼了。結果第 2 鏡店員才在貼貼紙,阿橘手上的便當早就有一張。要避免,就在第 1 鏡明寫「the bento box it holds has no sticker」。
- 一張一張生、要自己搬檔。 每張 2–3 分鐘,圖落在
generated_images而不是工作目錄,三鏡還好,十幾鏡就該寫腳本批次跑。 - 題材可以借,角色和台詞不要照搬。 原片的小狗、名字和字幕都是別人的,我只保留「打工人等打折」這個題材,角色、場景、台詞全部重寫。
下一步可以怎麼做?
這支 18 秒是驗證「寫實萌寵角色能不能在本機穩定生出來」,答案是能,而且 -i 參考圖就夠用。接下來兩件事:
- 把三張關鍵格丟進圖生影片模型,讓阿橘真的抱著便當走動。這一步才是寫實版和原片的差距。
- 把節拍表換成「下班日常」系列:想省錢、等、小確幸、飯搭子,換角色、換場景(雨夜、末班車、自助洗衣店),用同一套指令批次產生。
延伸資源
- FFmpeg Filters Documentation:本文用到的
zoompan、drawtext、adelay、amix、loudnorm參數說明 - edge-tts(GitHub):本文配音用的 TTS 工具
- Codex CLI 官方文件:安裝、登入與
codex exec用法 - openai/codex(GitHub):Codex CLI 原始碼與 release