懶人包
- antrofrog_ 在 2026-10-30 發到 X 的 47 秒 AI 手繪動畫《Englishman in New York》,2026-11-03 讀取時有 3,583 萬觀看、29.7 萬讚,配的是 Sting 的同名歌。
- 我用 ffmpeg 場景偵測拆片,全片 13 鏡、平均 3.58 秒一鏡;其中 7 鏡長度落在 4.04–4.09 秒,看起來是單次生成的片段整段直接用。
- 切點沒有對齊音樂:音軌估速約 103.4 BPM,切點換算成拍數是 6.96、13.92、19.67……,剪輯節奏跟著生成長度走,不是跟著小節走。
- 13 鏡都是同一個主角(黑長外套、黑傘、外帶咖啡)用傘做一件小善舉,固定造型只換場景,把 AI 影片最難的角色一致性壓到最小。
- 我把這套結構做成免費的分鏡規劃器,填歌長、BPM 和主角描述,就會切好鏡頭並產出每鏡的圖片提示詞與影片提示詞。
我在 Threads 上看到 AI 郵報(@aiposthub)轉貼這支片:「一支不到 1 分鐘的 AI 動畫,不到 24 小時突破千萬觀看」。我去讀了原始貼文,下載影片用 ffmpeg 一格一格拆,想回答一個很實際的問題:這種復古手繪風的 AI 動畫,結構上到底怎麼做出來的,我自己要做一支該從哪裡下手。
這篇不談「AI 會不會取代動畫師」,只談拆出來的數字和可以照抄的結構。
《Englishman in New York》這支 AI 動畫是什麼?
| 項目 | 內容 | 來源 |
|---|---|---|
| 作者 | antrofrog_,X 自介「an artist with zero skills so I just use AI」 | X 個人頁 |
| 發布 | 2026-10-30 10:41 UTC,內文只有片名 | 原始貼文 |
| 數據 | 35,834,371 觀看、296,870 讚、32,347 轉推(2026-11-03 讀取) | fxtwitter API |
| 規格 | 46.59 秒、1920×1080、24fps | 我用 ffprobe 讀原片 |
| 配樂 | Sting〈Englishman in New York〉 | 片名與音軌 |
工具的部分要老實講:網路上的二手整理說作者標註過角色用 Midjourney、動態用 Seedance、在 Krea 上做,但我沒有讀到作者本人的原文,所以下面的拆解只講從成片量得到的東西,不假設他用了哪個模型。
13 鏡分別在演什麼?
我逐鏡看中間幀整理成下表。每一鏡的主詞都一樣:主角、傘、一件小事。
| # | 時間 | 畫面 |
|---|---|---|
| 1 | 0.00–4.04 秒 | 主角拿咖啡走過麵包店,路人低頭滑手機、快踩進打開的人孔 |
| 2 | 4.04–8.08 秒 | 噴泉旁,傘尖把一枚硬幣推給難過的小女孩 |
| 3 | 8.08–11.42 秒 | 計程車旁,用傘勾住提公事包的上班族 |
| 4 | 11.42–14.71 秒 | 兩個攤開地圖的路人旁,主角用傘幫忙指路 |
| 5 | 14.71–17.83 秒 | 仰角,防火梯下,傘尖接住被風吹走的曬衣 |
| 6 | 17.83–21.88 秒 | 門階前,路人轉圈變成模糊殘影(含一次閃切) |
| 7 | 21.88–25.92 秒 | 店門掛著 CLOSED,主角站門邊,門外一排人在等 |
| 8 | 25.92–28.38 秒 | 人行道上,傘柄勾著一個倒栽在紙箱上的人 |
| 9 | 28.38–31.29 秒 | 仰角高樓間,用傘撐住踩高蹺的人 |
| 10 | 31.29–34.42 秒 | 地鐵入口,低機位只拍腳與傘 |
| 11 | 34.42–38.46 秒 | 籃球場鐵網外,傘頂著一團橘色物體,場內孩子在看 |
| 12 | 38.46–42.50 秒 | 雨後水果攤前,傘柄勾住一個滑倒騰空的路人 |
| 13 | 42.50–46.59 秒 | 收尾:紅地毯排隊入口,保鑣直接讓主角進門 |
怎麼量出鏡頭長度?ffmpeg 場景偵測實測
量切點用 ffmpeg 的 scene 分數,超過 0.25 就算換鏡:
ffmpeg -hide_banner -i englishman.mp4 \
  -vf "select='gt(scene,0.25)',showinfo" -an -f null - 2>&1 \
  | grep -o "pts_time:[0-9.]*"
我在本機跑出來的切點:
pts_time:4.041667 pts_time:8.083333 pts_time:11.416667 pts_time:14.708333
pts_time:17.833333 pts_time:21.541667 pts_time:21.875 pts_time:25.916667
pts_time:28.375 pts_time:31.291667 pts_time:34.416667 pts_time:38.458333
pts_time:42.5
13 個切點裡,21.54 和 21.88 只差 0.33 秒,對照畫面是同一鏡裡的一次閃切,合併後全片是 13 鏡。
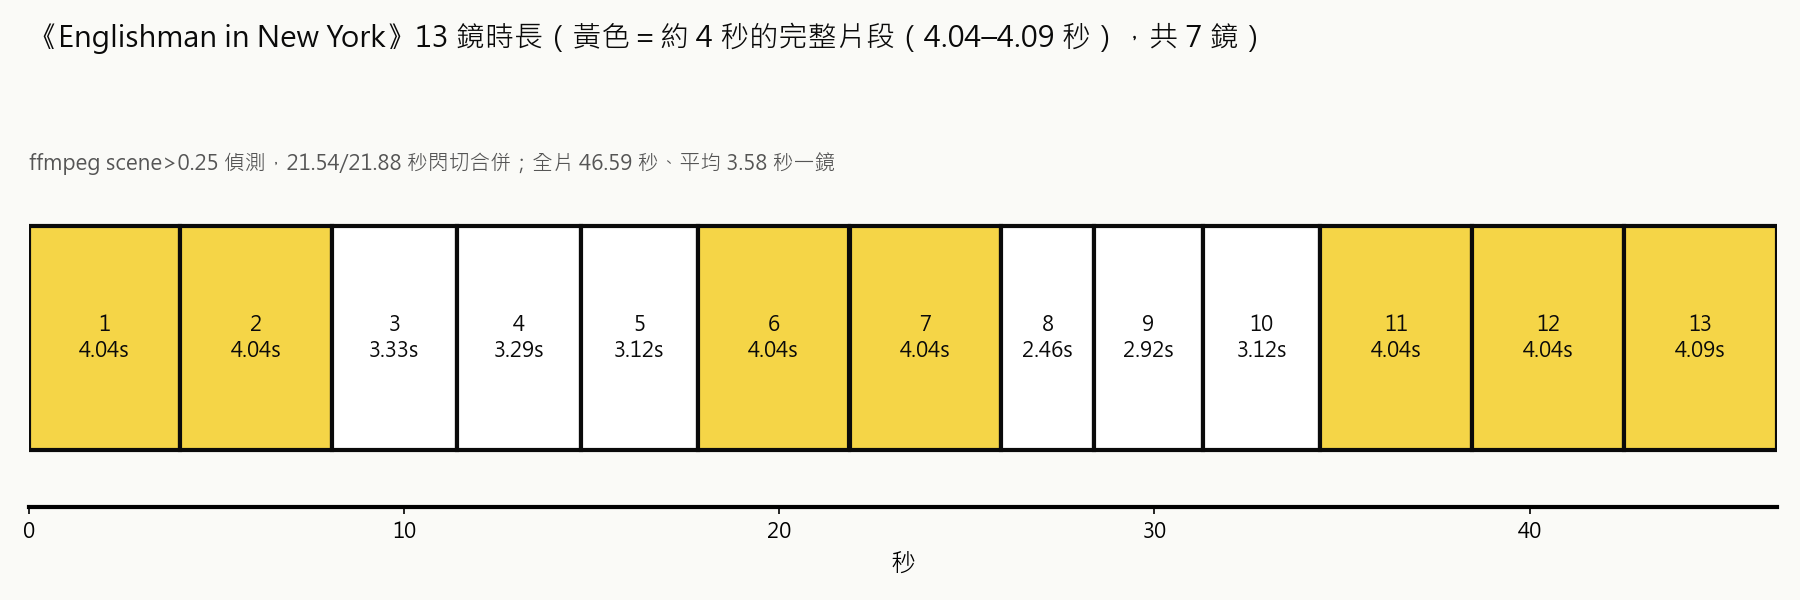
最醒目的是 4.04 秒反覆出現:第 1、2、6、7、11、12 鏡都是 4.04 秒(24fps 下 97 格),最後一鏡 4.09 秒。剩下 6 鏡在 2.46 到 3.33 秒之間。
我的解讀是:約 4 秒是單次生成的片段長度,表現好的鏡頭整段照用,動作有瑕疵或節奏拖的才剪短。這是從數字推出來的,作者沒有公開剪輯流程。
切點有對齊音樂嗎?
沒有。我寫了一支 20 行的 Python,用頻譜通量(spectral flux)的自相關估音軌速度,再把每個切點換算成「從 0 秒算起第幾拍」:
python tempo.py audio.wav cuts.txttempo_bpm 103.4
beat_sec 0.58
4.04 beats_from_0= 6.96後續切點換算是 13.92、19.67、25.34 拍,沒有落在 4 拍一小節的整數倍上。這個估速法對有鼓點的歌比較準,Sting 這首節奏清楚,103 BPM 的量級可信,但不要把小數點後面當精確值。
結論是這支片的剪輯節奏由「生成長度」決定。對要自己做的人來說這是好消息:不必為了卡拍去反覆重生成,畫面好比對拍重要。
為什麼主角十三鏡都長得一樣?
AI 影片最麻煩的是同一個角色在不同鏡頭裡臉、衣服、髮型會漂。這支片的處理方式是把角色設計成很容易被模型穩定複製的樣子:
- 剪影優先:瘦長身形、黑色長外套、蓬亂黑髮,遠景只看輪廓也認得出來。
- 配色單純:黑外套、白襯衫、細黑領帶,沒有花紋或小配件會漂。
- 固定道具:黑傘和外帶咖啡每鏡都在,道具本身就是角色辨識的一部分。
- 一鏡一事件:每鏡只要求模型做一個動作(勾、接、撐、推),4 秒內做得完。
這套限制也帶來代價。Creative Bloq 報導過作者同系列作品的爭議,批評集中在角色設計眼熟、主角和背景路人畫風混搭,以及 AI 動畫的著作權與工作機會問題。拿這個結構做自己的作品時,主角請自己設計,不要拿既有動畫角色的輪廓去套。
我要做一支類似的 AI 手繪動畫,從哪裡開始?
我把上面的結構做成單檔網頁:一個主角、一把傘、十三個小善舉——分鏡規劃器。不用登入,原始碼就是一個 13 KB 的 HTML。
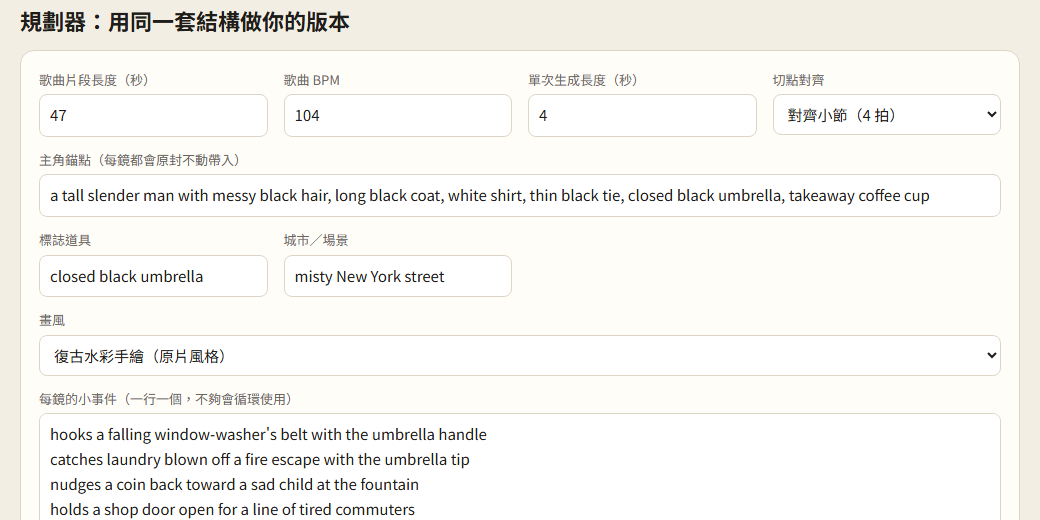
輸入的欄位對應上面拆出來的四個變數:
- 歌曲片段長度、BPM:決定總鏡數。
- 單次生成長度:預設 4 秒,對應原片的 4.04 秒。
- 切點對齊:不對齊、對齊單拍、對齊小節三選一。原片是不對齊,想做 MV 感可以選小節。
- 主角錨點與標誌道具:這段文字會原封不動帶進每一鏡的提示詞,等於把「固定造型」寫死。
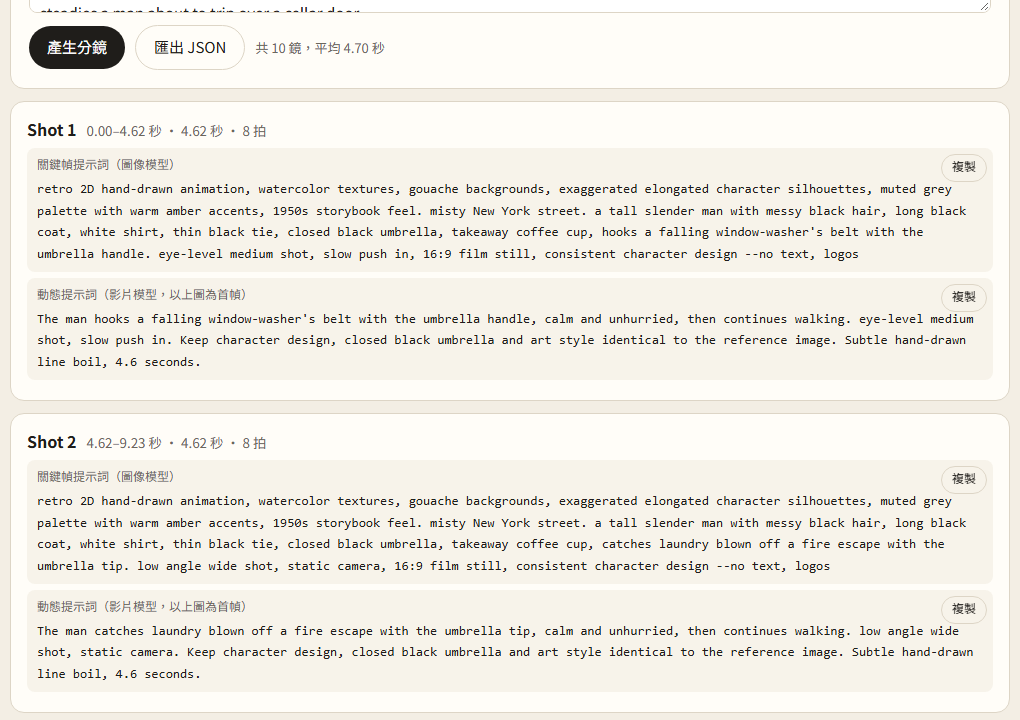
我用 Playwright 測過三種對齊模式(47 秒、104 BPM):
| 對齊模式 | 鏡數 | 平均鏡長 |
|---|---|---|
| 對齊小節 | 10 | 4.70 秒(首鏡 0–4.62 秒=8 拍) |
| 對齊單拍 | 12 | 3.92 秒 |
| 不對齊 | 12 | 3.92 秒 |
規劃器只產生提示詞,不會幫你生圖或生影片。實際流程是:
- 先用關鍵幀提示詞生一張主角定裝圖,挑到滿意的那張。
- 後面每一鏡都帶著這張定裝圖當參考圖生關鍵幀。
- 關鍵幀丟進圖生影片模型,用動態提示詞生約 4 秒的片段。
- 照規劃器的時間軸剪接,好的鏡頭整段用,有瑕疵的剪短。
這套結構的限制在哪?
- 敘事很薄:13 鏡是 13 個獨立笑點,靠歌撐情緒。要講有起承轉合的故事,這個公式不夠。
- 歌曲版權:原片用的是 Sting 的商業錄音。自己發布時配樂要用有授權的音樂,不然平台可能靜音或下架。
- 紅不紅不是結構決定的:我能量出的是鏡長、切點和角色設計,量不出演算法推送和時間點。照抄結構能做出工整的片,不保證有同樣的觀看數。
- 拆解只有一支片:4 秒片段直接用、切點不對拍,是這一支片的觀察,不代表作者其他作品或所有 AI 動畫都這樣做。