懶人包
- IG 帳號 pinkear.dada(小粉耳嗒嗒)在 2026-10-29 發的 AI 短片〈小粉耳嗒嗒送外賣〉,到 11-04 有 14.2 萬讚、225 則留言。
- 我把影片抓下來用 ffmpeg 切鏡:72.9 秒剪了 37 鏡,中位數 1.83 秒一鏡,最長的鏡頭也只有 4 秒。
- 劇情是七段節拍:價格鉤子、百杯大單、無對白的製作蒙太奇、兩次被擋、騎巨型倉鼠反轉、多送一顆草莓收尾。
- 主角兔子全片不開口,對白全由客人、外送員、警察、保安說,它只在最後一格有一行內心字卡。
- 我把這套節拍做成網頁版分鏡產生器:選動物、材質、職業,產出 12 鏡 48 秒的提示詞和 SRT 字幕,再用 ffmpeg 組成 1080×1920 的 animatic 樣片。真的 AI 畫面這次還沒生成。
這篇拆一支 AI 萌寵微短劇的結構,再把結構變成可以重複用的工具。工具已經上線:萌寵打工微短劇分鏡產生器,不用登入、不呼叫 API,打開就能用。
〈小粉耳送外賣〉在演什麼?
原始貼文是 IG 帳號 pinkear.dada 的 Reel,文案只有一行「VLOG|小粉耳嗒嗒送外賣 #vlog #ai #療癒 #治癒」。我在 2026-11-04 讀到的數字是 142K likes、225 comments。
主角是一隻白色垂耳兔,材質看起來像羊毛氈。它在辦公大樓前擺攤賣酸奶,招牌寫「1.0元一杯」。場景是寫實的城市街景、真實光影、真人路人,只有兔子是毛氈質感。
故事線很短:
- 西裝大叔嫌「這麼小一杯十塊?」,吃了一口才發現自己看錯,是一塊錢,跟兔子道歉。
- 大叔訂一百杯,遞了張紙條:下午三點送到這裡。
- 兔子掛上「暫停營業」,擠酸奶、擺草莓、裝進粉紅保冷袋。這段沒有對白。
- 黃衣外送員想順手拿一杯,被警察攔下:「上周就有人報你順手拿攤位的東西」。
- 兔子騎粉紅三輪車上路,被保安攔下:「小家伙」「先停下」。
- 兔子坐在長椅邊垂著耳朵,接著騎上一隻巨型倉鼠,把保冷袋送進大樓。
- 大叔打開保冷袋:「怎麼每杯都多送了一顆草莓」。最後一格是兔子特寫,字卡寫「多一顆才夠甜呀」。
72 秒剪了幾個鏡頭?
IG 擋掉了沒登入的 yt-dlp。我改從貼文的 embed 頁解析出 mp4 直鏈下載,檔案是 960×720、72.9 秒、有 AAC 音軌。下載後用 ffmpeg 的場景偵測找切點:
ffmpeg -i reel.mp4 -vf "select='gt(scene,0.3)',showinfo" -f null - 2>&1 \
  | grep -o 'pts_time:[0-9.]*' | cut -d: -f2 > cuts.txt
cuts.txt 有 36 個切點,也就是 37 個鏡頭。我把每鏡長度畫成長條圖,底色標出七段節拍:
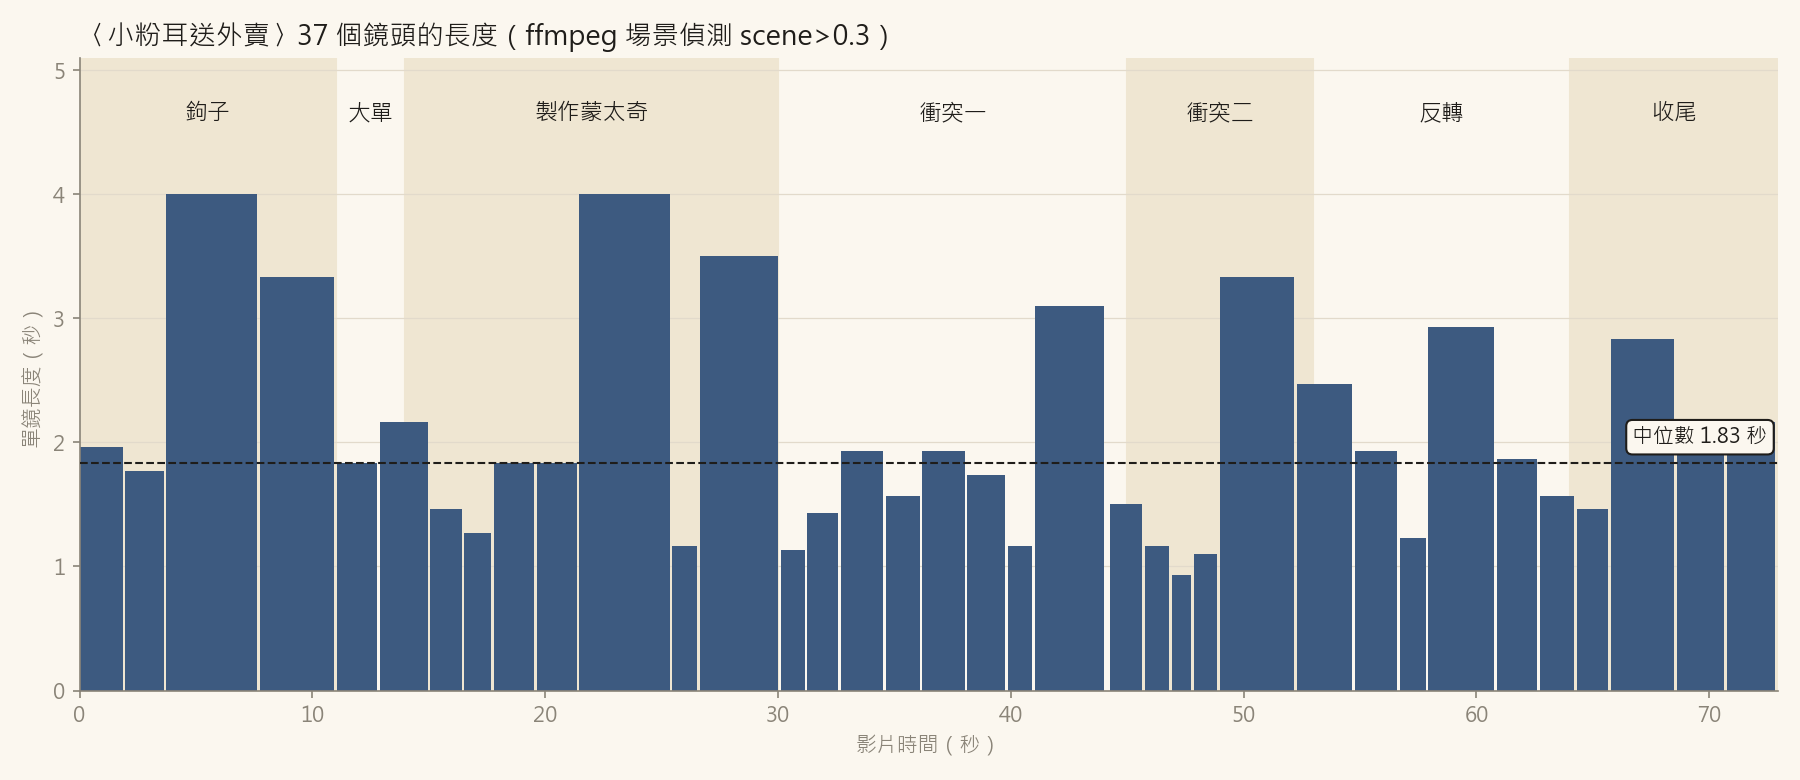
| 指標 | 數值 |
|---|---|
| 總長 | 72.9 秒 |
| 鏡頭數 | 37 |
| 平均單鏡 | 1.97 秒 |
| 中位數 | 1.83 秒 |
| 最長 | 4.0 秒(2 鏡) |
| 2.5 秒以內的鏡頭 | 29 鏡 |
場景偵測的門檻會影響切點數量。0.3 是我用的值,換成 0.4 可能少抓幾個溶接或快速搖鏡,所以 37 這個數字是「門檻 0.3 下的結果」,不是剪輯師的原始剪輯表。
為什麼兔子一句話都不說?
我用 faster-whisper small 模型跑了一次語音辨識,拿到 19 段簡體中文對白,再對照畫面上的燒入字幕。說話的人是大叔、外送員、警察和保安。兔子沒有任何一句台詞,唯一屬於它的文字是最後那行內心字卡。
這個安排有兩個實際好處。AI 影片要讓一個毛絨角色對嘴講話,嘴型很難做得自然;主角不開口,這個問題直接消失。觀眾也只能從耳朵、眼神、抱緊袋子的動作讀它的情緒,角色更像一個努力打工的小生命。
路人的對白則負責推劇情:價格誤會、下單、想白拿、被攔。台詞都很短,每句一到兩秒,剛好配上一兩個鏡頭。
七段節拍各自做什麼?
我把劇情按功能切成七段,時間是從畫面和切點對出來的近似值:
| 節拍 | 時間 | 在做什麼 |
|---|---|---|
| 鉤子 | 0–11 秒 | 價格誤會,寫實大叔對比毛氈兔子 |
| 大單 | 11–14 秒 | 一百杯、下午三點,給主角一個任務和期限 |
| 製作蒙太奇 | 14–30 秒 | 無對白的手作過程,擠酸奶、放草莓、裝袋 |
| 衝突一 | 30–45 秒 | 有人想白拿,警察出面 |
| 衝突二 | 45–53 秒 | 規則擋路,保安攔下三輪車 |
| 反轉 | 53–64 秒 | 垂頭喪氣後騎巨型倉鼠出發 |
| 收尾 | 64–73 秒 | 每杯多一顆草莓,內心字卡 |
收尾那顆多送的草莓,在製作蒙太奇裡就拍過了。觀眾看兔子一杯一杯放草莓時不知道它多放了,到大叔開袋才知道。這是整支片唯一的伏筆。
怎麼把這套節拍變成分鏡產生器?
我做了一個單檔網頁,把七段節拍寫成模板,換掉角色和職業就能產出一份新劇本。輸入五個欄位:
- 角色中文名、英文名
- 動物(英文,給提示詞用)
- 材質:羊毛氈、絨毛玩偶、黏土
- 職業:豆花攤、便當外送、咖啡車
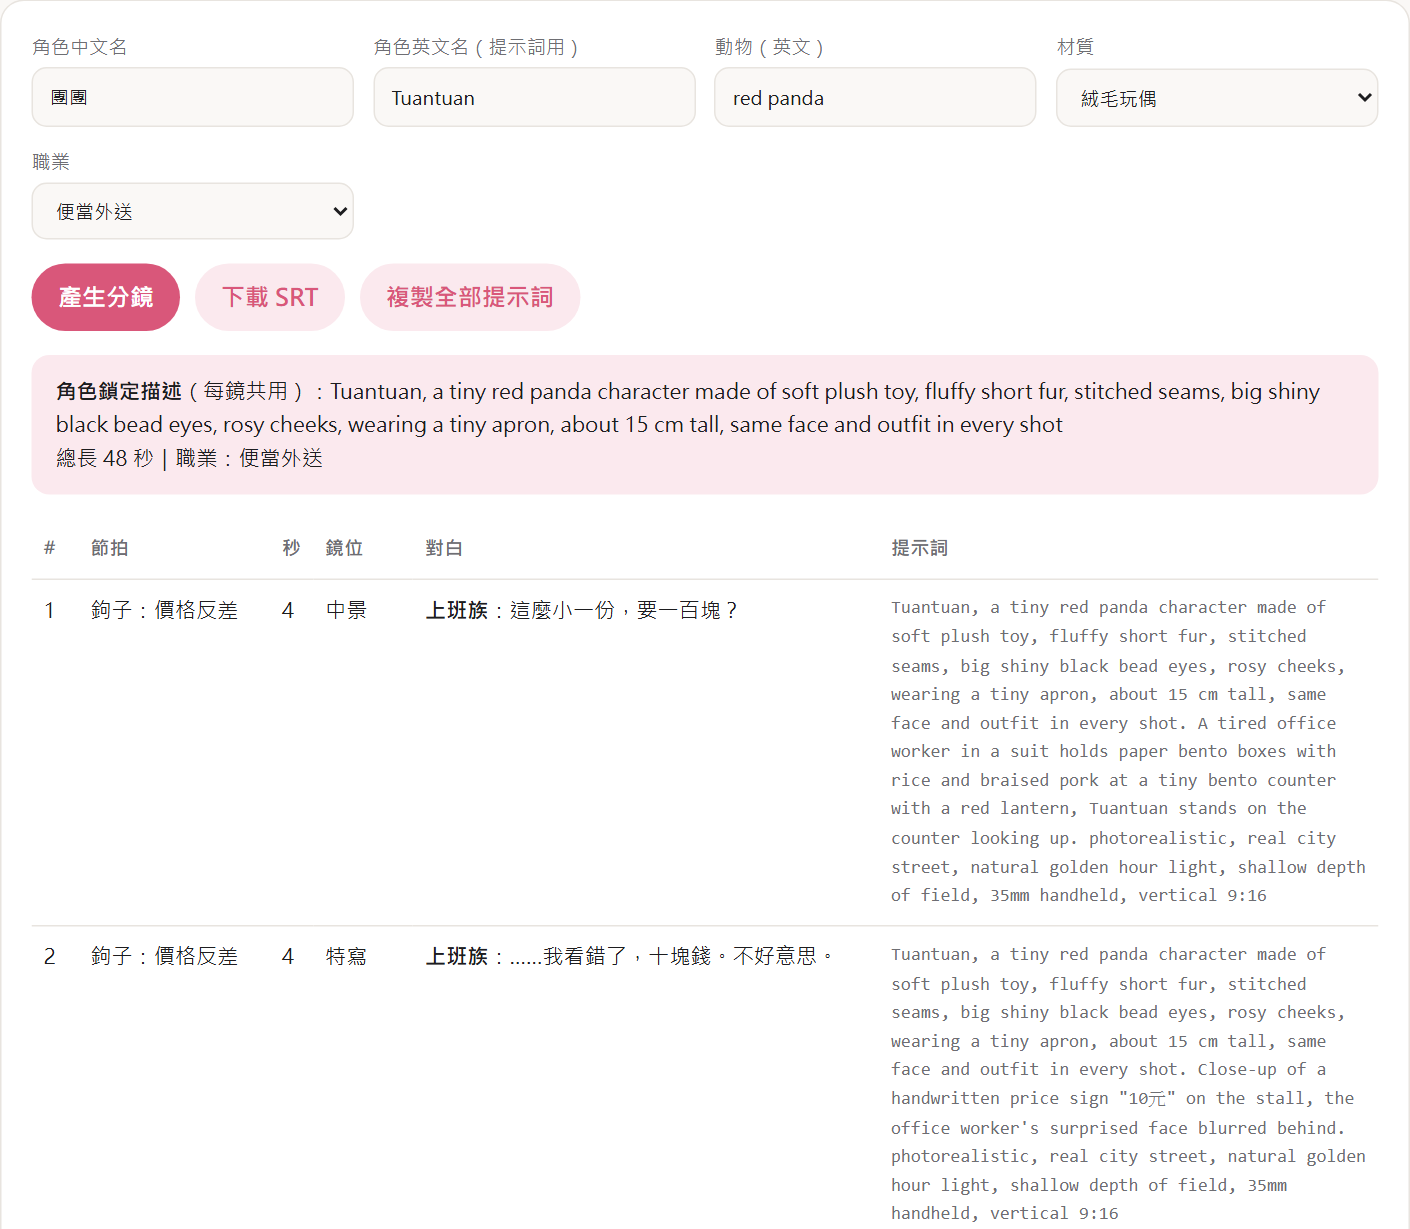
原片 37 鏡,產生器只出 12 鏡、總長 48 秒。理由是圖生影片工具一次生一段,鏡頭數越多,要生成、挑選的段數就越多。12 鏡把七段節拍都保留下來,鉤子 2 鏡、大單 1 鏡、製作蒙太奇 3 鏡、衝突一 2 鏡、衝突二 1 鏡、反轉 1 鏡、收尾 2 鏡。真的要剪成原片那種 2 秒一鏡的節奏,可以把一段生成的影片切成兩三個鏡頭用。
每一鏡的提示詞開頭都是同一段「角色鎖定描述」,這是產生器最核心的一段:
function characterLock(c) {
  const m = MATERIALS[c.material] || MATERIALS.felt;
  return `${c.nameEn}, a tiny ${c.animalEn} character made of ${m.en}, ${c.lookEn}, about 15 cm tall, same face and outfit in every shot`;
}
跨鏡頭維持同一個角色,是 AI 連續短片最難的部分。Kling 官方在 2026-10-16 的文章〈AI Videos That Went Viral〉講系列 vlog 時,建議保留參考圖,讓角色在後續集數維持可辨識。文字鎖定描述是第一層,實際生成時還要搭配同一張角色設定圖當參考。
我寫了一支 Node 測試,確認三個職業都產出 12 鏡、總長在 45 到 60 秒之間、每段提示詞都帶鎖定描述:
node test_storyboard.js[ok] douhua: 12 shots, 48s, srt cues 8
[ok] bento: 12 shots, 48s, srt cues 8
[ok] coffee: 12 shots, 48s, srt cues 8
[ok] invalid job rejectedSRT 只有 8 條字幕,因為 12 鏡裡有 4 鏡是無對白的蒙太奇和反轉,這跟原片的安排一致。
animatic 樣片怎麼組?
沒有 AI 畫面之前,我先用 ffmpeg 把鏡頭表做成色卡版的動態分鏡。每鏡一張色卡,上面寫鏡號、鏡位和節拍,時間照鏡頭表排,最後燒進產生器輸出的 SRT:
ffmpeg -f lavfi -i "color=c=white:s=1080x1920:d=48:r=24" \
  -vf "drawbox=...:enable='between(t,0,4)',drawtext=...,subtitles=sample_douhua.srt" \
  -c:v libx264 -pix_fmt yuv420p animatic_douhua.mp4
上面的 ... 是每一鏡重複的 drawbox 和 drawtext 參數,實際濾鏡串是用 Node 依鏡頭表產生的。成品 ffprobe 讀到 48.0 秒、1080×1920:
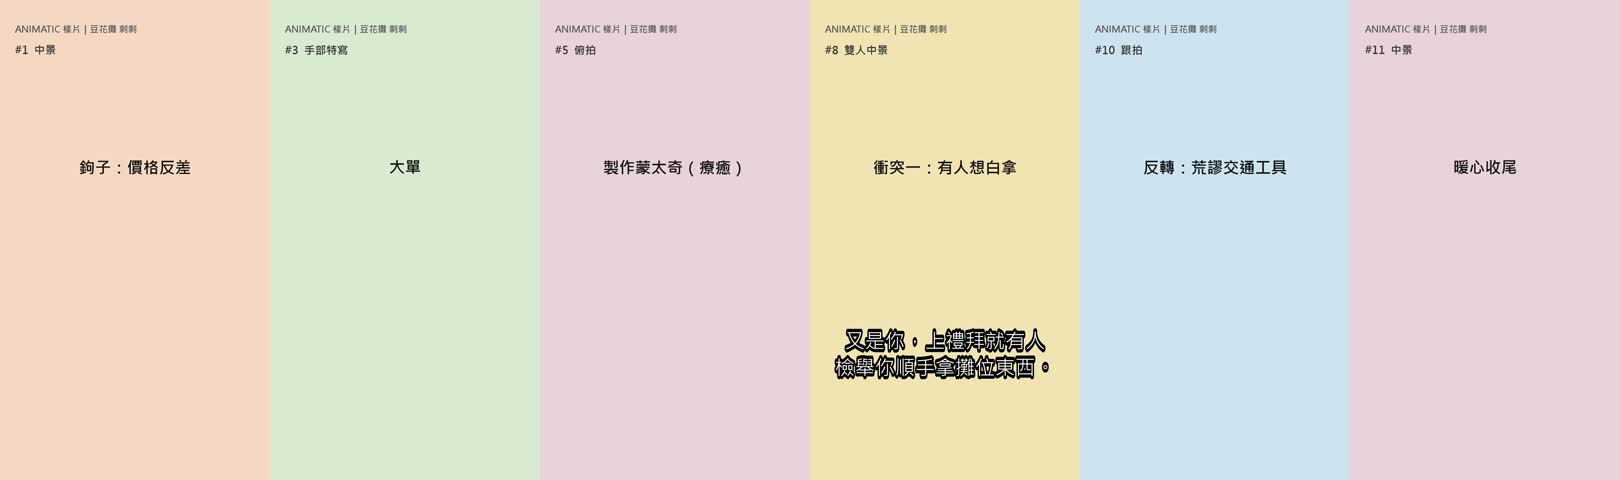
這支 animatic 的用途是先檢查節奏和字幕長度。等每一鏡有了生成好的影片,把色卡換成影片片段,同一條 ffmpeg 管線可以直接燒字幕輸出。
我還沒做到的部分
這次沒有生成任何真的 AI 畫面。Codex 的生圖額度當天用完,手上的 OpenAI 和 Gemini API 金鑰也都回報無效,所以產生器的提示詞還沒有實際丟進可靈、即夢或 Veo 驗證。下面幾件事要等真的生成才知道:
- 角色鎖定描述加上參考圖,能不能讓毛氈材質在 12 鏡裡保持一致。
- 「寫實城市+毛氈角色」的提示詞,生成工具會不會把背景也做成毛氈風。
- 產生器第 2 鏡要求畫面裡出現「10元」價格牌,生成工具畫中文字常出錯,這鏡可能要改成後製加字。
同樣「拆一支爆款短片、做成分鏡工具」的做法,我之前做過神獸題材:AI 神獸短片怎麼做:拆解 9.5 萬讚〈開明獸〉Reel。想看關鍵幀加圖生影片的實際流程,可以看 AI 賽博龐克 Reel 的 Seedance 關鍵幀工作流。
下一步可以怎麼做?
- 打開分鏡產生器,選一個你自己的角色和職業,按「產生分鏡」。
- 用角色鎖定描述先生一張角色設定圖(正面、側面、背面)。
- 每一鏡用「設定圖+該鏡提示詞」去生影片,只留最好的 2 到 4 秒。
- 路人對白用 TTS 或真人錄音,主角保持不說話。
- 照鏡頭表順序剪,按「下載 SRT」把字幕燒進去。