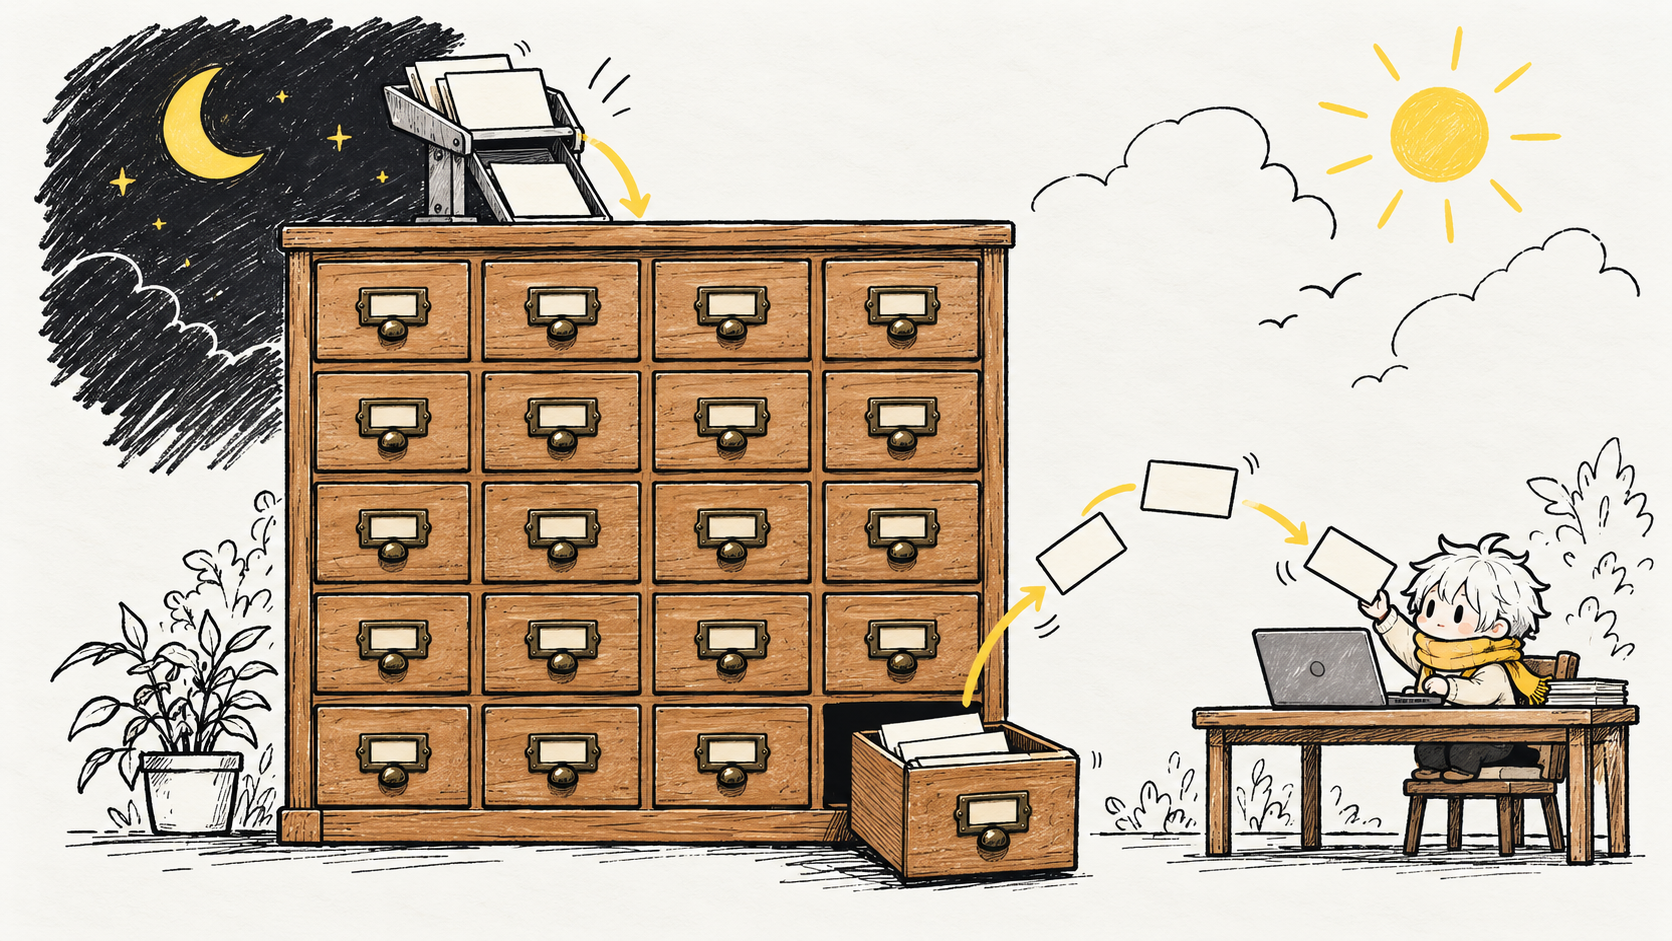
我的個人知識庫是一個 Obsidian vault,裡面放了 258 張 markdown 卡片,寫的人是 Claude Code。它有兩條路:寫入由 session 結束時的 hook 排隊,每晚交給 claude -p 整理成卡片;讀出由每次提問時的 hook 用 BM25 比對卡片,把最相關的幾張路徑塞進 Claude 的 context。兩條路都是 Claude Code 官方的 hook 機制加上兩支 bash 腳本,不需要另外架伺服器。
這篇先整理個人知識庫有哪幾種公開的做法,再講我這套怎麼蓋、數字長什麼樣、還有哪些地方沒做好。
個人知識庫有哪幾種做法?
我參考的是四份公開的來源,它們各自回答的問題不一樣,可以疊著用:
| 做法 | 來源 | 核心概念 | 誰負責整理 |
|---|---|---|---|
| Building a Second Brain | Tiago Forte(Forte Labs) | CODE 四步驟:Capture、Organize、Distill、Express;用 PARA 分類:Projects、Areas、Resources、Archive | 人 |
| LLM Wiki | Andrej Karpathy 的 gist(2026-04-04) | 三層:raw sources(不可改的原始資料)、wiki(LLM 寫、LLM 維護的 markdown)、schema(CLAUDE.md 這類規則檔);三個操作:ingest、query、lint | LLM |
| RAG | 向量資料庫類工具 | 把文件切塊、轉成向量,提問時用語意相似度撈回片段 | 程式(不整理,只索引) |
| CLAUDE.md + auto memory | Claude Code 官方文件 | CLAUDE.md 由人寫規則;auto memory 由 Claude 自己記,MEMORY.md 每次開場載入前 200 行或 25KB | 人+Claude |
我的做法偏向 LLM Wiki:原始資料是每場 Claude Code 對話,wiki 是 Claude 整理出的卡片,schema 是寫在 CLAUDE.md 裡的寫卡規則。另外多補了一條「讀出」的自動化,下面會講為什麼需要它。
我的知識庫長什麼樣?
vault 的位置是 ~/.claude/memory/,用 Obsidian 開就是一個普通的筆記庫。目前的分布:
| 資料夾 | 卡片數 | 放什麼 |
|---|---|---|
feedback/ | 130 | 我給 Claude 的行為規範與糾正 |
reference/ | 52 | 外部系統、部署流程與工具設定 |
projects/ | 47 | 各專案的進行狀態與決策 |
debugging/ | 21 | 踩過的坑與排查步驟 |
| 其他(moc、teaching、user、meta) | 8 | 索引頁與少量分類 |
| 根目錄 | 0 | 只放索引 MEMORY.md |
name 和 description 是給檢索用的摘要,正文才是細節。
整套怎麼運作?條列總覽
先用條列把整套講完,後面的段落再逐一拆細節。
存放
- 本體是
~/.claude/memory/,一個 Obsidian vault,一張卡一個.md檔,目前 258 張。 - 卡片依類型放進子資料夾:
projects/、feedback/、reference/、debugging/、user/、teaching/,moc/放總覽頁(知識總覽、專案總覽、時間軸),meta/放這個 vault 自己的說明。 - 根目錄只放索引
MEMORY.md,每張卡一行。 - 每張卡有 frontmatter(name、description、type、tags),結尾有「## 相關」區塊用
[[卡名]]連到別張卡,卡片之間是網狀的。 - 同一件事只有一張主卡。衍生出來的卡標成
type: subproject加parent:,或標成已併入,卡上放一條連回主卡的提示,不直接刪掉。
- UserPromptSubmit hook
vault-recall.sh用 BM25 比對所有卡片,把最相關幾張的路徑和摘要注入 Claude 的 context。 - 不會整個 vault 載入,只帶相關的卡,卡片變多也不會撐爆 context。
- Claude 看到相關卡片後,會先 Read 全文再回答。
- Stop hook
obsidian-sync.sh判斷這場對話有沒有值得記的內容,有就排進佇列.queue/pending.jsonl,濃縮文字放在.inbox/。 - 每晚
vault-nightly.sh用claude -p消化佇列:能擴充舊卡就不開新卡,新卡一律放進正確的子資料夾、補上 tags 和「## 相關」。 - 還沒消化的佇列,下次開 session 時會由 hook 提醒。對話中也可以直接叫 Claude 寫卡。
sync.sh把~/.claude/同步到兩個私有 GitHub repo:一個放 skills、scripts、rules 這類設定,一個放 memory 和 settings。- 預設是雙向:本機變更先推上 repo,用 git 合併其他機器的變更,再寫回本機。
- 一次要刪超過 30 個檔就中止,必須加
--force才會執行,避免誤刪。 - 根目錄若出現跟子資料夾同名的舊卡,同步時直接略過,不推上 repo。
vault-lint.sh檢查缺 frontmatter、缺 tags、檔名重複、孤島卡(沒有任何連結),這四項一律要修。- 指向還沒建立的卡的連結是預期狀態,代表「這件事值得之後寫一張」;章節太長只是建議拆分。
寫入:對話結束時排隊,每晚整理成卡片
Stop hook 決定這場對話要不要排隊
Claude Code 每回合結束會觸發 Stop hook。我的 obsidian-sync.sh 讀這場對話的 transcript,條件只有兩個:
- 我實際提問至少 2 輪
- Claude 的文字回覆累積至少 60 個字元
~/.claude/memory/.queue/pending.jsonl,同時把整場對話濃縮成純文字存到 .inbox/<session_id>.txt。存濃縮檔的原因是我有兩台電腦共用同一個 vault,佇列記的 transcript 路徑在另一台機器上不存在,濃縮文字放在 .inbox/ 會跟著 vault 一起同步,負責整理的那台機器就能直接讀。
這個 hook 不擋 Claude 收尾,也不在當下寫卡。session 結束的那一刻通常是最趕的時候,我讓它只做排隊,寫卡留給晚上。
每晚排程用 claude -p 判斷要不要寫卡
vault-nightly.sh 由排程器每晚執行,分四個階段:
- 消化佇列:每一筆濃縮文字交給
claude -p,依寫卡規則判斷。vault 裡已經有同主題的卡就補充進去,沒有才開新卡,判斷不出值得長期保存就 SKIP。 - 大整理:跑
vault-lint.sh檢查格式,重算索引頁的統計數字。 - 快照:有 git repo 的機器做一次 commit;沒有的機器跳過,跨機同步另外走 rsync。
- 寄日報:把當天寫了哪幾張卡、佇列剩多少寄到我的 Gmail。
claude -p 是 Claude Code 的非互動模式,用的是訂閱額度。額度用完時腳本會換第二個帳號重試同一筆,帳號清單寫在腳本開頭。
從 2026-09-07 到 10-19 的日報信一共 51 封,合計寫入 142 張卡。每晚寫入數量不平均:
| 期間 | 每晚寫入 | 說明 |
|---|---|---|
| 09/07–09/09 | 0–4 張,多數是 0 | 排程器給的 PATH 找不到 timeout、python3,每筆都失敗 |
| 09/16 | 17 張 | PATH 修好後一次消化累積的佇列 |
| 09/22–10/18 | 多數 1–7 張 | 穩定期,10/16 有 11 張 |
| 10/19 | 0 張 | 4 筆都回 You've hit your weekly limit,之後加了換帳號重試 |
排程器的 PATH 這件事值得多講一句:macOS 的 launchd 和 Windows 工作排程器給的 PATH 都比互動 shell 少很多,手動跑一切正常、排程跑就整輪失敗。Windows 還有一個同名陷阱,C:\Windows\System32\timeout.exe 是「等待 N 秒」,跟 GNU coreutils 的 timeout(限時執行指令)語意完全不同。我現在讓腳本一啟動就檢查 timeout --help 有沒有 --kill-after,沒有就直接停。
讀出:每次提問用 BM25 撈相關卡片
為什麼需要另外一條「讀出」
寫進去的卡片,Claude 不一定會讀。Claude Code 官方文件對 auto memory 的說明是:
The first 200 lines of MEMORY.md, or the first 25KB, whichever comes first, are loaded at the start of every conversation.
我的 vault 索引 MEMORY.md 有 465 行,而且這個 vault 不是 Claude Code 預設的 auto memory 目錄,本來就不會自動載入。卡片本體則是需要時才讀。所以如果沒有東西提醒 Claude「這題 vault 裡有一張相關的卡」,它多半不會想到去翻。
UserPromptSubmit hook 把相關卡片放進 context
Claude Code 的 hooks 文件 寫明,UserPromptSubmit 是少數會把 stdout 當成 context 的事件:
The exceptions areUserPromptSubmit,UserPromptExpansion,SessionStart, andPostModelSwitch, where Claude Code adds plain-text stdout as context that Claude can see and act on.
所以 vault-recall.sh 只要把找到的卡片印到 stdout,Claude 在回答這一題之前就會看到。在 ~/.claude/settings.json 註冊的方式是:
{
  "hooks": {
    "UserPromptSubmit": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "bash \"$HOME/.claude/scripts/hooks/vault-recall.sh\"",
            "timeout": 10
          }
        ]
      }
    ]
  }
}
比對方式:BM25 加上中文 bigram
我選 BM25 是因為它不需要 embedding 模型、不需要常駐服務,Python 標準函式庫就寫得出來。幾個關鍵設計:
- 斷詞:英數字整個字當一個詞;中文切成相鄰兩字一組(bigram),例如「向量索引」切成「向量」「量索」「索引」。不用斷詞套件。
- 兩個欄位:正文用 BM25 算詞頻分數;frontmatter 的
name、description、tags加上檔名和標題算標題欄,提問詞只要出現在標題欄就加 3 分(不看次數),再和正文分數一起乘上該詞的 IDF。正文單一詞的 BM25 分數最高約 2.2,所以命中標題欄比正文出現很多次更有份量。 - 門檻:分數低於 15 不注入;只保留分數至少是第一名一半的卡片;至少要命中 2 個不同的提問詞;最多 5 張。
- 只給路徑和摘要:不把卡片全文塞進 context,Claude 判斷相關才自己去讀。
def tokens(text):
    text = text.lower()
    out = [w for w in re.findall(r"[a-z0-9][a-z0-9_\-\.]*[a-z0-9]", text)
           if w not in ASCII_STOP]
    for run in re.findall(f"[{CJK}]+", text):
        out.extend(run[i:i + 2] for i in range(len(run) - 1))
    return out
實際跑起來的樣子
下面是今天直接餵三個問題給這支 hook 的輸出,路徑開頭的使用者目錄我換成 ~:
== mempalace 向量索引壞了怎麼修
【vault 相關卡片】依本次提問比對 Obsidian vault(~/.claude/memory)找到下列卡片。與本題相關的先 Read 全文再判斷;不相關就忽略:
- ~\.claude\memory\feedback\feedback_mempalace_benign_warnings.md — mempalace 用非零 exit 表達 benign 警告(如 HNSW flush-lag),需 wrapper 過濾,debug 前先看訊息內容判斷
- ~\.claude\memory\debugging\debugging_mempalace_hnsw_crash.md — mempalace tool call 立刻 Connection closed、stderr 無 Python traceback 時,是 HNSW native segment crash + 殭屍 process,照此 SOP 修
- ~\.claude\memory\meta\_reflection_2026-05-21.md — 反思 memory 為什麼長成花朵狀 / 內容重疊 / 缺 cross-link。分析根因 + 改進方案,作為後續整理 memory 跟改 CLAUDE.md 的依據
(608 ms)
== vite 部署到自訂網域 base 路徑要怎麼設
【vault 相關卡片】...
- ~\.claude\memory\reference\reference_firebase_custom_domain_cloudflare.md — Firebase Hosting 接自訂網域(DNS 在 Cloudflare)的最短路徑 SOP ...
- ~\.claude\memory\feedback\feedback_vite_base_custom_domain.md — Vite + GitHub Pages 換 custom domain 要同步改 base + 寫死絕對 URL ...
(856 ms)
== 好的繼續
(811 ms)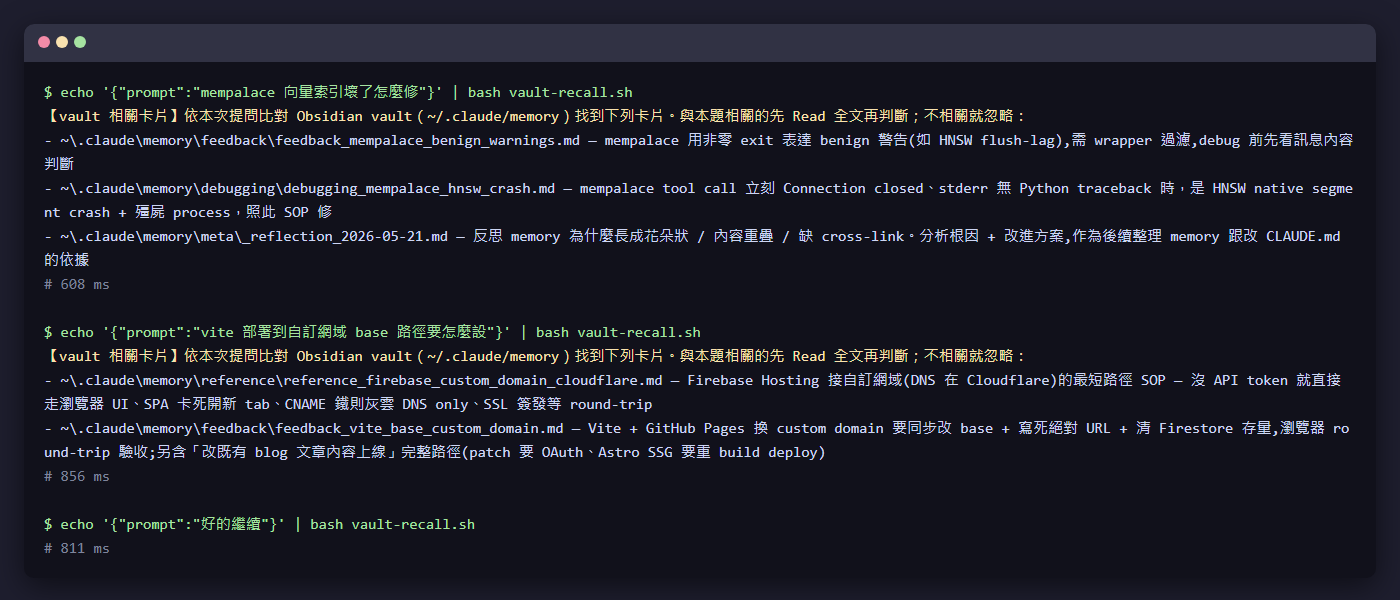
前兩題撈到的都是對的卡,第一題的第三張反思卡算是雜訊。「好的繼續」這種沒有內容的回覆不會注入任何東西,這是門檻設計想要的結果。每次執行約 0.5 到 0.9 秒,卡片每次都重新讀檔計算(實測時是 372 張),沒有做索引快取。
這套跟 LLM Wiki、RAG 的對應關係
| LLM Wiki 的概念 | 我的實作 |
|---|---|
| raw sources | Claude Code 的對話 transcript,以及 .inbox/ 的濃縮文字 |
| wiki | ~/.claude/memory/ 裡的卡片 |
| schema | CLAUDE.md 與寫卡規則 |
| ingest | vault-nightly.sh 階段一 |
| lint | vault-lint.sh |
| query | vault-recall.sh,以及 Claude 自己 Read 卡片 |
~/.claude/ 底下的檔案索引成 9,790 筆。但寫這篇時查它的狀態,向量檢索是停用的:HNSW 索引只有 9,000 筆,跟 SQLite 裡的 9,790 筆對不上,工具自己判定要先跑 mempalace repair 重建才能用。所以目前每天真正在運作的是 BM25 這條。
還沒解決的問題
- BM25 只認字面:提問用的詞跟卡片寫的詞不一樣時就撈不到。vault 裡明明有排程器 PATH 的紀錄,但我問「為什麼排程跑不起來」時沒有任何卡片過門檻;換成「排程的時候指令找不到」,撈回來的只有一張不相關的反思卡。我評估的下一步是用本機的 embedding 模型(例如 Ollama 跑 bge-m3)做混合檢索,還沒實作。
- 整理靠訂閱額度:
claude -p吃的是 Claude 訂閱額度,週額度用完那晚就整理不了。換帳號是止血,不是根治。 - 索引超過 200 行:
MEMORY.md465 行,如果改用官方 auto memory 目錄,超過的部分不會載入。這也是我把檢索交給 hook,不依賴索引整份被讀的原因。
想自己做一套,可以從哪裡開始?
依我自己的經驗,順序可以這樣排:
- 先用官方的 CLAUDE.md 和 auto memory。卡片少的時候,200 行索引放得下,不需要任何 hook。
- 卡片多到索引放不下時,加 UserPromptSubmit hook 做檢索。BM25 一個 Python 檔就夠,先確認每次注入的卡片是對的,再考慮換向量。
- 不想每次手動叫 Claude 記筆記時,加 Stop hook 排隊。排隊和寫卡分開,Stop hook 本身只做輕量的事。
- 最後才加夜間整理。排程器的 PATH、執行逾時、額度用完,每一個都要在腳本開頭先檢查,不然會連續幾晚空轉才發現。
常見問題
一定要用 Obsidian 嗎?
不用。卡片就是一般的 markdown 檔,hook 只讀檔案系統。Obsidian 的用處是讓我自己翻卡片、看連結關係比較方便。
為什麼不直接用向量資料庫?
向量檢索需要 embedding 模型和索引維護。我裝的 mempalace 就遇過索引跟資料筆數對不上、需要重建的狀況。BM25 每次直接讀 markdown 計算,沒有額外的狀態要維護,卡片數在幾百張的規模時速度也夠。
UserPromptSubmit hook 會不會拖慢每次提問?
我的實測是每次 0.5 到 0.9 秒,當時 372 張卡。hook 有設 10 秒逾時。卡片數再多一個數量級時,就需要把斷詞結果快取起來,不要每次重算。
夜間整理會不會把錯的東西寫進卡片?
會有這個風險,因為判斷寫什麼的是 LLM。我的做法是每晚寄日報列出寫了哪幾張卡,自己看標題抽查;寫卡規則要求先找同主題的卡補充,不要一直開新卡。