懶人包
- IG 帳號 huajuan0319 在 2026-10-18 發的 44.37 秒副業 Reel,拿到 2,573 讚、1,188 則留言,帳號本身粉絲 1,252。片尾要觀眾「留言 AI」拿詳細教程。
- 用 ffmpeg 加 Whisper 拆成時間軸:前 16.72 秒(38%)沒有口白、播一支別的頻道的 AI 動畫,19.6 秒開始說「1000 萬人看過、賺了不少錢」,25.28 秒才開始教,43.16 秒叫你留言。
- 它教的工具是 Capafy 市集上的 CloneCut agent。2026-11-05 官網價格:月訂 US$29.99 換 27 次請求,每次請求最多產出一段 4–15 秒影片,照片中「每天發幾條」的節奏,一個月的額度大約撐 9 天。
- 我把拆解流程寫成 175 行的 reel_anatomy.py:吃 mp4 和 Whisper JSON,輸出結構 JSON 與單檔 HTML 報告。
- Whisper small 直接跑這支片會輸出簡體,還把 Capafy 聽成「CAPFA」、ChatGPT 聽成「拆GBT」,規則分類抓不到收益宣稱。加一段
--initial_prompt寫明繁體與產品名後,三個產品名裡有兩個寫對,收益、工具、CTA 都標得到。
IG 帳號 huajuan0319(顯示名稱「Skill Discovery」)在 2026-10-18 發了一支 44 秒的 Reel,hashtag 只有三個:#副業、#vibecoding、#技巧。我抓資料時是 2,573 個讚、1,188 則留言;這個帳號的粉絲數是 1,252。留言數幾乎跟粉絲數一樣多,原因在片尾那句話:「留言 AI,我把詳細教程傳給你。」
這篇做兩件事。一是把這 44 秒逐秒拆開,看每一段在做什麼;二是把拆解的過程寫成一支可以重複用的腳本,下次看到同類型的 Reel,丟進去就能得到同一份時間軸。
這支 Reel 的 44 秒是怎麼分配的?
我用 Whisper 轉逐字稿、用 ffmpeg 偵測換場,再用關鍵字規則幫每一段貼標籤。整理成表:
| 時間(秒) | 畫面與口白 | 段落作用 |
|---|---|---|
| 0–1 | 「看下這個」 | 點題 |
| 1–17.72 | 沒有口白,全螢幕播一支 AI 卡通動畫,右下角是作者的小窗反應,畫面上留著「Canal Da…」浮水印 | 借來的誘餌素材 |
| 17.72–19.6 | 「你剛剛是不是也把這個視頻看完了」 | 點題 |
| 19.6–22.96 | 說大約有 1000 萬人看過、「這個視頻讓你賺了不少的錢」,畫面秀一張 REVENUE $1,248.76 的圖卡 | 收益/流量宣稱 |
| 22.96–25.28 | 「接下來我教你如何做出跟他差不多的影片」 | 點題 |
| 25.28–39.16 | ChatGPT 寫迪士尼風格、適合兒童的 AI 影片提示詞 → Google 搜 Capafy → 找到 CloneCut → 貼上提示詞生成影片 | 工具步驟 |
| 40–42.52 | 「每天在你的頻道上發布幾條這樣的視頻」 | 執行承諾 |
| 43.16–44.37 | 「留言 AI,我把詳細教程傳給你」 | 留言 CTA |
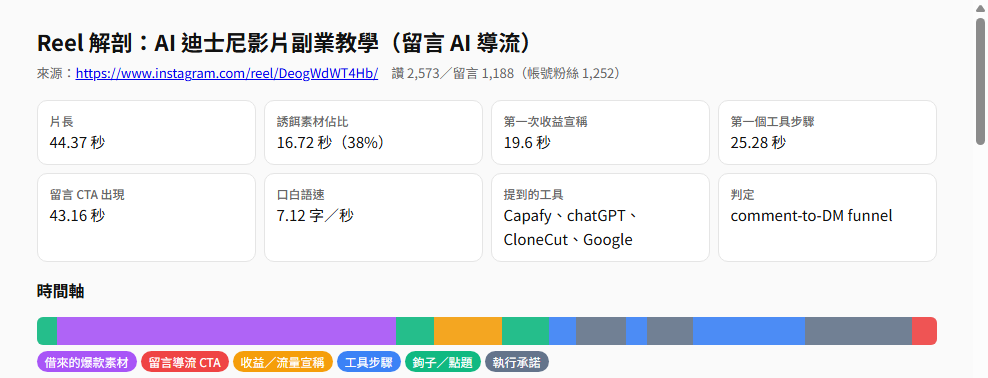
時間軸上最顯眼的是紫色那段。前 38% 的秒數沒有任何口白,放的是一支已經在別的頻道跑過流量的動畫。觀眾會停下來,是因為那支動畫本身好看;作者的聲音到第 17.72 秒才第一次出現,接著用「你剛剛是不是也看完了」把觀眾的停留轉成話題。
真正的教學只有 14 秒左右,口白語速是每秒 7.12 個字。四個步驟裡沒有任何參數、價格或畫面設定,只有「打開、搜尋、找到、貼上」。片子交代的是「這件事很簡單」,細節則留給留言之後的私訊。
1,188 則留言是怎麼來的?
片尾的 CTA 是「留言 AI」,所以每個想拿教程的人都會在留言區打一次「AI」。我抓資料時看得到的最新 12 則留言,全部是「AI」或「Ai」。
這個設計把「想要教程」直接換成「留言數」。所以 1,188 這個數字量到的是「有多少次有人想拿教程」,跟「這支片教得好不好」是兩件事。從公開頁面看不到觸及人數,也分不出留言的人裡有多少是原本的粉絲,我只能確定一件事:留言數跟粉絲數已經是同一個量級。
它推的 CloneCut 一個月要多少錢?
片中說的「Capafy」是 capafy.ai,一個 AI agent 技能市集,首頁標語是「Expert Agents, ready for your task.」。發布者可以選訂閱、按小時租用或一次買斷三種收費模式,Earn 頁面寫明平台抽 20%、發布者拿 80%,首次上架另收 US$0.99 認證費。這頁沒有提到推薦人或聯盟分潤的機制,所以這支 Reel 跟 CloneCut 之間是什麼關係,從公開資料看不出來。
CloneCut 的完整名稱是「CloneCut — Viral Clone, Seedance2.0」,發布者是 saya,底層模型是 Seedance 2.0。我在 2026-11-05 打開它的 agent 頁面,評分 4.6、已售出 46,214,版本 v1.3.8(2026/10/22 更新)。價格分頁是這樣:
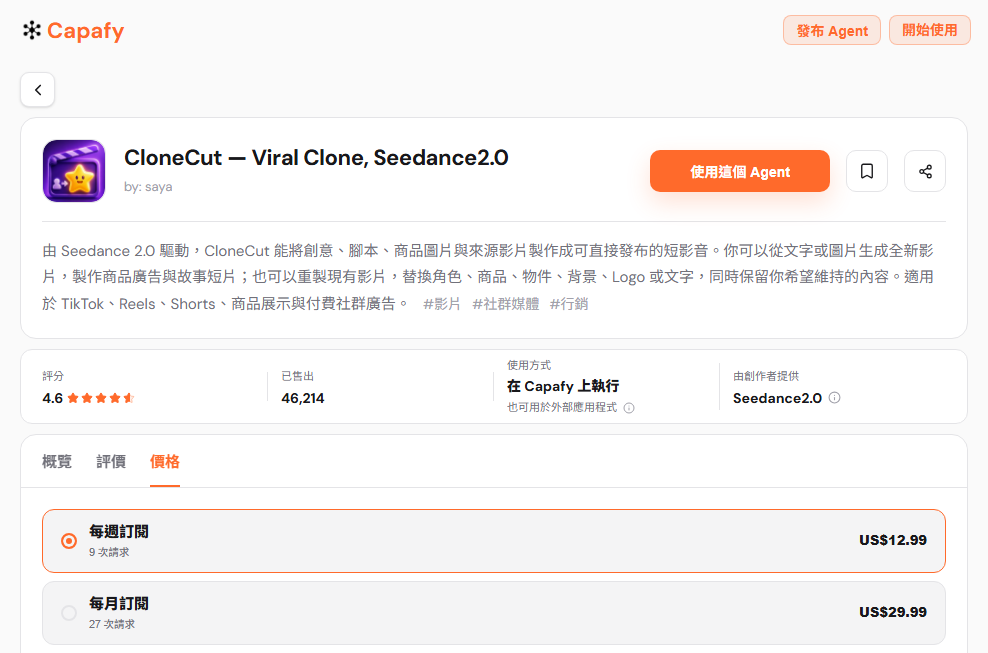
| 方案 | 價格 | 請求次數 | 每次請求單價 |
|---|---|---|---|
| 每週訂閱 | US$12.99 | 9 次 | 約 US$1.44 |
| 每月訂閱 | US$29.99 | 27 次 | 約 US$1.11 |
| 年度訂閱 | US$149.99 | 156 次 | 約 US$0.96 |
把這個數字放回 Reel 的建議裡。片中說「每天在你的頻道上發布幾條」,以一天 3 支、每支只用一次請求來算,一個月要 90 次請求;月訂方案的 27 次,大約是 9 天的量。片中當誘餌播的那段動畫就有 16.72 秒,超過單次上限,照官方說明要拆成兩次以上的請求,實際消耗會更快。這些都還沒算上生成結果不滿意、要重來的次數。
我這次沒有付費實測 CloneCut,所以「貼上提示詞就出片」的品質如何,這篇不下結論。上面的算式只用官網公開的價格和單次產出上限。
我怎麼把一支 Reel 拆成時間軸?
整條流程是四步:拿到影片、轉逐字稿、偵測換場、按規則貼標籤。
拿影片:這支 Reel 用 yt-dlp 抓會被 IG 的登入牆擋下。我改用瀏覽器打開頁面,從網路請求裡找到 720p 的影像和音軌兩條 DASH 串流,下載後用 ffmpeg 合併成一支 mp4。
轉逐字稿:用 openai-whisper 的 small 模型(版本 20250625),44 秒的片在我的電腦上跑 27 秒:
whisper reel.mp4 --model small --language zh \
  --initial_prompt "以下是繁體中文。工具:ChatGPT、Capafy、CloneCut、Google、提示詞。" \
  --output_format json --output_dir dl
--initial_prompt 這行的作用,下一節有實測對照。
分類規則:reel_anatomy.py 用一張關鍵字規則表幫每段逐字稿貼標籤。CTA、收益宣稱、工具步驟各一條 regex:
RULES = [
    ("cta", "留言導流 CTA", r"留言|私訊|私信|傳給你|传给|發給你|連結|link|bio|主頁|教程傳|叫成傳給"),
    ("money", "收益/流量宣稱", r"賺|收入|美金|美元|\$|萬人|千萬|1000萬|百萬|流量|變現|錢"),
    ("tool", "工具步驟", r"打開|搜尋|搜索|貼進去|複製|找到|chatgpt|google|capafy|clonecut|提示詞|prompt|agent|age\b"),
    ("hook", "鉤子/點題", r"看下這個|看看這個|你剛剛|是不是|教你|如何做出|接下來"),
    ("habit", "執行承諾", r"每天|發布|頻道|持續|一週"),
]
另外有一條規則專門抓誘餌段:第一句和第二句口白之間如果空了 5 秒以上,就把那段標成「借來的素材」。這支片的空白是 1.0 到 17.72 秒。
換場偵測用 ffmpeg 的 select='gt(scene,0.3)' 濾鏡,門檻 0.3。這支片偵測到 4 個換場點:25.23、32.97、39.23、42.07 秒,剛好對上「進入教學」「切到 Google」「切到成品」「片尾動畫」。
執行:
python -I reel_anatomy.py dl/reel.mp4 dl/reel.json out \
  --title "Reel 解剖:AI 迪士尼影片副業教學" \
  --url "https://www.instagram.com/reel/DeogWdWT4Hb/" \
  --stats "讚 2,573/留言 1,188"
輸出的摘要:
{
  "duration_s": 44.37,
  "scene_cuts": [25.23, 32.97, 39.23, 42.07],
  "bait_seconds": 16.72,
  "bait_ratio": 0.38,
  "speech_chars_per_sec": 7.12,
  "first_money_claim_s": 19.6,
  "first_tool_step_s": 25.28,
  "cta_at_s": 43.16,
  "tool_mentions": ["Capafy", "chatGPT", "CloneCut", "Google"],
  "pattern": "comment-to-DM funnel"
}
同一次執行還會產出一份單檔 HTML 報告,縮圖以 base64 內嵌,可以直接丟上靜態主機。
Whisper 中文逐字稿的兩個坑:簡體輸出與產品名聽錯
上面那份摘要用的逐字稿,產品名稱已經是對的。2026-11-05 我拿同一支 mp4 重跑 Whisper,比較三種逐字稿餵給同一支腳本的結果:
| 逐字稿版本 | 產品名稱與抓到的工具 | 第一次收益宣稱 | 沒標籤段落 |
|---|---|---|---|
| Whisper 直接輸出(簡體) | 拆GBT、CAPFA、CloneCAT;工具只抓到 Google | 抓不到 | 11/18 |
直接輸出再用 OpenCC s2t 轉繁 | 同上 | 19.6 秒 | 6/18 |
加 --initial_prompt(繁體) | XIGPT、Capafy、CloneCut;工具抓到 Capafy、CloneCut、Google | 20.0 秒 | 5/20 |
- 簡繁:Whisper 的
--language zh對這支片輸出簡體。規則表裡的「萬人」「錢」是繁體字,簡體的「万人」「钱」比對不到,收益宣稱整段漏掉。轉成繁體,或在 initial prompt 裡寫一句繁體中文,都能修好。 - 產品名:Capafy、CloneCut 這種新名字,模型沒聽過就會照發音亂拼。initial prompt 裡列出名字後,三個產品名寫對兩個,ChatGPT 還是被聽成「XIGPT」。逐字稿要拿來數工具出現幾次的話,還是要人工掃一遍。
這套拆法可以用在哪裡?
這支 Reel 的結構可以寫成一行:誘餌素材 → 收益宣稱 → 三步教學 → 留言 CTA。拆出這個骨架之後,我會這樣用:
- 拿來做自己的 Shorts:結構可以借,誘餌段放自己做的成品畫面,不放別人頻道的影片。這支片畫面上留著原頻道浮水印,借用素材的授權是另一個問題,我自己的片不會這樣做。
- 拿來比較不同的 Reel:每支片跑出同一組數字(誘餌佔比、第一次收益宣稱的秒數、CTA 的秒數),累積幾支之後就能並排比較。
- 拿來判斷要不要跟著做副業:先把它推薦的工具查到官網價格,算一次「每天發幾條」要花多少錢,再決定要不要付費。
這支腳本的限制
- 規則是照這支片調的。換成美妝、理財或其他類型的 Reel,關鍵字表要自己擴充;這支片仍有 5 段沒被分到任何類別,例如「選一個你喜歡的、適合兒童觀看的」。
- 畫面上的字沒有 OCR。REVENUE $1,248.76 那張圖卡是看畫面認出來的,腳本本身只讀口白。
- 誘餌段只靠「沒有口白」判斷。如果作者全程講話、同時播別人的影片,這條規則抓不到。
- 抓影片要自己處理登入牆。IG 這次擋了 yt-dlp,我是從瀏覽器的網路請求拿串流網址。
延伸資源
- CloneCut agent 頁面:價格分頁與「每次最多 4–15 秒」的使用說明。
- Capafy Earn 頁面:發布者 80% 分潤、三種收費模式。
- openai/whisper:
--initial_prompt、--language等參數說明。 - OpenCC:簡繁轉換,Python 可用
opencc-python-reimplemented(我用 0.1.7)。 - FFmpeg Filters Documentation:
select濾鏡的scene值說明。
常見問題
IG 留言關鍵字拿教程的 Reel,留言數高代表影片好嗎?
不一定。這支片 1,188 則留言,我看得到的最新 12 則全部是「AI」。留言數反映的是「有多少人想拿教程」,跟教學內容的品質是兩回事。
CloneCut 要多少錢?一次能做多長的影片?
2026-11-05 官網價格:週訂 US$12.99(9 次請求)、月訂 US$29.99(27 次)、年訂 US$149.99(156 次)。每次請求最多產出一段 4–15 秒影片,長片要拆成多次請求。
Whisper 轉中文逐字稿,產品名稱一直聽錯怎麼辦?
用 --initial_prompt 寫一句繁體中文,加上產品名稱清單。這支片實測後,Capafy、CloneCut 從「CAPFA」「CloneCAT」變成正確拼法,輸出也從簡體變成繁體;ChatGPT 仍然聽錯,數字類的分析還是要人工複查。