懶人包
- IG 帳號 soft_respawn 在 2026-09-18 發的賽博龐克溜冰 Reel,到 10-27 有 4.3 萬讚、396 則留言。貼文自己寫了流程:GPT-Image 生一張關鍵幀 → Seedance 2.5 圖生影片 → Topaz AI 放大,三步都在 SYNTX 平台上跑,文末附折扣碼,是業配。
- 三步裡決定畫面的是第一步。構圖、光影、角色造型都在關鍵幀定死,圖生影片模型只負責讓它動幾秒,放大只負責解析度。
- Seedance 2.5 是 ByteDance 2026-07-31 發表的影片模型,單次最長 30 秒。第三方 API 的圖生影片價格我查到每秒約 0.134 到 0.47 美元,一支 6 秒 9:16 片段約 0.8 到 2.8 美元。
- 我在本機重現了一次:Codex 生一張原創角色的 9:16 關鍵幀,再用 ffmpeg 做 6 秒推軌、霓虹閃爍和雨絲,從 540p 放大到 1080p,整條 pipeline 跑 5.8 秒。
- 限制很明確:ffmpeg 只能動鏡頭,角色不會滑、輪子不會轉;傳統放大只會去鋸齒,不會補細節。要做到原片的效果,第二步一定要接生成式模型。
這篇拆一支 IG 爆款 AI 短片的做法,然後用免費工具把三步流程在本機跑一遍,看看哪一步能自己做、哪一步非付費模型不可。prompt 產生器和試片已經放在 Neon Reel Lab,打開就能用。
這支賽博龐克 Reel 在演什麼?
原始貼文是 IG 帳號 soft_respawn 的 Reel,2026-09-18 發佈。我在 2026-10-27 讀到的數字是 43K likes、396 comments。
畫面是一個穿黃色短夾克、背後有螢光綠塗鴉的人,穿著發光直排輪,從低角度背後視角滑下雨夜的霓虹巷子。遠方是一整片摩天樓和全息廣告看板,高架電車從中景穿過,地面的水窪反射洋紅和青色的光。標題是「Night City hits different on rollers.」,hashtag 打的是 #CyberpunkEdgerunners #NightCity。
我手上能拿到的是貼文文案和預覽畫面,以下拆解以這兩樣為準,沒有逐格分析原片。
貼文文案把流程寫得很清楚,我整理成表:
| 步驟 | 貼文寫的工具 | 這一步負責什麼 |
|---|---|---|
| 1 關鍵幀 | GPT-Image | 一張構圖完整的直式圖:角色、場景、光影、色調 |
| 2 動起來 | Seedance 2.5(在 SYNTX 上跑) | 以關鍵幀當首幀,生成幾秒的動態影片 |
| 3 放大 | Topaz AI(在 SYNTX 上跑,貼文寫 0 credits) | 把影片放大到發布用的解析度 |
為什麼說關鍵幀決定了八成畫面?
看完這支片,我的判斷是:觀眾記住的每一個元素,在第一步那張圖裡就已經存在了。
霓虹巷子的縱深、黃夾克對上洋紅背景的撞色、低角度背影帶出的速度感、遠景摩天樓的層次,全部是靜態構圖的功勞。第二步的影片模型做的事情是讓角色往前滑、雨絲落下、電車經過,時間只有幾秒。第三步把解析度拉上去,讓 Reels 上看起來夠銳利。
這也解釋了這套流程為什麼好上手:圖生影片比文生影片多了一個錨點。角色長相、服裝、配色都由首幀鎖住,模型只要處理動作,比從一句話生出整段影片穩定。我沒有拿 Seedance 實測失敗率,這一點是從工具的輸入設計推出來的:圖生影片的 API 都把首幀圖當必填。
至於為什麼紅,我只能講看得到的部分。hashtag 直接掛 Cyberpunk: Edgerunners 和 Night City,對準的是現成的同人社群;9:16、幾秒長、霓虹雨夜這三個條件放在 Reels 上,適合自動循環播放。
Seedance 2.5 是什麼?圖生影片要花多少錢?
Seedance 2.5 是 ByteDance Seed 團隊的影片生成模型。依 TechNode 2026-07-31 的報導:
- 推到即夢 AI 和豆包 Pro 版,Volcano Engine Ark 的 API 當時寫「即將推出」。
- 單次可以生成 30 秒的影片,也支援多輪延伸。
- 一次輸入最多可放 30 張圖、10 段影片、10 段音訊當參考。
| 平台 | 解析度 | 長度 | 價格 | 6 秒 9:16 估算 |
|---|---|---|---|---|
| fal.ai | 480p、720p | auto 或 4–30 秒 | 每千 token 0.0214 美元 | 720p 約 2.77 美元 |
| Atlas Cloud | 480p、720p、1080p | 4–30 秒,預設 5 | 每秒 0.134 美元 | 約 0.80 美元 |
高 × 寬 × 秒數 × 24 / 1024,720×1280、6 秒算出來是 129,600 token;Atlas Cloud 的價格頁標註 2026-08-25 更新。
fal.ai 的端點參數長這樣:image_url 是首幀(必填),end_image_url 可以另外指定尾幀,aspect_ratio 有 9:16,generate_audio 預設會一起生成音訊。兩家的價差超過三倍,計價方式也不同,實際要用先看當天的價格頁。
我怎麼在本機重現這三步?
目標是用手邊免費的工具把三步各做一次,看每一步的產出長什麼樣子。我沒有付費接 Seedance,所以第二步用 ffmpeg 代替,這一步的結果跟原片差距最大。
| 步驟 | 原片用的 | 我用的 | 實際產出 |
|---|---|---|---|
| 1 關鍵幀 | GPT-Image | Codex CLI 的 image_gen | 941×1672 PNG,約 1 分鐘 |
| 2 動起來 | Seedance 2.5 | ffmpeg zoompan 推軌 + 閃爍 + 雨絲 | 540×960、6 秒、144 格 |
| 3 放大 | Topaz AI | ffmpeg lanczos + unsharp | 1080×1920、6 秒、144 格 |
第一步:用 Codex 生一張原創角色的關鍵幀
角色我刻意寫成原創,不是動畫裡的任何角色。prompt 照原片的構圖元素一條條寫進去:低角度背後視角、黃色短夾克、螢光綠塗鴉、發光直排輪、雨夜霓虹巷、高架電車、水窪反射。
Vertical 9:16 anime key frame, Cyberpunk-anime style (original character, not any existing IP character): a young rollerblader in a yellow cropped jacket with neon green glowing graffiti, seen from low behind-the-shoulder angle, skating down a rain-soaked neon alley at night toward a dense megacity skyline with holographic billboards, an elevated train crossing, magenta and cyan reflections in puddles, glowing inline-skate wheels, cinematic depth, clear foreground/midground/background layers. No text, no watermarks.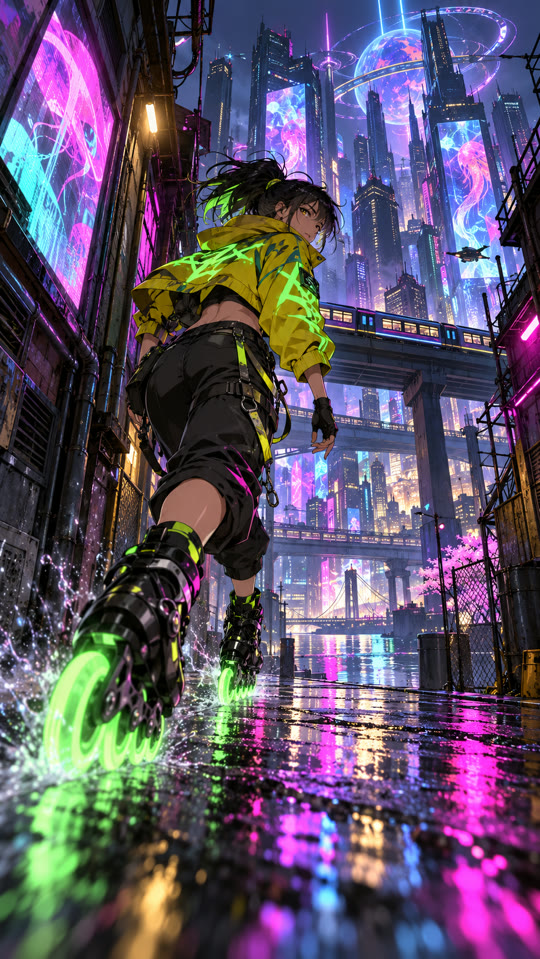
最後那句 clear foreground/midground/background layers 是給第二步用的。前中後景分得開,鏡頭推進時才有視差的感覺,不管後面接的是 ffmpeg 還是影片模型都一樣。
第二步:用 ffmpeg 讓畫面動起來
ffmpeg 不會生成新內容,能做的只有對整張圖做運算。我疊了三層:
zoompan在 6 秒內從 1.0 倍推到 1.18 倍,再加一點sin晃動,模擬跟拍。eq每 2 秒閃一次亮度,模擬霓虹燈接觸不良。- 用隨機噪點拉成直線當雨絲,以 screen 模式疊上去。
bash pipeline.sh key_frame.png out:
#!/usr/bin/env bash
set -euo pipefail
KEY="$1"; OUT="$2"; mkdir -p "$OUT"
FPS=24; DUR=6; FRAMES=$((FPS*DUR))

# 統一成 9:16 的 1440x2560 底圖,給 zoompan 足夠像素
ffmpeg -y -loglevel error -i "$KEY" -vf "scale=1440:2560:force_original_aspect_ratio=increase,crop=1440:2560" "$OUT/key_9x16.png"

# Stage 2:推軌 + 霓虹閃爍 + 雨絲,輸出 540x960
ffmpeg -y -loglevel error -loop 1 -i "$OUT/key_9x16.png" \
  -f lavfi -i "nullsrc=s=540x960:d=$DUR:r=$FPS" \
  -filter_complex "\
[0:v]zoompan=z='1.0+0.18*on/$FRAMES':x='iw/2-(iw/zoom/2)+6*sin(on/5)':y='ih/2-(ih/zoom/2)+on*0.6+4*sin(on/3)':d=$FRAMES:s=540x960:fps=$FPS,\
eq=brightness='0.03*sin(2*PI*t*3)*between(mod(t,2),0.4,0.7)':saturation=1.15[bg];\
[1:v]geq=lum='if(lt(random(1),0.004),255,0)':cb=128:cr=128,avgblur=sizeX=1:sizeY=12,eq=brightness=0.0:contrast=3,format=gbrp[rain];[bg]format=gbrp[bgp];[bgp][rain]blend=all_mode=screen:all_opacity=0.45,format=yuv420p[v]" \
  -map "[v]" -t $DUR -r $FPS -c:v libx264 -crf 20 -pix_fmt yuv420p "$OUT/stage2_animated_540p.mp4"

# Stage 3:lanczos 放大到 1080x1920 + 輕度銳化
ffmpeg -y -loglevel error -i "$OUT/stage2_animated_540p.mp4" \
  -vf "scale=1080:1920:flags=lanczos,unsharp=5:5:0.8:5:5:0.0" \
  -c:v libx264 -crf 18 -preset slow -pix_fmt yuv420p "$OUT/stage3_upscaled_1080p.mp4"
雨絲那層第一版直接用 blend 疊在 YUV 畫面上,整個畫面變成全黑。原因是 YUV 的色度通道也被拿去做 screen 運算,我改成兩邊都先轉 gbrp(RGB 平面格式)再混合,畫面就正常了。這個問題在終端機不會報錯,是看了抽格圖才發現的。
下面是 0、2、4、5.9 秒四格,可以看到鏡頭往前推、往下沉:
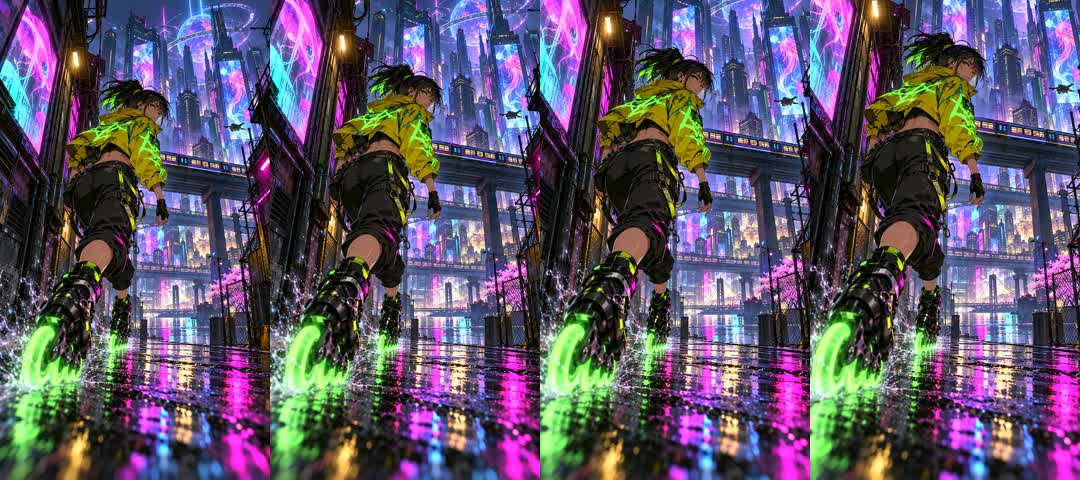
四格裡角色的姿勢一模一樣,ffmpeg 版跟原片最大的差別就在這裡:原片的角色在滑、手在擺、輪子在轉,這裡只有鏡頭在動。
第三步:放大到 1080×1920
我在 Windows 上用 ffmpeg 8.0 跑整條 pipeline,time 量到 5.8 秒。ffprobe 讀回來的數值整理如下:
stage2_animated_540p.mp4   540x960    6.000000s  144 frames  2.0 MB
stage3_upscaled_1080p.mp4  1080x1920  6.000000s  144 frames  8.9 MB
同一格、同一塊區域放大來比,左邊是 540p 直接放大兩倍(最近鄰),右邊是 lanczos 加銳化的 1080p:
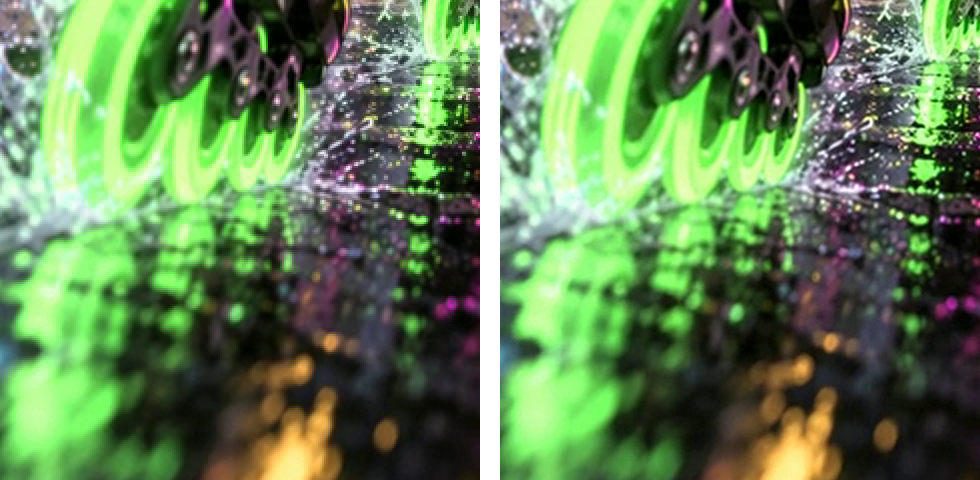
右邊的方塊鋸齒不見了,邊緣比較平滑,但輪子的花紋、水花的顆粒都沒有比左邊多。傳統插值只能在既有像素之間補值,不會畫出原本沒有的東西。原片用 Topaz AI 這類模型做放大,目的就是補這些細節,這一步要達到同樣效果也得換成 AI 放大。
哪一步可以自己做、哪一步一定要付費?
| 步驟 | 免費能做到的程度 | 要接近原片需要什麼 |
|---|---|---|
| 1 關鍵幀 | 夠用。Codex、GPT-Image 這類生圖工具就能做出可用的構圖 | 多生幾張挑最好的一張 |
| 2 動起來 | 只能動鏡頭,角色是靜止的 | Seedance、Kling、Veo 這類圖生影片模型 |
| 3 放大 | 去鋸齒,不補細節 | Topaz 這類 AI 放大 |
SYNTX 這類平台賣的是「三步在同一個地方做完」。如果只是想試 Seedance 2.5,上面那兩家 API 都能按秒計費,不用綁訂閱。我沒用過 SYNTX,也沒找到它的獨立評測,所以不推薦也不反對,只提醒這支貼文是業配。
試片和 prompt 產生器在哪裡?
我把試片、關鍵幀和一個 prompt 產生器做成單檔網頁:Neon Reel Lab。選主角、畫風、鏡頭運動,就會組出兩段 prompt:第一段貼到生圖工具做關鍵幀,第二段在圖生影片工具上傳關鍵幀後貼上。
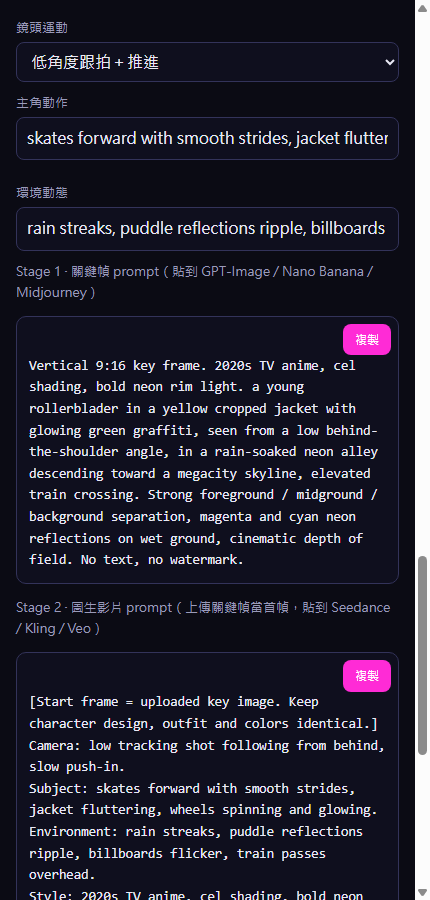
第二段 prompt 開頭固定寫「Start frame = uploaded key image. Keep character design, outfit and colors identical.」,把首幀當成角色設定的依據,後面才描述鏡頭、主體動作和環境動態。
同樣是拆 IG 爆款 AI 短片,〈開明獸〉那篇拆的是 6 鏡 20 秒的敘事公式;這篇的重點是單鏡頭的製作流程。兩篇可以搭著用:先用分鏡決定要拍哪幾個畫面,每個畫面再走一次「關鍵幀 → 圖生影片 → 放大」。
常見問題
GPT-Image 生的圖可以直接丟進 Seedance 嗎?
可以。圖生影片端點吃的是一般圖片檔,fal.ai 的頁面寫支援 jpg、png、webp 等格式,上傳後當成首幀。比例建議生圖時就做成 9:16,跟影片輸出比例一致,避免被裁切。
沒有預算,只用 ffmpeg 能做出這種 Reel 嗎?
做得出「會動的畫面」,做不出「角色在動的影片」。ffmpeg 只能推鏡頭、閃光、疊雨絲,角色會像一張貼紙。適合當封面動態或片頭,要當主片還是得接圖生影片模型。
用動畫裡的角色做同人短片可以嗎?
原片 hashtag 掛的是 Cyberpunk: Edgerunners,但我重現時刻意用了原創角色。要公開或接業配的作品,用自己設計的角色比較單純。