懶人包
- Karpathy 在 2026-10-02 的 X 長文裡提到,他會叫 LLM 用 ASD-STE100 解釋東西,嫌太嚴就要求「80% of the way to ASD-STE100」。那是他分享的使用心得,不是他發明的新技巧;ASD-STE100 是 1986 年就有的飛機維修文件英文標準。
- 流傳的那句「Use short sentences, common words, consistent terms… Keep the tone natural」是第三方擴寫,Karpathy 原文沒有這句。我兩種都測了。
- 實測 Claude Sonnet 和 Haiku,5 題技術問題、每格各 1 次回答,用自寫的 STE 規則檢查器計分:只加 Karpathy 原話,違規少 39%(Sonnet)和 55%(Haiku);用擴寫版少 69% 和 59%;完整規則版少 87% 和 74%。
- 字數幾乎不變,零違規句比例從 6 成多升到 8–9 成。嚴格版在 k8s 回滾題自己加了兩條 CAUTION,一般版沒有。
- 我的用法:寫 README、操作步驟、交接信這類「讀者要照做」的英文時,把擴寫版那一句加進 prompt;聊天、說服、需要語氣的內容不用。檢查器放在線上,貼英文就能跑。
一支 Facebook Reels 說「Andrey Karpathy introduced the ASD-STE100 prompting trick」,叫 AI 照航太維修手冊的英文寫,回答會更清楚。我想知道兩件事:Karpathy 原文到底說了什麼,以及這招在 Claude 上量得出差別嗎。
所以我找了原貼文,再跑了一組 A/B 實驗,把結果和檢查器做成一頁 STE Prompt Lab。這篇是完整紀錄。
ASD-STE100 是什麼?
ASD-STE100 Simplified Technical English(簡稱 STE)是航太業的受控英文標準,用來寫維修手冊。官網寫的起源是航空公司的要求:這些航空公司有 80% 來自非英語系國家,需要一套能確保維修做對的英文,於是業界訂了「一個字只有一個意思」的受控英文。
| 項目 | 內容 | 來源 |
|---|---|---|
| 首次發布 | 1986 年,AECMA 文件 PSC-85-16598 | 官網 About STE |
| 目前版本 | Issue 9,2025-01-15 發布,從「規格」升為「國際標準」 | 官網 About STE、FAQ |
| 下一版 | Issue 10 預定 2028-01 | 官網 FAQ |
| 寫作規則 | 53 條,分 9 節:用字、文法、句構、風格 | 官網 About STE |
| 字典 | 約 900 個核准字,每字一個意思、一種詞性;另列約 1200 個不核准字和替代字 | 官網 About STE |
| 句長 | 程序句 ≤ 20 字,描述句 ≤ 25 字 | Wikipedia 引標準原文 |
| 取得方式 | 免費,只發 PDF,要在官網 Downloads 頁申請 | 官網 FAQ |
這些規則跟我在下面 A 組基準實驗量到的違規剛好對得上:模型的一般回答裡最常出現 -ing 形式、被動語態、超長句,以及 ensure、should 這類空泛字。
Karpathy 原文到底說了什麼?
原貼文是 2026-10-02 這則 X 長文(UTC 00:37,台灣時間早上 8:37)。我在 2026-10-27 讀的時候是 801 萬次觀看、5.6 萬讚。
開頭是「We'll be spending a lot more time trying to understand the outputs of language models」,接著列了四種讓人更好讀懂 LLM 輸出的方式,每一種都說下一種「even better」:
- Writing:叫 LLM 用 ASD-STE100 解釋。原文是「Something I've had success with」,他也說規格太嚴,有時會要求「80% of the way to ASD-STE100」。
- Diagrams / images:改叫它畫圖。
- Web pages:叫它輸出 HTML 互動網頁。
- Explainer videos:叫它做客製解說影片,這是他「most bullish」的格式。
另一個差別更實際。網路上流傳的 prompt 是:
Write about 80% of the way to ASD-STE100 Simplified Technical English.
Use short sentences, common words, consistent terms, and one action per instruction.
Keep the tone natural.
Karpathy 原文只有「80% of the way to ASD-STE100」這幾個字,後面兩句是轉述文章(例如 Stork.ai)加上去的,Reels 字幕的「natural tone」也是來自這裡。我的第一輪實驗用的是這個擴寫版,發現之後又補跑了一輪只用原話的版本,兩個結果都列在下面。
我怎麼測:同一題、四種 system prompt
我用 Claude Code CLI 2.1.311 的 claude -p 呼叫模型,關掉個人設定和工具,只換 system prompt:
claude -p --model sonnet --setting-sources "" --tools "" \
--system-prompt "<A/B/C/D 其中一種>" "<題目>"| 組別 | system prompt(都先接 You are a helpful technical assistant. Answer in English.) |
|---|---|
| A 一般 | 不加東西 |
| B 原話 | Write about 80% of the way to ASD-STE100. |
| C 擴寫 | 上面那段三句的流傳版 |
| D 嚴格 | 列出 7 條 STE 規則:20/25 字上限、一句一指令、動詞開頭、主動語態、不用 -ing、常用字、警告放在步驟前 |
sonnet 和 haiku 別名,每題每組各跑 1 次,總共 40 份回答。
計分用我自己寫的 ste-lint.js,規則檢查器,Node 和瀏覽器共用。它抓這幾類違規:
- 句長超標:指令句 > 20 字、描述句 > 25 字。
- 被動語態:
be動詞後兩個字內出現過去分詞。 - -ing 形式。
- 空泛或非核准字:一份約 30 字的清單,例如
leverage → use、ensure → make sure、basically → 刪掉。
結果:原話有用,擴寫版更有用
5 題平均。「違規」是句長超標、被動、-ing、空泛字四項相加,括號是相對 A 組的變化;「零違規」是四項都沒踩的句子比例;Flesch 是易讀度,越高越好讀。
Sonnet
| 組別 | 違規 | 零違規 | Flesch |
|---|---|---|---|
| A 一般 | 12.4 | 68% | 63 |
| B 原話 | 7.6(−39%) | 82% | 72 |
| C 擴寫 | 3.8(−69%) | 91% | 76 |
| D 嚴格 | 1.6(−87%) | 95% | 75 |
| 組別 | 違規 | 零違規 | Flesch |
|---|---|---|---|
| A 一般 | 15.6 | 62% | 65 |
| B 原話 | 7.0(−55%) | 82% | 72 |
| C 擴寫 | 6.4(−59%) | 87% | 76 |
| D 嚴格 | 4.0(−74%) | 89% | 72 |
- 只加 Karpathy 那幾個字就有效。兩個模型都知道 ASD-STE100 是什麼,不用解釋規則,違規就少 4–5 成。
- 擴寫版在 Sonnet 上差距最大,從 −39% 拉到 −69%。多出來的那句把「短句、常用字、一致用詞、一句一動作」講白了,模型不用自己猜 80% 是哪 80%。
- 字數沒有變少。A/B/C/D 平均字數:Sonnet 400/393/424/320,Haiku 419/447/424/382。B、C 兩組跟 A 差不多長,變的是句子切法;只有 D 嚴格版在 Sonnet 上明顯變短。
- Flesch 易讀度從 63–65 升到 72–76,大約從「普通」移到「還算好讀」。
實際輸出差在哪?
同一題「HTTPS 怎麼保護傳輸中的資料」,Sonnet 的 A 組開頭:
HTTPS protects data in transit by layering HTTP on top of TLS (Transport Layer Security).
TLS provides three guarantees: confidentiality, integrity, and authentication.
C 擴寫組:
HTTPS protects data in transit with three main tools: encryption, authentication, and integrity checks.
It runs HTTP on top of TLS (Transport Layer Security).
...
Encryption stops others from reading the data. Without it, anyone on the network path can read your traffic.
D 嚴格組把握手過程拆成編號步驟,每步一個動作:
1. The client sends a hello message to the server.
2. The server selects a cipher suite. The server sends its certificate to the client.
3. The client checks the certificate.
內容差不多,差在每句只講一件事。
k8s 回滾那題有個意外收穫。D 嚴格組因為規則要求「警告放在步驟前」,自己加了兩條 A 組沒提的提醒:
CAUTION: The `rollout undo` command does not revert database migrations, ConfigMaps, or Secrets.
CAUTION: If you use Helm, Argo CD, or Flux, do not use `kubectl rollout undo`.
rollout undo 只把 Deployment 的 Pod 範本退回上一版,DB migration、ConfigMap 和 GitOps 工具管的狀態都不在它的範圍內,這兩條提醒點的正是這個邊界。只有 1 題 1 次,不能說嚴格 prompt 會讓模型想得更周到,但規則裡的「WARNING/CAUTION」格式確實逼它把風險講出來。
線上 STE 檢查器怎麼用?
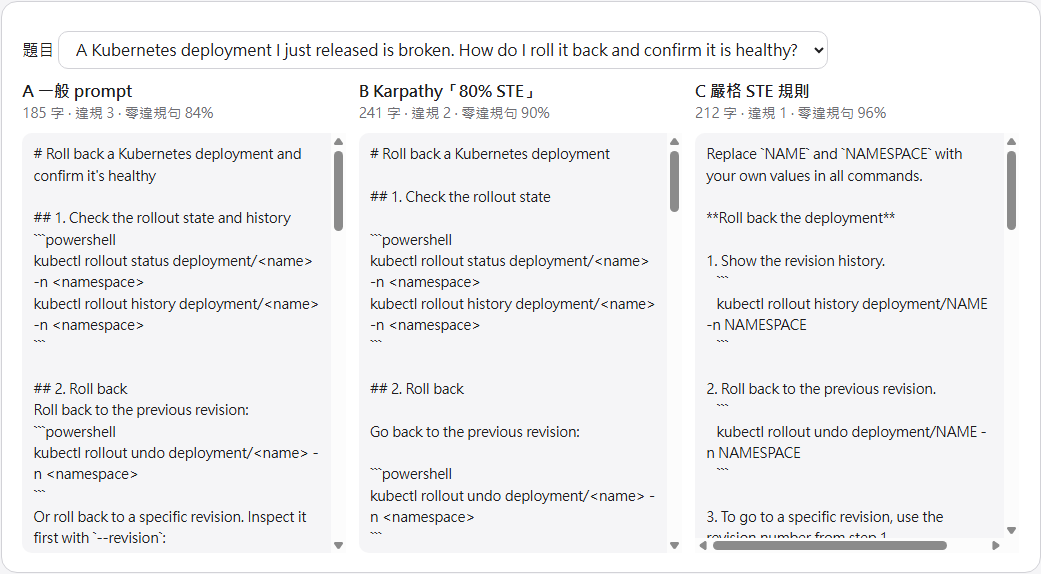
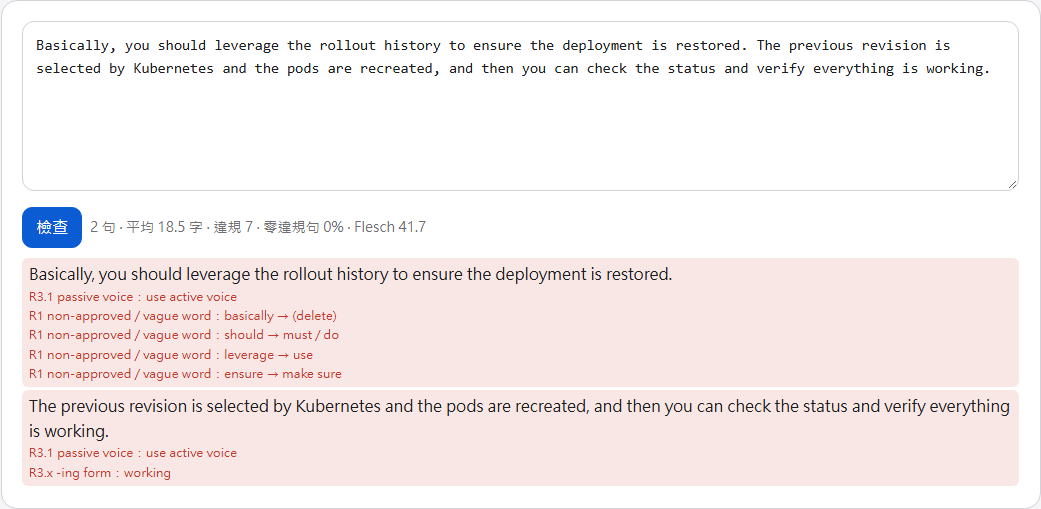
打開 html.yanchen.app/ste-prompt-lab,拉到「STE 檢查器」,貼一段英文按「檢查」。它逐句標出違規規則和建議替換字,上方顯示句數、平均句長、違規數、零違規句比例和 Flesch 分數。整個檢查在瀏覽器裡跑,不送任何資料出去。
預設範例是一段刻意寫爛的 k8s 說明,2 句被抓出 7 個違規:
頁面上也能切換 Sonnet/Haiku 看每題的原始回答。站上的 B 欄標「Karpathy 80% STE」,用的是本文的 C 擴寫版 prompt,B 原話版的數據只在這篇文章裡。
限制與踩坑:這組數字能說明什麼
- 樣本很小。每題每組只跑 1 次、共 5 題,沒有重複抽樣,看得出方向,算不出信賴區間。B 原話組是第二輪補跑的,A 組沒有在同一輪重跑。
- 檢查器會誤判。-ing 規則會把技術名詞也算進去,40 份回答裡被抓最多的是
cloning(複製磁碟)、logging、phishing這類正常用語;被動語態用簡單規則判斷,也會漏抓。它量的是「像不像 STE」,不是官方認證。 - 沒有量內容品質。違規變少不代表答案更對、更完整。要知道讀者是不是更好懂,要另外做 LLM-judge 或真人理解測驗,這次沒做。
- 嚴格不一定比較短。Haiku 的 D 組在 HTTPS 題寫了 523 字,比 A 組的 486 字還長。
- 只測英文輸出。STE 是英文標準,叫模型用 STE 規則寫中文,這次沒有測。
- 我自己踩的坑:第一輪實驗把流傳的擴寫版當成 Karpathy 原話,標成「Karpathy 80%」。回頭讀原貼文才發現不是,所以補了 B 組。轉述來源再多,也要回頭讀原文。
我會怎麼用這個 prompt?
適合的地方是「讀者要照著做」的英文:README 的安裝步驟、操作手冊、部署交接信、錯誤排查指引。我會把 C 擴寫版直接貼進 system prompt 或 skill 的英文輸出段落:
Write about 80% of the way to ASD-STE100 Simplified Technical English.
Use short sentences, common words, consistent terms, and one action per instruction.
Keep the tone natural.
要更嚴格的操作程序(例如維運 runbook),改用 D 組那 7 條規則,並要求警告放在步驟前。
想自己驗,把模型的輸出貼進線上檢查器,加 prompt 前後各貼一次,看違規數和零違規句比例的差別。
延伸資源
- Karpathy 的 X 原文(2026-10-02)
- ASD-STE100 官網 About STE:歷史、規則數、字典規模、免費申請標準 PDF
- ASD-STE100 官網 FAQ
- Wikipedia:Simplified Technical English
- STE Prompt Lab:本文實驗數據與線上檢查器
- 同樣來自 Karpathy 的另一篇實作:Karpathy 的 LLM Wiki