懶人包
- IG 上推 Graphify 的 Reel 封面寫「Claude 省 70% Token」。我在一個 62 個 TypeScript 檔的專案上量了 3 題,只看 Graphify 查圖的輸出,確實比「grep 後整份讀檔」少 72%。
- Graphify 的
query/explain只回符號名稱、檔名和行號,不附程式碼。要真的回答問題,還得補讀 2 個檔案;算進去之後是少 54%。- 同樣 3 題換成 CodeGraph 的
explore(直接附原始碼)是少 56%,跟 Graphify 加補讀幾乎打平,而且 3 題的關鍵事實全部命中。- 差距跟題型有關:Q1 這種「關鍵字散在很多檔」的題目 Graphify 省最多;Q3 這種範圍小的題目,Graphify 加補讀反而比 grep 多 18%。
- 已經有 CodeGraph 就不必換;Graphify 多出來的是互動關係圖,以及把文件、PDF 放進同一張圖的能力。
這篇的起點是 @harryleeai 在 2026-10-25 發的 Reel,封面大字寫「Graphify 构建代码图谱,Claude 省 70% Token」,說明欄講的是:Claude Code 每開一個新 session 都要重新理解 codebase,先建一張知識圖譜就能少讀很多檔案。
Graphify 怎麼裝、圖長什麼樣,我在 Graphify 實測:0 token 建 Claude Code 知識圖譜 寫過了。這次只回答一個問題:「省 70%」在自己的專案上量得出來嗎?算到能回答問題為止,還剩多少?
影片版(YouTube Shorts)
〈Graphify 真能省 70% token?我實測只剩 54%〉
〈Graphify 畫我的程式碼:114 節點卻斷成 8 座島〉
📌 目錄
🧪 我怎麼量的?
受測專案是我自己的一個 TypeScript 桌面 agent 專案:85 個檔案,其中 62 個 .ts。我先 git clone 一份複本,Graphify 只在複本上跑,沒有執行 graphify install,~/.claude 沒有被改。
| 項目 | 內容 |
|---|---|
| Graphify | PyPI 套件 graphifyy 0.9.95,裝在獨立 venv |
| CodeGraph | v1.6.0,CLI codegraph explore |
| 建圖 | graphify update .,41 秒,781 節點、1,660 條邊、41 個 community |
| 建圖成本 | Token cost: 0 input · 0 output(tree-sitter 本機解析,不呼叫 LLM) |
| token 計算 | tiktoken cl100k_base |
| 做法 | 實際動作 |
|---|---|
| grep 整份讀檔 | 用 regex 找出命中的檔案,把每個檔案整份讀進來。這是 agent 沒有索引時最直接的做法 |
| Graphify | graphify query "<英文問句>"(預設 2,000 token 預算)加上 graphify explain <關鍵符號> |
| CodeGraph | codegraph explore "<關鍵符號>",回傳相關符號的原始碼、呼叫路徑與影響範圍 |
- Q1:跑 shell 工具前,agent 怎麼決定要不要跳確認視窗?
- Q2:一封信從桌面端 bridge 進來,怎麼走到 LLM 分類再回來?
- Q3:哪些模組在用
GmailApi?access token 從哪來?
📊 Graphify 真的省 70% token 嗎?
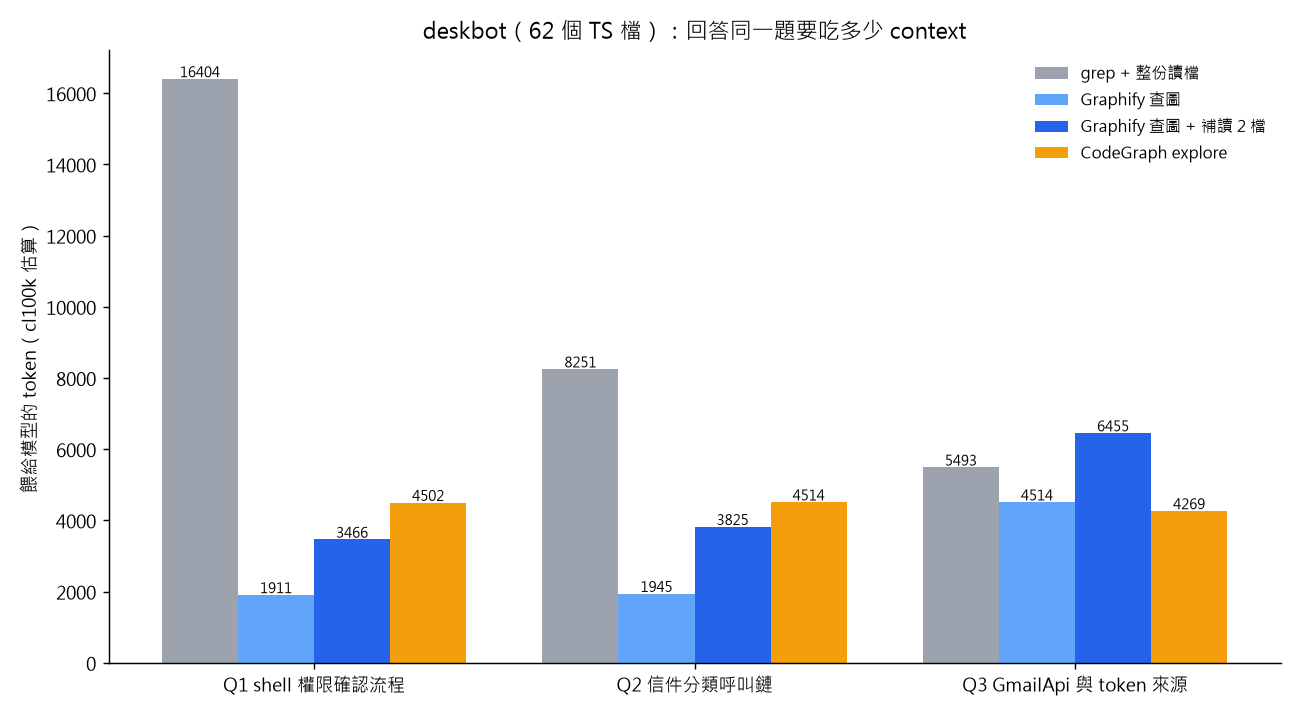
只看查圖那一步,是的。bench 腳本實際輸出如下,facts 欄依序是 grep、Graphify、CodeGraph 命中幾個關鍵符號(滿分 5):
| 題目 | grep 讀檔 | Graphify 查圖 | CodeGraph | facts |
|---|---|---|---|---|
| Q1 | 16,404 | 1,911 | 4,502 | 5/3/5 |
| Q2 | 8,251 | 1,945 | 4,514 | 5/5/5 |
| Q3 | 5,493 | 4,514 | 4,269 | 5/4/5 |
| 合計 | 30,148 | 8,370 | 13,285 |
但 facts 欄位已經露出問題:Graphify 在 Q1 只命中 3/5,Q3 命中 4/5。而且就算命中,命中的也只是名字。
🔎 為什麼還要補讀檔案?
graphify query 的輸出長這樣(Q1 節錄):
Graph: graphify-out/graph.json (781 nodes) | Traversal: BFS depth=2 | Start: ['ask()', 'tool()', 'Tool', 'shellTool', 'agent.ts', 'POSTGRES_USER'] | 143 nodes found

[!] TRUNCATED: showing 82 of 143 nodes (~2000-token budget). The answer may be among the 61 cut nodes — raise the token budget to 3461 to get all 143 (CLI: --budget 3461, MCP: token_budget=3461) or narrow the query (e.g. context_filter=['call'], or get_node for a specific symbol).

NODE ask() [src=src/server/modules/ask.ts loc=L65 community=ask.ts]
NODE tool() [src=test/agent.test.ts loc=L10 community=service.ts]
每個節點是「名稱 + 檔案 + 行號 + community」,沒有函式內容。它告訴你 classifyShell 在 permission.ts 第 45 行,但不告訴你 classifyShell 怎麼判斷一條指令是唯讀還是危險。
要回答「agent 怎麼決定要不要跳確認」,模型一定得看到判斷邏輯本身。所以我照圖上指出的位置,每題補讀 2 個關鍵檔案:
| 題目 | Graphify 查圖 | 補讀 2 檔 | 合計 |
|---|---|---|---|
| Q1 | 1,911 | 1,555 | 3,466 |
| Q2 | 1,945 | 1,880 | 3,825 |
| Q3 | 4,514 | 1,941 | 6,455 |
| 合計 | 8,370 | 5,376 | 13,746 |
Q1 還有一個查圖本身的狀況:143 個節點被 2,000 token 預算截到剩 82 個,判斷用的 confirm、READ_ONLY_COMMANDS 剛好在被截掉的那一半。同一題換個問法,這兩個又會出現,BFS 的起點受措辭影響很大。
⚖️ Graphify 跟 CodeGraph 哪個省?
CodeGraph 也是 tree-sitter 建本機圖,差別在 explore 直接回傳相關符號的原始碼。Q1 的開頭長這樣:
**Exploration: execTool classifyShell confirm risk**

Found 32 symbols across 4 files.

**Blast radius — what depends on these (update/verify before editing)**

- `execTool` (src/core/agent.ts:50) — 1 caller in `src/core/agent.ts`; tested via callers: `test/agent.test.ts`
- `classifyShell` (src/core/permission.ts:45) — 3 callers in `src/core/tools/system.ts`; tests: `test/permission.test.ts`
後面接著就是這些符號的逐字程式碼,所以不需要補讀。三題合計:
| 做法 | 三題 token 合計 | 對 grep 的減少 | 3 題 facts |
|---|---|---|---|
| grep 整份讀檔 | 30,148 | — | 15/15 |
| Graphify 只看查圖 | 8,370 | 72% | 12/15 |
| Graphify 查圖 + 補讀 | 13,746 | 54% | 補讀後齊全 |
| CodeGraph explore | 13,285 | 56% | 15/15 |
我還試了 graphify path "runAgent" "classifyShell",它回 No directed path。這個專案的 runAgent 是透過 tool.risk() 這種動態派發才呼叫到 classifyShell,靜態圖追不到這條邊。CodeGraph 的 explore 列出了 classifyShell 的 3 個 caller 和對應測試檔。
🎯 哪種題目省最多?
看單題,差距跟題目形狀有關:
- Q1(關鍵字散在很多檔):grep 命中一堆檔案,整份讀進來 16,404 token。Graphify 加補讀 3,466,少 79%。這種題目是知識圖譜最划算的場景。
- Q2(有明確呼叫鏈):8,251 對 3,825,少 54%。
- Q3(範圍本來就小):grep 只命中幾個檔,5,493 token。Graphify 查圖本身就 4,514,加上補讀變 6,455,比 grep 多 18%。
⚠️ 這次實驗的限制
- 只有 3 題、1 個專案。62 個 TS 檔算中小型,Graphify README 說專案越大省越多,這次的數字不能外推到幾千個檔的 monorepo。
- token 用 cl100k 估算,不是 Claude 的 tokenizer。三種做法用同一把尺,看相對比例可以,絕對值會跟 Claude 實際計費有落差。中文和程式碼在不同 tokenizer 下的差異,可以看 LLM token 怎麼算才準。
- facts 是關鍵字有沒有出現,不是模型實際答對與否。我沒有把三組 context 真的餵給模型評分。
- grep 基準是「整份讀檔」。實際的 Claude Code 會用
Grep拿片段、用Read指定行數範圍,花的 token 通常比整份讀少,三種做法的差距會縮小。 - 補讀 2 檔是我依圖上位置挑的。換一個 agent 來挑,可能多讀或少讀。
🛠️ 自己重跑一次
在你的專案複本上跑,不需要動 Claude Code 設定:
git clone <your-repo> /tmp/graph-bench && cd /tmp/graph-bench
python -m venv .venv && .venv/bin/pip install graphifyy tiktoken   # Windows 用 .venv/Scripts/
.venv/bin/graphify update .          # 建圖,不呼叫 LLM
.venv/bin/graphify query "how does X call Y"
.venv/bin/graphify explain "<關鍵符號>"
PyPI 套件名是 graphifyy(兩個 y)。2026-10-27 查 PyPI 最新是 0.9.96,這次實測用的是 0.9.95。
量 token 的最小做法:把每種做法的輸出存成文字檔,丟給同一個 tokenizer 數:
import sys, tiktoken
enc = tiktoken.get_encoding("cl100k_base")
for path in sys.argv[1:]:
    print(path, len(enc.encode(open(path, encoding="utf-8").read())))
重點是 Graphify 那一組要記得把「看完圖之後還得讀的檔案」一起算進去,才是回答問題的真實成本。
❓ 常見問題
Q:Graphify 建圖要花 token 嗎?
程式碼部分不用。tree-sitter 在本機解析,報告寫 Token cost: 0 input · 0 output,這次 62 個 TS 檔花 41 秒。文件、PDF、圖片的語意抽取才會呼叫模型。
Q:Graphify 的 70% 是哪裡來的數字?
我在這次測試裡量到的 72% 是「只看查圖輸出」對「grep 整份讀檔」。Graphify 的付費雲端版頁面寫的是 80%,那是廠商宣稱,我沒有測。
Q:已經裝了 CodeGraph,還要裝 Graphify 嗎?
只為了省 token 不用,這次兩者打平。兩套同時裝,Graphify 的 PreToolUse hook 和 CodeGraph 的提示都會在 Glob/Grep 前要求 agent 先查圖,會重複。想要能拿給人看的互動架構圖,或要把規格書、PDF 跟程式碼放進同一張圖時,Graphify 比較合適。
Q:Graphify 的 query 結果被截斷怎麼辦?
輸出裡會寫出需要的預算,例如 --budget 3461。也可以用 explain 查單一符號,或用 --seed 指定起點,比加大預算更省。
📚 延伸資源
- Graphify-Labs/graphify:原始碼與 benchmark 說明,2026-10-27 是 136,373 stars、Apache-2.0
- graphifyy on PyPI:套件頁與版本紀錄
- Graphify 實測:0 token 建 Claude Code 知識圖譜:安裝、指令與 6 個坑
- CodeGraph vs grep:另一套本機程式碼知識圖譜