懶人包
- Elephant-Goldfish Model(EGM,大象與金魚)是 Google 開源的 Apache 2.0 外掛,裝進 Claude Code、Codex、Antigravity 後,由看過完整對話的「大象」寫規格,再派零上下文的「金魚」subagent 只看規格挑毛病。
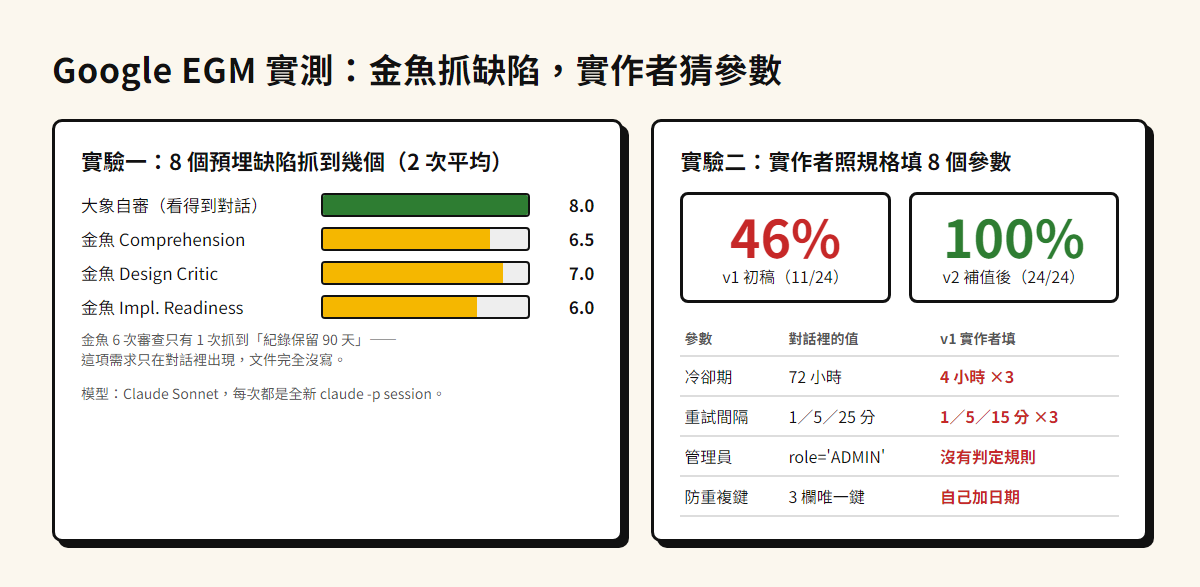
- 我在一份 LINE 推播服務的規格裡預埋 8 個缺陷:看得到對話的大象自審兩次都抓到 8/8,套 EGM 官方 persona 的金魚每次抓到 6 到 8 個。
- 金魚最常漏的是「只在對話裡講過、文件一個字都沒寫」的需求(推播紀錄保留 90 天),6 次只抓到 1 次。金魚找的是「寫不清楚」,找不到「沒寫」。
- 真正的考驗是實作者:把初稿交給 3 個全新 session 當工程師填參數,只對上 46%,冷卻期 72 小時 3 次都被填成 4 小時;照審查結果補完的 v2 是 100%。
- 不裝 plugin 也能用這個方法:另開一個全新
claude -p只餵規格、要它填實作參數,再跟你心裡的答案對一遍。
這篇的起點是 @cs2pm_ghost 在 Threads 的貼文:Google 開源了一個 AI Coding 外掛,叫 Elephant-Goldfish,要解決的狀況是「跟 AI 討論了兩小時,AI 覺得自己什麼都懂,寫出來的程式還是跟需求有落差」。我查看時有 581 個讚、391 次分享。
這個痛點我很熟,所以我沒有只讀 README,而是用 claude -p 做了兩個小實驗:金魚到底抓得到什麼?規格交出去之後,實作者會猜成什麼樣?
影片版(YouTube Shorts)
〈AI 說全懂了卻寫錯?Google 大象與金魚審規格〉
〈同一個遊戲讓 AI 做兩次:7/13 vs 13/13〉
📌 目錄
- Elephant-Goldfish(EGM)是什麼?
- 怎麼安裝到 Claude Code 和 Codex?
- 我怎麼設計實驗?
- 實驗一:金魚抓得到哪些缺陷?
- 實驗二:實作者拿到規格會猜成什麼?
- 不裝 plugin 怎麼用這個方法?
- 限制與什麼時候不用
- 常見問題
🐘 Elephant-Goldfish(EGM)是什麼?
google/elephant-goldfish-model 在 2026-09-13 建立,Apache 2.0 授權,我 2026-10-27 查時有 1,617 顆星,main 最新 commit 是 2026-10-24 的 3d0b348。README 對自己的定位是「Spec-Driven Development 的外掛」,頁尾寫明 This is not an officially supported Google product,方法論出自 Dave Rensin 的文章 Elephants, Goldfish, and the New Golden Age of Software Engineering。
兩個角色的分工:
| 角色 | 看得到什麼 | 負責什麼 |
|---|---|---|
| 🐘 大象(Elephant) | 完整對話、系統歷史、架構 | brainstorm、寫設計文件、決定怎麼修 |
| 🐠 金魚(Goldfish) | 只有規格文件和原始碼 | 用不同 persona 挑毛病 |
| 🧑💻 人 | 全部 | 拍板架構決策與取捨 |
agents/*.md,像 comprehension.md 開頭就寫「Strict Read-Only Protocol」和「Stateless Mindset (Goldfish Isolation)」,要它當成剛加入專案的新人來讀。/egm-brainstorm 的 SKILL.md 有一句:如果環境沒有 subagent 工具就停下來,因為「a review in the same context is not a Goldfish review」——同一個 context 裡自審不算金魚審查。
整套指令:
| 指令 | 做什麼 |
|---|---|
/egm-brainstorm | 還沒有文件時,用金魚群挑戰初步想法 |
/egm-draft | 逐節寫出 docs/designs/<feature>.md |
/egm-review | 多階段金魚審查:Zoom Out → Comprehension → Critic → Readiness |
/egm-review-loop | 平行派發審查 subagent |
/egm-resolve | 逐條處理審查意見,套用修正 |
/egm-drift-report | 比對已提交的規格和現在的程式碼有沒有走鐘 |
/egm-bootstrap | 替既有 codebase 由下往上補文件 |
🔧 怎麼安裝到 Claude Code 和 Codex?
指令照 README(2026-10-27 讀取):
# Claude Code
claude plugin marketplace add google/elephant-goldfish-model && claude plugin install egm@egm

# Codex
codex plugin marketplace add google/elephant-goldfish-model && codex plugin add egm@egm
Antigravity 是 agy plugin install https://github.com/google/elephant-goldfish-model。在 Claude Code 裡指令要加 /egm: 前綴,例如 /egm:egm-review docs/designs/<feature>.md。
這次我沒有安裝整個 plugin,只 clone 了 repo,把 agents/ 裡的三份官方 persona 原文餵給 claude -p。下面的數字是「EGM 的方法 + EGM 的 persona」,不是 plugin 完整五階段流程跑出來的。
🧪 我怎麼設計實驗?
情境是一個 LINE 待辦提醒推播服務。我先寫了一段大象和使用者的需求對話,裡面拍板了 8 項決策:
| 決策 | 對話裡的值 |
|---|---|
| 冷卻期 | 按「稍後提醒」後 72 小時不再推 |
| 每日摘要時區 | Asia/Taipei(伺服器是 UTC) |
| 重試 | 3 次,間隔 1/5/25 分 |
| 每人每日上限 | 5 則 |
| 管理員 | users.role = 'ADMIN' |
| 防重複 | (user_id, todo_id, notify_type) 唯一鍵 |
| 紀錄保留 | 90 天,每天凌晨 3 點清除 |
spec.md,刻意埋 8 個缺陷:冷卻期沒寫長度、重試沒寫次數與間隔、管理員沒定義、9 點沒寫時區、防重複沒寫機制、90 天保留完全沒提、每日上限前面寫 5 則後面寫 10 則,以及對話也沒討論過的 LINE 429 和封鎖處理。
所有呼叫都是全新的 claude -p --model sonnet session,評分另開 session 對照缺陷清單打分。
🔍 實驗一:金魚抓得到哪些缺陷?
| 審查者 | 第 1 次 | 第 2 次 | 總意見數 |
|---|---|---|---|
| 大象自審(看得到對話) | 8/8 | 8/8 | 17/15 |
| 金魚 Comprehension | 7/8 | 6/8 | 24/20 |
| 金魚 Design Critic | 8/8 | 6/8 | 22/20 |
| 金魚 Implementation Readiness | 6/8 | 6/8 | 22/23 |
- G6 紀錄保留 90 天:金魚 6 次只抓到 1 次(Design Critic 第 1 次)。這項需求只存在對話裡,文件一個字都沒有,零上下文的讀者無從知道它存在。
- G3 管理員怎麼判定:金魚 6 次漏 4 次。「管理員可查看所有人的紀錄」讀起來很自然,不像缺陷。
- 冷卻期、重試、時區、防重複、5 則與 10 則的矛盾、429 處理:金魚每次都有抓到。
大象自審的分數要打折看:我的 prompt 明確要它「對照對話審查」。真實情況下大象寫完文件,未必會主動回頭逐句比對兩小時的對話。
🎯 實驗二:實作者拿到規格會猜成什麼?
審查意見列了 20 多條,看起來很有收穫。但規格最後的讀者是實作者,所以我再做一個測試:開 3 個全新 session,告訴它「你是剛接手的工程師,只拿到這份文件,沒人可問,明天要交程式,文件沒寫的就照你的判斷填」,要它輸出 8 個實作參數的 JSON,再跟對話裡的真值比對。
quiz\v1_1.json: 4/8 不符=['cooldown_hours', 'retry_intervals_min', 'admin_rule', 'dedupe_key']
quiz\v1_2.json: 3/8 不符=['cooldown_hours', 'retry_intervals_min', 'admin_rule', 'dedupe_key', 'log_retention_days']
quiz\v1_3.json: 4/8 不符=['cooldown_hours', 'retry_intervals_min', 'admin_rule', 'dedupe_key']
== v1 合計 11/24 = 46%

quiz\v2_1.json: 8/8 不符=[]
quiz\v2_2.json: 8/8 不符=[]
quiz\v2_3.json: 8/8 不符=[]
== v2 合計 24/24 = 100%
v1 實作者實際填了什麼:
| 參數 | 對話裡的值 | v1 實作者填的 |
|---|---|---|
| 冷卻期 | 72 小時 | 4 小時(3 次都一樣) |
| 重試間隔 | 1/5/25 分 | 1/5/15 分(3 次都一樣) |
| 管理員 | users.role='ADMIN' | 只寫「管理員可唯讀查看」,沒有判定規則 |
| 防重複鍵 | user_id + todo_id + notify_type | 自己加上到期日或摘要日期 |
| 紀錄保留 | 90 天 | 90、180、90 |
| 時區、重試次數、每日上限 | Asia/Taipei、3、5 | 都對 |
有幾項是猜對的:時區填了 Asia/Taipei(規格是中文寫的),每日上限在 5 和 10 之間選了 5,保留天數有兩次猜到 90。這些是運氣,不是文件寫清楚了。
v2 是我照審查意見把 8 項的值全部寫進文件,加上 429 和封鎖的處理方式。3 個實作者全部 8/8。
這兩個實驗放在一起看:金魚的工作是指出「這裡沒定義」,值只能由大象或人來補。EGM 把這一步放在 /egm-resolve,由大象逐條決定要修正還是反駁,順序是對的。
🛠️ 不裝 plugin 怎麼用這個方法?
EGM 完整流程有多個審查階段、每階段都派 subagent。如果只想要「實作前抓出會被猜錯的參數」,一支腳本就夠。這是我實驗二用的 quiz.sh 精簡版:
#!/usr/bin/env bash
# 用法:bash quiz.sh <spec檔> <輸出前綴>
set -u
mkdir -p quiz
for i in 1 2 3; do
  { echo "你是剛接手的工程師,只拿到下面這份設計文件,沒人可問,明天就要交程式。請直接決定實作參數(文件沒寫就照你的判斷填,不可填未知)。"
    echo '只輸出一行 JSON:{"cooldown_hours":數字,"summary_timezone":"字串","retry_count":數字,"retry_intervals_min":[數字],"daily_limit":數字,"admin_rule":"字串","dedupe_key":"字串","log_retention_days":數字}'
    echo; cat "$1"; } | env -u CLAUDECODE claude -p --model sonnet > "quiz/${2}_$i.json" 2>/dev/null &
done; wait
用法:
- 列出這份規格裡你心裡已經有答案的參數,寫成 JSON 欄位。
- 跑
bash quiz.sh spec.md v1,3 個全新 session 平行填答,我這邊 2 分鐘內跑完。 - 逐欄比對。答錯的欄位就是規格沒寫清楚的地方,3 次答案一致但錯的優先補。
env -u CLAUDECODE 是為了在 Claude Code 裡面也能啟動獨立的 claude -p。要注意 claude -p 會載入你的全域 CLAUDE.md,所以它不是嚴格的零上下文;要更乾淨可以另開一個沒有個人設定的帳號或目錄跑。
這個做法跟我之前寫的 claudex-loop 讓 Codex 審 Claude 的計畫 是同一個思路:審查者不能跟寫的人共用 context。
⚠️ 限制與什麼時候不用
- 樣本小:實驗一每組 2 次,實驗二每份規格 3 次,只用 Sonnet。數字是方向,不是統計結論。
- 沒跑完整 plugin:只借用 EGM 三份 persona,沒有跑 Zoom Out 和
/egm-resolve;v2 是我依對話手動補的。 - 缺陷是我埋的:真實規格的缺陷分布不會這麼整齊。
- 成本:完整
/egm-review每個階段都會派 subagent,persona 越多、審查輪數越多,token 用量就越高。這次沒有量 plugin 的實際用量。
❓ 常見問題
EGM 是 Google 官方產品嗎?
repo 放在 google 組織下,README 頁尾寫明「This is not an officially supported Google product」。repo 描述是「created at Google」的開源方法與 skill 集,授權 Apache 2.0。
金魚審查和叫同一個 AI 再檢查一次有什麼不同?
差在 context。同一個 session 自審時,AI 會用對話裡的記憶把文件的空白自動補上,所以看不出缺漏。金魚只看文件,補不了,就會把空白指出來。EGM 的 brainstorm skill 在沒有 subagent 時會直接拒絕,理由就是同 context 的審查不算金魚審查。
金魚抓不到的缺陷怎麼辦?
我的實驗裡,金魚最常漏的是「只在對話講過、文件完全沒寫」的需求。這類缺漏要靠大象或人拿對話紀錄回頭比對文件,或用上面的實作者測試,看哪些參數被猜錯。
一定要裝 EGM plugin 嗎?
不用。方法的核心是「另開全新 session 只讀規格」,claude -p、Codex 或任何 subagent 都做得到。想要現成的多 persona 審查流程和 /egm-resolve 的修正流程,再裝 plugin。