懶人包
- Graphify 是 Graphify-Labs 開源(Apache-2.0)的程式碼知識圖譜工具。在 Claude Code 打
/graphify .,它用 tree-sitter 在本機把專案解析成一張「符號 + 關係」的圖,之後 AI 可以直接查圖,不必一個一個檔案 grep。- 我拿自己這個部落格 repo(80 多個程式檔)實測:建圖約 12 秒、token 花費 0、全程沒填任何 API key;
explain和path會附上檔案與行號,答案很準。- 它贏 grep 的地方在「多跳路徑」和「一個函式往外連到哪」;單純查「誰呼叫 X」時,兩邊輸出差不多大。小 repo 省下的量有限。
- 要注意:
install --project會改你的CLAUDE.md和.claude/settings.jsonhooks;query是用關鍵字比對當起點,中文問句會找不到節點。
這篇的起點是 AI懶人報在 IG 發的一支 Graphify 介紹 Reel。影片講得很快,我想知道三件事:它實際怎麼裝、圖建出來長什麼樣、在真實 repo 上到底有沒有比 grep 好用。所以我把它裝在 Windows 11 上,對這個部落格的原始碼跑了一輪。以下數字都是這次實測的輸出,廠商宣稱的部分會另外標出來。
📌 目錄
- Graphify 是什麼?
- Graphify 適合誰、不適合誰?
- Graphify 怎麼安裝?
- 建出來的圖長什麼樣?
- explain、path、query 怎麼用?
- Graphify 跟 grep 比,哪裡贏?
- Graphify 跟 CodeGraph 差在哪?
- 實測踩到的坑
- 常見問題
- 延伸資源
🧭 Graphify 是什麼?
Graphify 把一個專案的程式碼(也可以加文件、PDF、圖片)整理成一張知識圖譜:每個函式、類別、檔案是節點,imports、calls、contains、references 這些關係是邊。AI coding agent 要回答「這段程式碼跟誰有關」時,先查圖,只拿相關的那一小塊子圖,不必把整個資料夾讀進 context。
幾個關鍵事實(2026-10-22 查證):
| 項目 | 內容 |
|---|---|
| Repo | Graphify-Labs/graphify,Apache-2.0 |
| 建立時間 | 2026-04-03 |
| GitHub stars | 131,811 |
| PyPI 套件 | graphifyy(兩個 y),累計下載約 9M(pepy.tech) |
| 最新版本 | v0.9.93(2026-10-20) |
| 背景 | README 標示 Y Combinator S26 |
| 支援的 agent | Claude Code、Codex、Cursor、Gemini CLI、Aider、OpenCode 等,README 列了 20 種左右 |
- 程式碼:用 tree-sitter 做 AST 解析,README 的原話是 deterministic、no LLM、nothing leaves your machine。這段不花 token。
- 文件、PDF、圖片、影片:要做語意抽取,會用你 AI 助手的模型或你設定的 API key。這段才會花錢。
EXTRACTED(從 AST 直接抽出)或 INFERRED(推測,附信心分數),你可以分辨哪些是確定的、哪些是猜的。
🎯 Graphify 適合誰、不適合誰?
| 情境 | 建議 | 原因 |
|---|---|---|
| 中大型 repo,常問「這改了會影響誰」 | 適合 | path、affected 直接給多跳路徑,比自己一層一層 grep 省事 |
| 剛接手陌生專案,想先看全貌 | 適合 | graph.html 互動圖 + GRAPH_REPORT.md 的 god nodes 一眼看出核心 |
| 程式碼不能外流 | 適合 | 程式碼解析全在本機 |
| 幾十個檔的小專案 | 效益有限 | 我實測單跳查詢的輸出量跟 grep 差不多 |
| 想用自然語言(中文)問問題 | 不適合直接用 query | 起點是關鍵字比對符號名稱,中文問句找不到節點 |
不想讓工具改 CLAUDE.md、hooks | 先看清楚再裝 | install --project 會寫入這兩個地方 |
🛠️ Graphify 怎麼安裝?
前置需求:Python 3.10 以上,加上 uv 或 pipx。我這台是 Python 3.11.9,用 uv 裝:
uv tool install graphifyy      # 套件名是 graphifyy,指令是 graphify
graphify --version             # 我這次是 graphify 0.9.93
graphify install               # 偵測你用的 AI 助手,註冊 /graphify skill
只想裝在單一專案、不動全域設定,用 --project:
cd your-repo
graphify install --project
裝完打開 Claude Code,在專案根目錄打:
/graphify .它會產出 graphify-out/ 資料夾:
| 檔案 | 用途 |
|---|---|
graph.html | 瀏覽器打開的互動圖,可搜尋、點節點看鄰居 |
GRAPH_REPORT.md | 摘要:節點數、community、god nodes、跨檔的意外連結 |
graph.json | 圖本體,query、path、explain 都讀它 |
graphify update .。這一步只重做 AST,不呼叫 LLM。
install --project 實際改了什麼
我在測試目錄跑完 install --project,多了三樣東西:
CLAUDE.md多一段## graphify規則,要求 agent 在第一次 grep 或讀檔前先跑graphify query,改完程式碼後跑graphify update .。.claude/skills/graphify/:skill 本體。.claude/settings.json加了兩個 PreToolUse hook:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash|Grep",
        "hooks": [{ "type": "command", "command": "graphify hook-guard search", "timeout": 10 }]
      },
      {
        "matcher": "Read|Glob",
        "hooks": [{ "type": "command", "command": "graphify hook-guard read", "timeout": 10 }]
      }
    ]
  }
}
也就是說,之後 Claude Code 每次要 grep 或讀檔,都會先經過 graphify hook-guard。README 說這個 hook 預設 fail open(出錯就放行),要設 GRAPHIFY_HOOK_STRICT=1 才會真的擋。你的專案已經有自己的 CLAUDE.md 規則或 hooks 時,裝之前先 git status 一次,裝完看 diff。
🗺️ 建出來的圖長什麼樣?
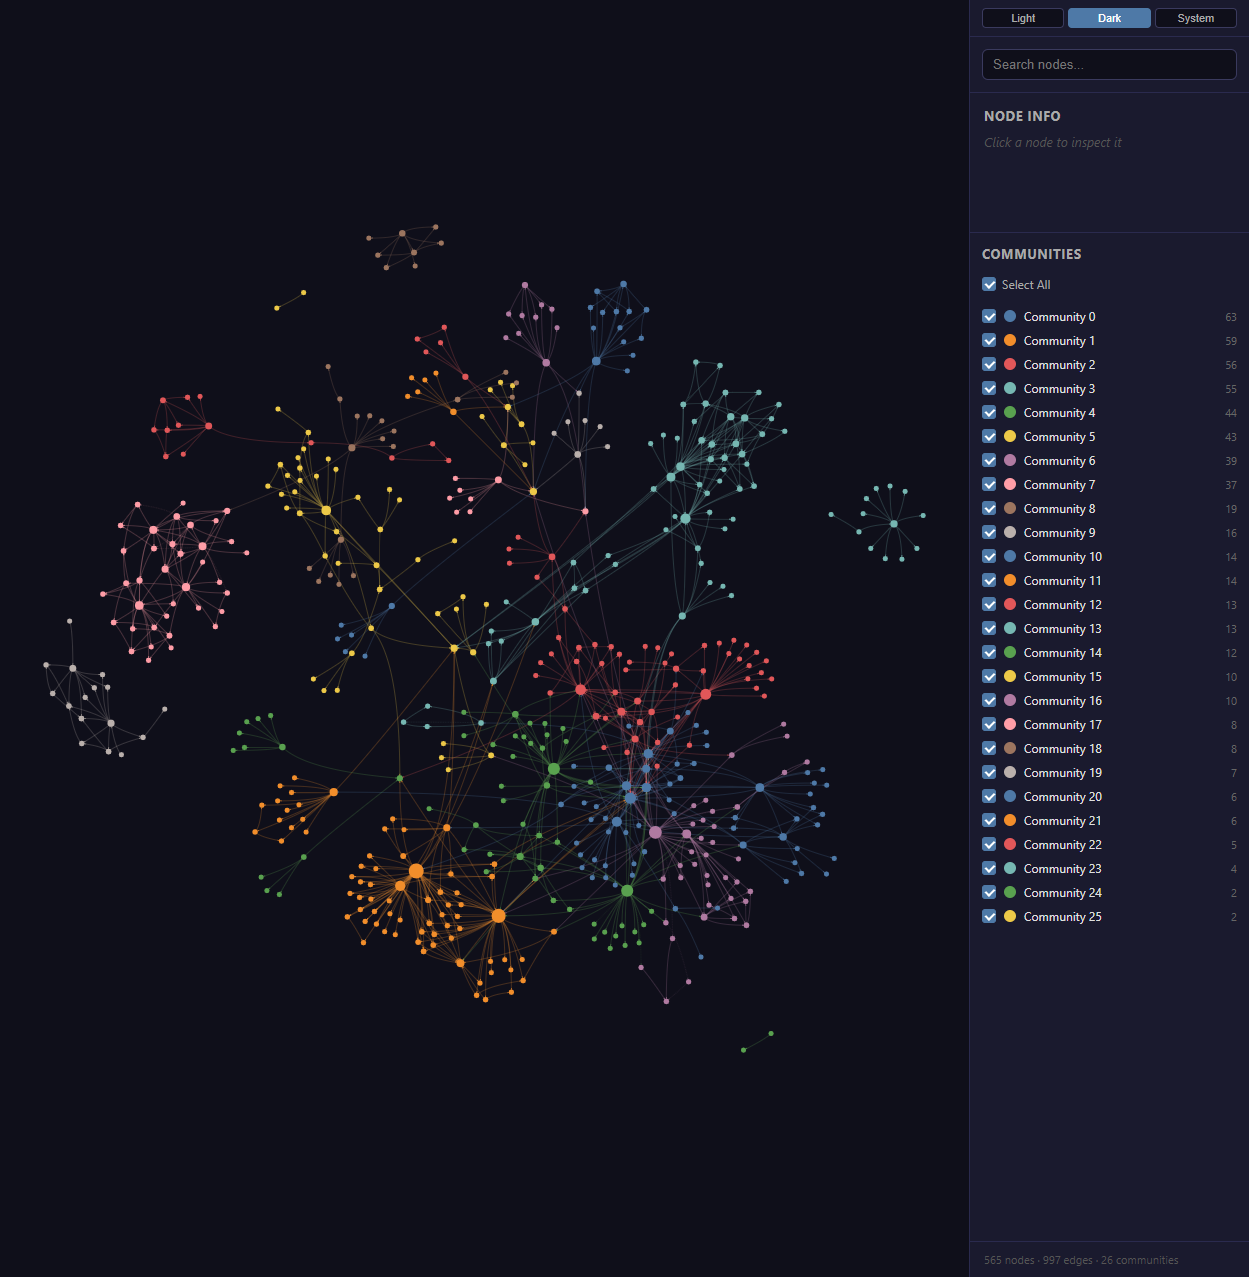
對部落格 repo 第一次建圖的結果(GRAPH_REPORT.md 摘要):
- 565 nodes · 997 edges · 26 communities (23 shown, 3 thin omitted)
- Extraction: 99% EXTRACTED · 1% INFERRED · 0% AMBIGUOUS · INFERRED: 11 edges (avg confidence: 0.85)
- Token cost: 0 input · 0 output
首次建圖約 12 秒,之後 graphify update . 重建一次 8 秒。報告裡的 god nodes(連線最多的節點)前五名是 withBase()、AdminDashboard()、getDb()、getAllPublishedPosts()、MemberGate(),跟我對這個專案的認知一致:網址前綴、後台、Firestore 讀取、會員閘門就是骨幹。
在 graph.html 搜尋 getAllPublishedPosts 並點下去,右側 Node Info 會列出它所在的檔案、community、degree 和所有鄰居:
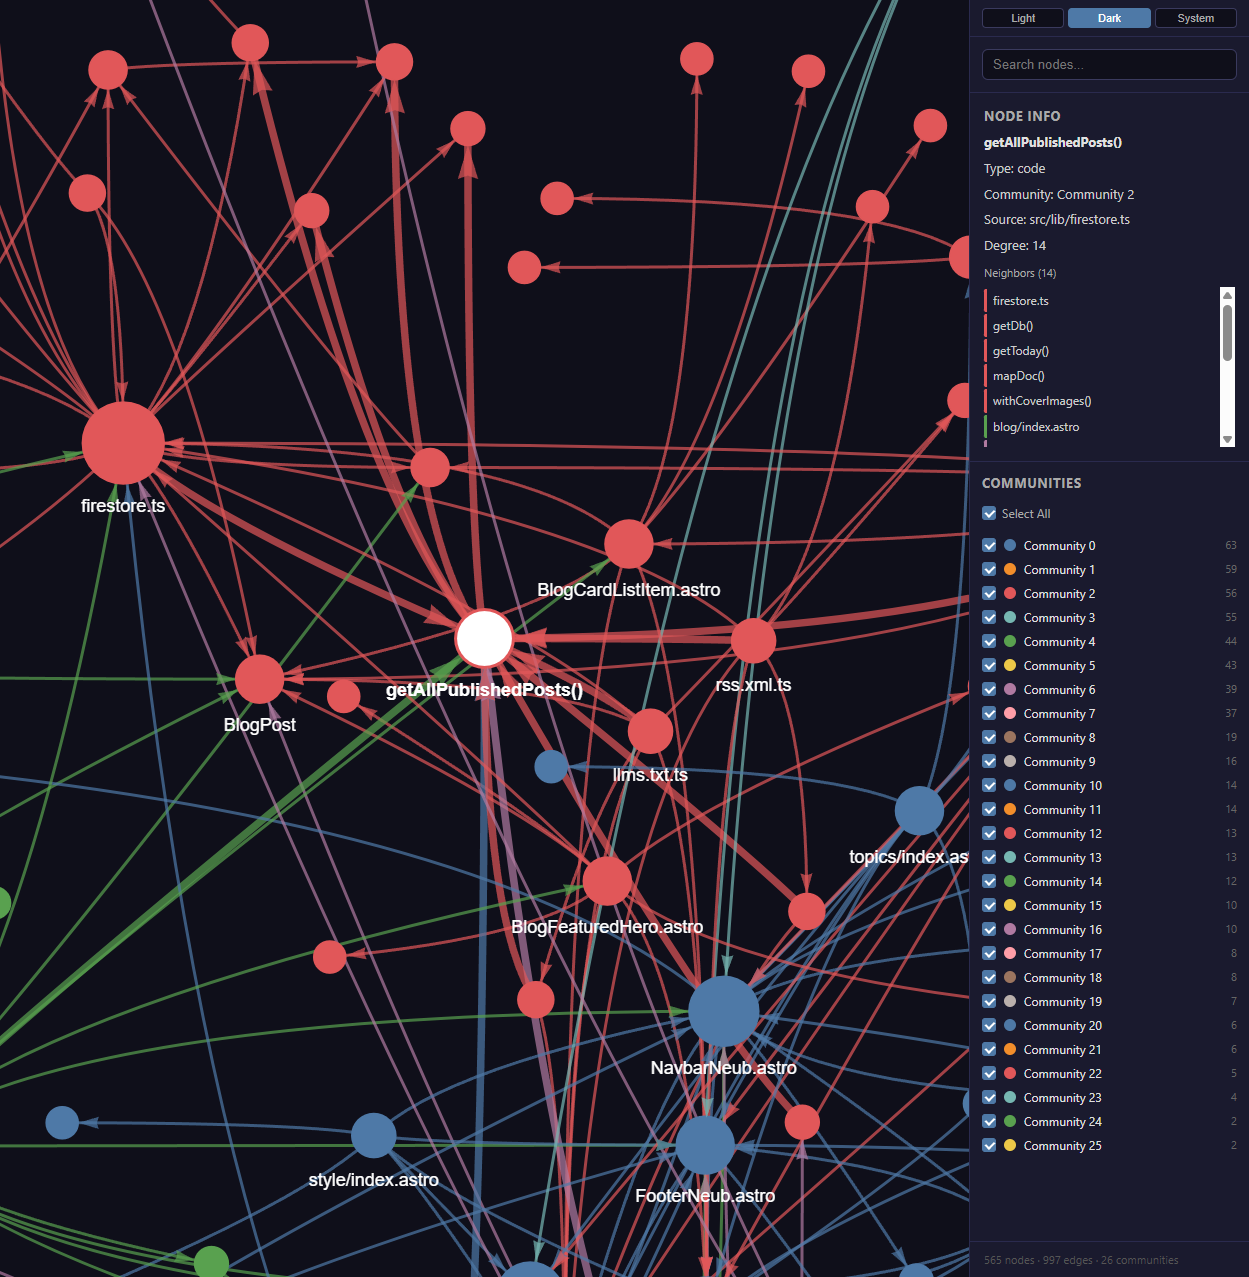
這張圖是給人看的。agent 用的是同一份 graph.json,透過下一節的指令查。
🔍 explain、path、query 怎麼用?
explain:一個節點的上下游
graphify explain "getAllPublishedPosts"Node: getAllPublishedPosts()
ID: src_lib_firestore_getallpublishedposts
Source: src/lib/firestore.ts L138
Type: code
Community: Community 2
Degree: 14
Connections (14):
<-- blog/[slug].astro [imports] [EXTRACTED] src/pages/blog/[slug].astro:L14
<-- blog/index.astro [imports] [EXTRACTED] src/pages/blog/index.astro:L22
<-- llms.txt.ts [imports] [EXTRACTED] src/pages/llms.txt.ts:L8
<-- rss.xml.ts [imports] [EXTRACTED] src/pages/rss.xml.ts:L7
--> getDb() [calls] [EXTRACTED] src/lib/firestore.ts:L144
--> withCoverImages() [calls] [EXTRACTED] src/lib/firestore.ts:L156
--> getToday() [calls] [EXTRACTED] src/lib/firestore.ts:L141
--> mapDoc() [calls] [EXTRACTED] src/lib/firestore.ts:L150
...<-- 是誰用它,--> 是它用了誰,每條都帶檔案和行號。我對照原始碼,這 14 條連線都對得上。
path:兩個符號之間怎麼連
graphify path "src/pages/rss.xml.ts::GET()" "src/lib/firestore.ts::getDb()"Shortest path (2 hops):
GET() --calls [EXTRACTED]--> getAllPublishedPosts() --calls [EXTRACTED]--> getDb()這種「RSS 端點最後怎麼碰到資料庫」的問題,用 grep 要先找 GET 呼叫了什麼、再追下一層;path 一次給完整鏈,輸出只有 111 bytes。
query:用關鍵字當起點做 BFS
graphify query "cover image"Graph: graphify-out/graph.json (565 nodes) | Traversal: BFS depth=2 | Start: ['CoverDetection', 'COVER_EXTENSIONS', 'fix-image-prefix-firestore.mjs'] | 23 nodes found
NODE CoverDetection [src=src/lib/blog-cover.ts loc=L26 community=Community 2]
NODE COVER_EXTENSIONS [src=src/lib/blog-cover.ts loc=L23 community=Community 2]
NODE fix-image-prefix-firestore.mjs [src=scripts/fix-image-prefix-firestore.mjs loc=L1 community=Community 15]
NODE ref_node_fs [src= loc= community=Community 15]
...起點找對了(blog-cover.ts),但 BFS 兩層之後把 node:fs、node:os 和一堆不相關的 script 也帶進來,這次輸出 5,987 bytes。預設 --budget 是 2000 token,圖大一點就會被截斷。想要乾淨的結果,用 --seed 指定起點節點,或直接改用 explain。
⚖️ Graphify 跟 grep 比,哪裡贏?
同一個 repo、同一個問題,我量了輸出大小(輸出越小,塞進 agent context 的 token 越少):
| 問題 | grep | Graphify | 誰比較好 |
|---|---|---|---|
誰用到 getAllPublishedPosts | grep -rn 1,088 bytes | explain 1,169 bytes | 差不多;Graphify 多了出邊(它呼叫誰) |
RSS 端點怎麼走到 getDb() | 要追兩層,每層一次 grep | path 111 bytes,一次到位 | Graphify |
| 跟封面圖有關的程式碼 | 要先猜檔名 | query 5,987 bytes,雜訊多 | 各有缺點 |
- 單跳查詢:grep 已經夠用,Graphify 的優勢是同一次輸出就帶出「上游 + 下游」。
- 多跳路徑、影響範圍:這是 Graphify 真正省事的地方,也是 grep 做不到一次完成的事。
- 省多少 token:README 寫專案越大省越多,我這個 80 多檔的 repo 省下的量有限,符合這個說法。Graphify Cloud 頁面上的「Cut agent token spend by 80%」是付費雲端版的廠商宣稱,我沒有實測。
🧩 Graphify 跟 CodeGraph 差在哪?
我自己的 Claude Code 另外裝了 CodeGraph,兩個都是「tree-sitter + 本機知識圖譜」,差別在形態:
| 面向 | Graphify | CodeGraph |
|---|---|---|
| 安裝 | Python(uv tool install graphifyy) | npm 或官方安裝腳本 |
| 給 agent 的入口 | /graphify skill + CLI,也有 graphify-mcp | MCP 工具 codegraph_explore |
| 給人看的視覺化 | 內建 graph.html 互動圖 | 沒有內建,要自己從 SQLite 撈資料畫 |
| 非程式碼素材 | 文件、PDF、圖片、影片(要 LLM) | 以程式碼為主 |
| 會不會改專案設定 | install --project 會寫 CLAUDE.md 和 hooks | 安裝時會改 MCP 設定 |
🕳️ 實測踩到的坑
坑 1:同名符號會拒答
graphify path "MemberGate" "getDb"Ambiguous: 'getDb' matches 2 nodes in different files.
src/lib/firebase-client.ts
id: src_lib_firebase_client_getdb
src/lib/firestore.ts
id: src_lib_firestore_getdb
Retry with path::symbol using one of the paths above (e.g. <path>::getDb()) or the full node id.這是刻意設計:它不幫你猜,exit code 回 3。改用 path::symbol 寫法,例如 src/lib/firestore.ts::getDb()。路徑也要寫對檔案,我寫成 MemberGate.astro 時它會提示真正定義在 MemberGate.tsx。
坑 2:path 預設是有向的
把上面的 path 反過來問(從 getDb() 到 GET()),它會回 No directed path found。邊有方向(A calls B),反方向就走不到。想忽略方向,加 --undirected。
坑 3:query 不吃中文問句
graphify query "封面" 回 No matching nodes found.(exit code 4)。起點是拿問句裡的字去比對符號名稱,程式碼裡的命名是英文,中文就對不上。用英文關鍵字,或用 --seed 直接指定節點。
坑 4:community 只有編號沒有名字
不接 LLM 時(cluster-only --no-label,或沒有任何 API key),報告裡的 community 全是 Community 0、Community 1 這種占位名稱。要有語意名稱,得跑 graphify label 並設定 LLM backend,這一步會花 token。
坑 5:.sql 檔預設沒解析
warning: 1 .sql file(s) contributed nothing to the graph because a dependency is missing: tree_sitter_sql not installed. Install it with: pip install "graphifyy[sql]"要分析 SQL 檔,安裝時加 extra:uv tool install "graphifyy[sql]"。PDF 也是同樣的模式,要 graphifyy[pdf]。
坑 6:install 會改 CLAUDE.md 和 hooks
前面提過,install --project 會寫入 CLAUDE.md 規則與兩個 PreToolUse hook。這不是 bug,是它讓 agent「先查圖再 grep」的機制。團隊共用 repo 時,這兩個檔會進 git diff,要先跟隊友講好。
❓ 常見問題
Q:Graphify 會把程式碼送到雲端嗎?
程式碼部分不會。tree-sitter 解析在本機跑,我這次全程沒設 API key,報告寫 Token cost: 0 input · 0 output。只有文件、PDF、圖片這類語意抽取,以及 community 命名,才會呼叫你設定的模型。
Q:pip 裝 graphify 裝錯套件怎麼辦?
PyPI 上的套件名是 graphifyy(兩個 y),裝完的指令才是 graphify。官方建議用 uv tool install graphifyy 或 pipx install graphifyy,pip install 可能要自己處理 PATH。
Q:Graphify 是向量資料庫或 RAG 嗎?
不是。它存的是符號和關係組成的圖,查詢是圖走訪(BFS、最短路徑),不是 embedding 相似度。每條邊標 EXTRACTED 或 INFERRED,可以分辨確定和推測的關係。
Q:程式碼改了,圖要重建嗎?
要。跑 graphify update .,只重做 AST,不花 token,我這個 repo 8 秒。也可以用 graphify watch 監看資料夾自動重建,或 graphify hook install 掛 git hook。
Q:Codex 也能用嗎?
可以。graphify install --platform codex,在 Codex 裡的觸發詞是 $graphify,不是 /graphify。
📚 延伸資源
- Graphify-Labs/graphify:原始碼、安裝說明、支援平台清單
- graphifyy on PyPI:套件頁與版本紀錄
- BENCHMARKS.md:官方 benchmark 的完整數據與重現方式
- CodeGraph vs grep:AI 讀 codebase 少 81% 工具呼叫的知識圖譜:另一套 tree-sitter 知識圖譜工具的介紹
- AI懶人報 IG Reel:這篇的起點
graphify install --project 前先 commit 一次,建完圖後拿一個「改這個函式會影響誰」的真實問題,比較 graphify path 跟你平常 grep 的步數。