懶人包
- IG 上「一天發 100 支片、月入 3000 美元」那支 Reel(@vesperfor.ugc,1,461 讚、525 則留言)是 AI 切片工具 WayinVideo 的業配,算式的兩個前提(每支 1000 觀看、每千次觀看 1 美元)影片裡都沒給出處。
- AI 切片的核心只有四步:轉錄拿逐字時間戳、LLM 挑段打分、ffmpeg 裁成 9:16、燒逐字變色字幕。
- 我用 faster-whisper 1.1.1、claude -p(Haiku)、ffmpeg 8.0 寫了 184 行 Python 重做主幹,4 分 7 秒的 NASA 影片跑 3 分 49 秒,產出 3 支 29~35 秒直式短片,三段都從「迷思 4、3、1」開頭、講完才收。
- 付費工具多做的是臉部追蹤裁切、排程發文、多平台帳號串接;只要「長片自動挑段+字幕」,自己寫就夠。
- 拿別人的片大量切來衝量有風險:YouTube 2025-07-15 把「重複內容」政策更名為「不真實內容」,重複使用他人內容另有規範;切自己的課程、直播、訪談才是正確用法。
最近在 IG 看到一支 43 秒的 Reel(2026-10-15 發佈):前 15 秒借辯論節目的畫面喊「沒人有時間一天發 100 支片」「AI 幫你做」,接著算給你聽——100 支、每支 1000 觀看、一天 100 美元、一個月 3000 美元。後 28 秒是實機操作:複製 YouTube 連結、貼進 WayinVideo、AI 切出一排短片並打上 89~93 分、改字幕樣式、連社群帳號排程自動發。結尾一句「懶得找的話在下面留言,我直接傳給你」。
貼文文案只有「原來他們是這樣做的 #wayinvideo」,帳號名稱帶 ugc,hashtag 是品牌名,這是一支業配。我比較在意的是另一件事:畫面上那台「貼連結就出一排短片」的機器,拆開來到底有多少東西? 所以我在本機重做了一版。
AI 切片工具在做什麼?
照 WayinVideo 官方說明中心〈How to use AI Clipping〉的描述,流程是上傳影片或貼支援的連結、選語言與片段長度(短、中、長三檔)、開始處理、檢查產出。每段會有一個 Viral Score,付費方案再拆成 hook、故事結構、價值、互動、觸及等細項;編輯器提供修頭尾、改字幕、AI Reframe 改比例、加 B-roll 與音樂、做縮圖,最後匯出或直接發布到社群。
把介面拿掉,背後是一條很短的管線:
真正要「AI」的只有「LLM 挑段」這一步:從幾十句逐字稿裡挑出能獨立成立、開頭有鉤子的連續段落。其餘都是轉錄模型和 ffmpeg 的老本行。
「一天 100 支、月入 3000 美元」的算式成立嗎?
影片裡的數字是 100 支 × 1000 觀看 → 一天 100 美元 → 一個月 3000 美元。換算回去,它假設每支片穩定拿到 1000 次觀看,而且每千次觀看付 1 美元。這兩個前提影片都沒有交代來源,也沒說錢是誰付的。
付錢的人比較可能是「切片活動」:創作者或品牌提供素材和規則,切片者按每千次有效觀看領錢,WayinVideo 自己也在 Notion 開過這類活動頁。賣切片工具的廠商 Clippie 在〈How to Make Money With Whop Clipping in 2026〉裡也寫「輕鬆月入一萬美元」不實、起步收入很低——這是廠商內容,我沒有獨立驗證它的數字,只拿來當「連賣工具的人都不敢這樣保證」的參考。
這支 Reel 留言數高,主要來自結尾的「留言就私訊連結」:我打開留言區,幾乎都是一個 🙌。互動數是漏斗設計出來的,跟工具好不好用是兩回事。
我怎麼用 184 行 Python 重做 AI 切片?
目標很單純:輸入一支橫式長片,輸出 N 支 1080×1920 的直式短片,每支有中文標題和逐字變色字幕。
| 步驟 | 工具 | 這版的做法 |
|---|---|---|
| 轉錄 | faster-whisper 1.1.1(small、CPU int8) | word_timestamps=True 拿每個字的起訖秒數,開 VAD 濾掉靜音 |
| 切句 | Python regex | 字尾是 . ! ? 。!? 就斷句 |
| 挑段 | claude -p --model haiku | 餵編號逐字稿,要它回 JSON:起訖句、分數、中文標題、理由 |
| 備援 | 規則評分 | LLM 沒回 JSON 時,用問句與數字密度粗估,貪婪挑不重疊段落 |
| 輸出 | ffmpeg 8.0 | 模糊放大當底、原畫置中,再燒 ASS 字幕 |
pip install faster-whisper、ffmpeg 在 PATH 上、已登入的 Claude Code CLI(我這次是 2.1.317)。跑法:
python -I clipper.py input/blackholes.mp4 out --clips 3挑段的 prompt 怎麼寫?
這段是整支程式唯一需要判斷力的地方。我給 LLM 的限制有四個:段落要連續、長度 15~45 秒、開頭要有鉤子、脫離上下文也看得懂,並且只回 JSON。
PROMPT = """You are a short-form video editor. Below is a numbered transcript of a long video
(index, start-end seconds, sentence). Pick the {n} best self-contained segments for TikTok/Shorts.
Each segment = consecutive sentences, total length {mn:.0f}-{mx:.0f} seconds, must start with a strong hook
and make sense without context. Segments must not overlap.
Score each 0-100 on viral potential. Reply with ONLY a JSON array, no prose:
[{{"start": <first sentence index>, "end": <last sentence index>, "score": <int>,
"title": "<punchy Traditional Chinese title, max 14 chars>", "reason": "<Traditional Chinese, one sentence>"}}]
"""
讓 LLM 回「句子編號」而不是「秒數」是刻意的:秒數由轉錄時間戳換算,LLM 不會切在半個字中間,也不會編出不存在的時間點。
直式畫面和字幕怎麼做?
橫式 16:9 硬裁成 9:16 會丟掉大半畫面,我先用最保守的做法:同一支影片放大、模糊、壓暗當背景,原畫等比縮到 1080 寬置中,再把字幕燒上去。
vf = (
    "[0:v]split[a][b];"
    "[a]scale=1080:1920:force_original_aspect_ratio=increase,crop=1080:1920,"
    "boxblur=30:3,eq=brightness=-0.25[bg];"
    "[b]scale=1080:-2[fg];[bg][fg]overlay=(W-w)/2:(H-h)/2,subtitles=clip_1.ass"
)
字幕用 ASS 格式,三個字一組,正在講的那個字變黃。每個字的起訖時間直接來自 faster-whisper 的 word timestamps,所以不用另外對嘴。頂部標題用 LLM 給的中文標題,整段常駐。
實測結果:三段都切在完整的段落上
素材我用 NASA ScienceCasts〈Shedding Light on Black Holes〉,取自 images.nasa.gov(NASA 媒體使用規範寫明其影像、音訊、影片在美國一般不受著作權保護),長度 4 分 7 秒、1280×718。這支片的結構是「迷思 1~5」逐條破解,正好拿來檢查 AI 會不會切在半句。
[1/4] 轉錄中…
      語言=en 句數=33 字數=526
[2/4] AI 挑精華…
[3/4] 輸出 9:16 短片…
      clip_1.mp4   174.7- 203.7s  score=92  掉進黑洞就出不來?不對
      clip_2.mp4   139.2- 173.9s  score=90  太陽換黑洞,行星照轉
      clip_3.mp4    40.7-  70.8s  score=88  黑洞不一定是黑的
[4/4] 寫結果
整趟 3 分 49 秒,大部分時間花在 CPU 轉錄;挑段那一步是一次 Haiku 呼叫。ffprobe 確認三支都是 1080×1920,長度 29.07、34.80、30.10 秒。
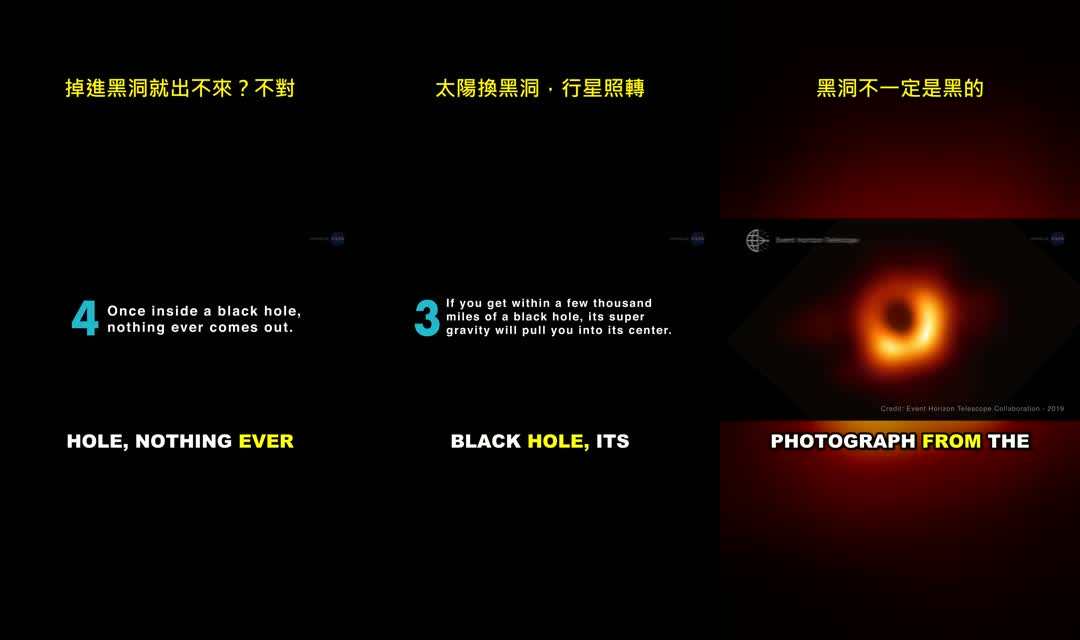
逐段對照逐字稿:
| 短片 | 開頭句 | 收尾 | LLM 給的理由 |
|---|---|---|---|
| clip_1(92 分) | Myth 4 Once inside a black hole, nothing ever comes out. | 霍金輻射讓黑洞蒸發 | 推翻「進了黑洞就逃不出」,有反差感 |
| clip_2(90 分) | Myth 3 If you get within a few thousand miles… | 太陽換成同質量黑洞,行星照常公轉 | 用假想實驗說明黑洞不會吞噬一切 |
| clip_3(88 分) | Myth 1 All black holes are black. | 吸積盤是扁平的塵埃氣體盤 | 用第一張黑洞照片開門見山 |
付費工具多做了什麼?什麼時候值得付錢?
對照 WayinVideo 官方說明列的功能,我這版沒做的有:
- AI Reframe/臉部追蹤裁切:我只做模糊底置中。真人訪談、Podcast 這類畫面,主講者在左右兩側時,追臉裁切的效果會好很多。
- 排程與多平台發布:要串各平台 OAuth 和上傳 API,是苦工不是技術難題。
- 編輯器:修頭尾、換字幕樣式、加 B-roll 和音樂。
- 細項評分:hook 強度、故事結構等拆分(付費方案才有)。
這套東西不適合拿來做什麼?
拿別人的影片大量切片、一天發 100 支衝流量,風險在平台規則。YouTube 營利政策頁寫明 2025-07-15 把「repetitious content」更名為「inauthentic content」,針對大量製造、套版的內容;另外「reused content」指重新利用 YouTube 或其他來源上已有的內容,政策本身沒變(YouTube 頻道營利政策)。切片活動是原創作者授權的,但授權只解決著作權,不保證你的頻道符合營利規範。
這版 POC 的已知限制也一併列出:
- 字幕是「三個字一組」,這個規則只適合英文;中文語音要改成按詞斷句,不然會在詞中間斷行。
- 只用標點切句,轉錄模型漏標點時,一句會很長,挑段的顆粒就變粗。
- 沒有臉部追蹤,真人畫面主體偏一邊時會很小。
- 素材是英文旁白配圖表,對 LLM 來說結構很清楚;閒聊型直播的段落邊界模糊得多,挑段品質我還沒測。
下一步:切自己的長片
我會把這支程式接到自己的 YouTube Shorts 上傳流程,素材換成自己的課程錄影:中文語音、真人畫面,正好補上「中文斷詞字幕」和「臉部追蹤裁切」兩個缺口。你如果手上有自己的長片,可以照上面的表格自己組一次;轉錄模型的取捨可以參考我之前寫的〈WhisperX 逐字時間戳與說話者分離〉和〈whisper.cpp vs WhisperX〉。