懶人包
- 用 Claude 剪片,Claude 讀的是帶時間戳的逐字稿,動手剪的是 ffmpeg;我這版由 Claude Code 寫好管線,執行時不呼叫任何 LLM 或付費 API。
- 5 步做成一支 178 行的 Python:收素材 → faster-whisper 逐字時間軸 → 剪空白 → 燒繁中字幕 → 配樂自動閃避。
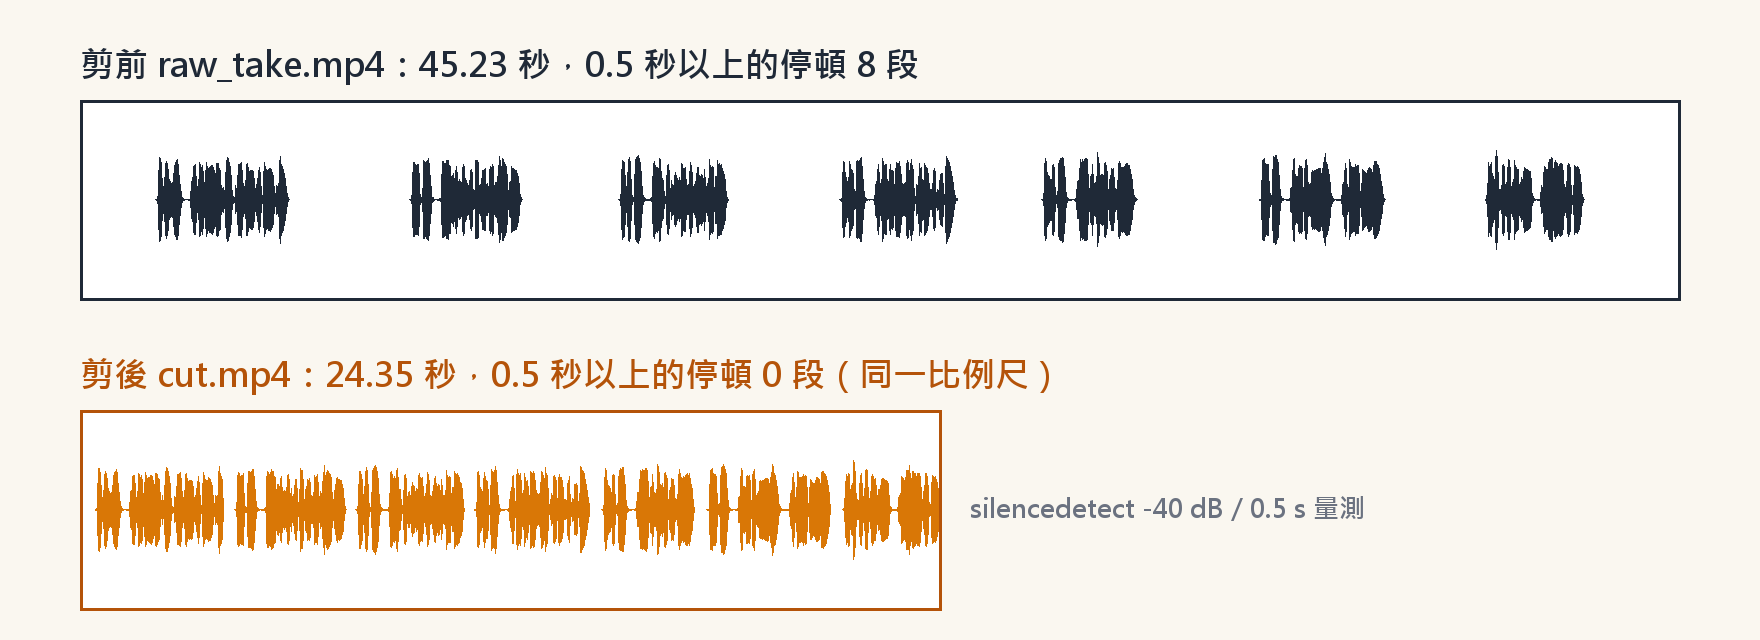
- 實測 45.23 秒口播剪成 24.35 秒,0.5 秒以上的停頓從 8 段剩 0 段,RTX 4070 上整條跑 2 分 10 秒(含載入模型)。
- 字幕要過兩道修正:OpenCC 轉繁體,再用專有名詞表把 Whisper 聽成「Cloud Code」的地方改回「Claude Code」。
- 背景音樂用 sidechaincompress 讓人聲壓音樂,講話時音樂低約 14 dB,成品響度 -14.0 LUFS。
- 這套只剪靜音,不剪「嗯、那個」和重講;要剪贅字就換成讓 LLM 讀逐字稿決定剪點的 video-use。
2026-11-01,IG 帳號 @aicreator_dae 發了一支 Reel:「5 步,從空文件夾到一支完整的 Reel,剪空白、上字幕、配音樂交給工具,你只負責品味」。具體做法要留言「editor」才拿得到。
我把這 5 步照字面做成一支 Python 管線,在自己的 Windows 電腦上跑完,下面是每一步的程式、參數和量測結果。
用 Claude 剪影片,Claude 實際做哪一段?
Claude 不看影格。能用 Claude 剪片的方案,共通做法是先把聲音轉成帶時間戳的逐字稿,Claude 讀文字、決定哪幾段要留,再把決定寫成 ffmpeg 指令。video-use 的 README 也是這樣描述:LLM 讀的是轉錄稿,不是影片。
這次的分工是:
| 角色 | 做什麼 |
|---|---|
| Claude Code | 寫管線、挑參數、看量測結果後修 bug(字幕簡體、斷行、專有名詞) |
| faster-whisper | 把聲音轉成帶時間戳的分段逐字稿 |
| ffmpeg | 剪接、燒字幕、混音、響度正規化 |
| 你 | 決定停頓留多長、字幕風格、配哪首歌 |
要準備什麼?
我實際跑的環境:
| 項目 | 版本 |
|---|---|
| 作業系統 | Windows 11 |
| Python | 3.11.9 |
| ffmpeg | 8.0(gyan.dev full build,含 libass 字幕濾鏡) |
| faster-whisper | 1.1.1,模型 mobiuslabsgmbh/faster-whisper-large-v3-turbo |
| OpenCC | opencc-python-reimplemented 0.1.7 |
| GPU | NVIDIA RTX 4070(CUDA,float16) |
pip install faster-whisper==1.1.1 opencc-python-reimplemented==0.1.7
ffmpeg -version   # 確認有裝,且是 full build
測試素材是我用 edge-tts(zh-TW-HsiaoChenNeural)合成的 7 句口播,句間塞 1.5 到 2.6 秒的停頓,做成 1080×1920 直式影片,左上角燒原始時間碼,剪完一看就知道每一格來自原片哪一秒。
5 步怎麼做?
第 1 步:把素材丟進空資料夾
管線只吃一個資料夾,拿裡面第一支 .mp4/.mov/.mkv。找不到就直接結束,不做任何猜測。
第 2 步:產生逐字時間軸
model = WhisperModel("mobiuslabsgmbh/faster-whisper-large-v3-turbo",
                     device="cuda", compute_type="float16")
segments, _ = model.transcribe(str(video), language="zh", word_timestamps=True,
                               vad_filter=True, initial_prompt="以下是繁體中文的口播。")
cc = OpenCC("s2twp")
initial_prompt 寫了繁體,第一版輸出還是簡體,而且把「Claude Code」聽成「Cloud Code」。所以轉錄後固定再走兩道:OpenCC s2twp 轉台灣用語繁體,再套一張專有名詞表:
GLOSSARY = {"Cloud Code": "Claude Code", "Cloud": "Claude", "品位": "品味"}這張表是整條管線最值得自己維護的東西。你常講的產品名、人名,Whisper 聽錯一次就加一行。
第 3 步:依講話段剪掉空白
每一段講話前後各多留 0.12 秒(--pad),兩段之間的空隙小於 0.35 秒(--gap)就合併,不切:
def keep_ranges(segs, total, gap, pad):
    ranges = []
    for s in segs:
        a, b = max(0.0, s.start - pad), min(total, s.end + pad)
        if ranges and a - ranges[-1][1] <= gap:
            ranges[-1] = (ranges[-1][0], b)
        else:
            ranges.append((a, b))
    return ranges
剪接用一個 filter_complex 做完:每段 trim/atrim,音訊頭尾各加 20 ms 淡入淡出,最後 concat。淡入淡出是為了避免接點出現「啪」一聲。
第 4 步:字幕改寫到剪後時間,燒進畫面
Whisper 的時間戳是原片時間,剪完之後全部錯位,要先換算:
def remap(t, ranges):
    """原始時間 → 剪接後時間"""
    acc = 0.0
    for a, b in ranges:
        if t < a:
            return acc
        if t <= b:
            return acc + t - a
        acc += b - a
    return acc
第一版把整句塞進一條字幕,直式畫面太窄,「Whisper」被拆成「Whispe/r」兩行。改成依逗號切短句,每句的時間按字數比例分給它,排版就正常了。燒字幕用 ffmpeg 的 subtitles 濾鏡加 force_style,字型微軟正黑體、白字黑框。
第 5 步:配樂自動閃避,響度拉到 -14 LUFS
人聲複製一份當 sidechain 的觸發訊號,講話時壓低音樂,停頓時放回來:
[0:a]asplit=2[voice][key];
[1:a]aformat=channel_layouts=stereo,volume=0.6,afade=t=in:d=1,afade=t=out:st=...:d=1.5[bg];
[bg][key]sidechaincompress=threshold=0.02:ratio=10:attack=20:release=300[ducked];
[voice]aformat=channel_layouts=stereo[vs];
[vs][ducked]amix=inputs=2:duration=first:normalize=0,loudnorm=I=-14:TP=-1.5:LRA=11[a]
amix 一定要加 normalize=0,不然 ffmpeg 會把兩軌各自減半,人聲一起變小。沒帶 --music 時,管線會用 aevalsrc 合成一段和弦當示範配樂。
實際跑出來的結果
python poc/reel_pipeline.py raw out[1/5] 素材 raw_take.mp4 45.23s
[2/5] 逐字稿 7 段
[3/5] 剪空白 保留 7 段 → 24.35s
[4/5] 字幕 subs.srt
[5/5] 輸出 out\final.mp4 24.35s
real 2m10.031s成果用 ffmpeg 自己的分析濾鏡逐項量:
| 驗證項目 | 量法 | 結果 |
|---|---|---|
| 長度 | ffprobe | 45.23 秒 → 24.35 秒 |
| 停頓 | silencedetect=n=-40dB:d=0.5 | 原片 8 段 → 成品 0 段 |
| 字幕 | 讀 subs.srt | 15 條,全繁體,Claude Code 拼對 |
| 音樂閃避 | 同一組閃避濾鏡套在原片,用 volumedetect 量音樂軌 | 停頓時 -27.5/-27.4 dB,講話時 -41.4/-41.6 dB |
| 響度 | ebur128 | -14.0 LUFS |
| 規格 | ffprobe | H.264 1080×1920、AAC |
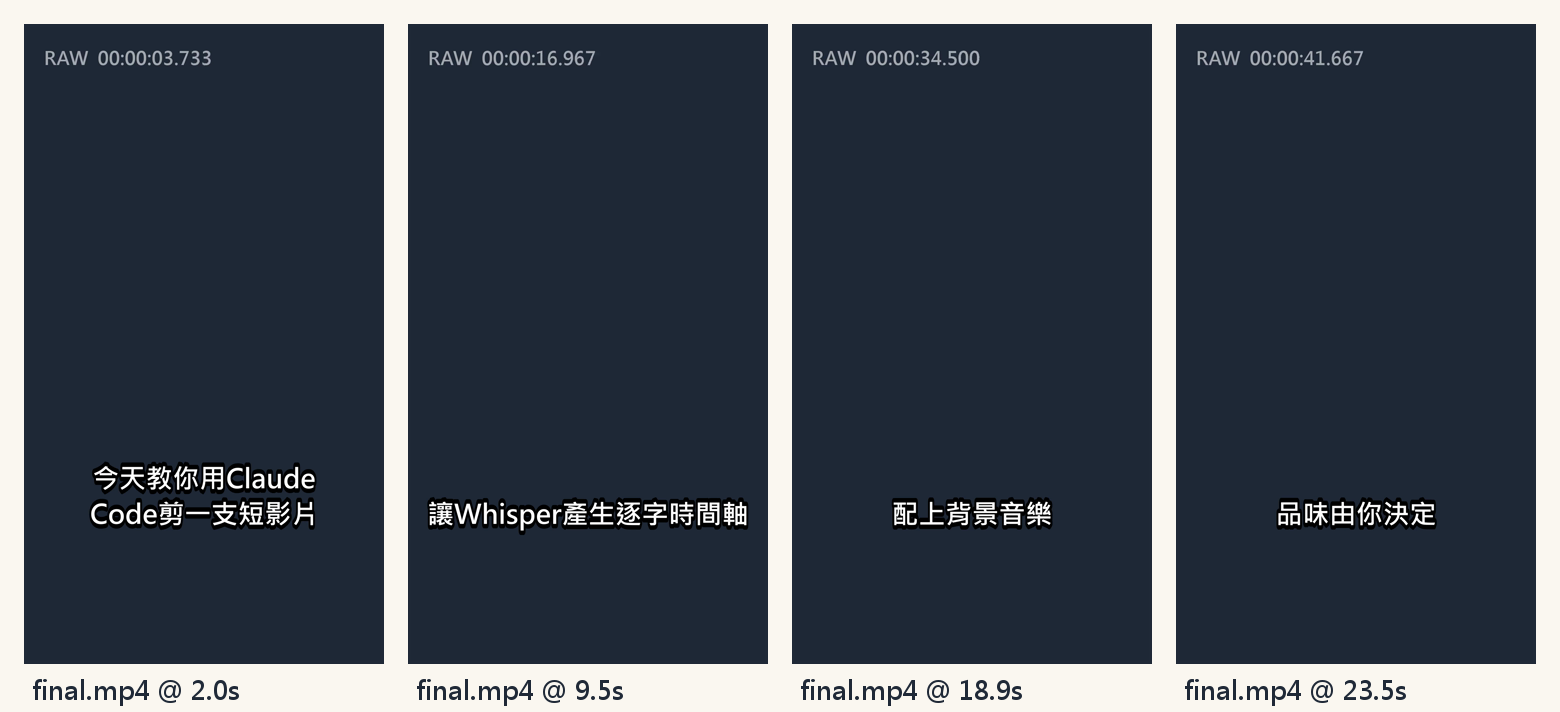
下圖是成品的四個時間點。左上角燒的是原片時間碼:成品第 18.9 秒顯示原片 34.5 秒,到這一格為止已經剪掉 15.6 秒的停頓。
第一次跑完抓到哪些錯誤?
管線第一次跑完,成品看起來能播,逐項檢查才發現三個問題:
| 問題 | 怎麼發現 | 修法 |
|---|---|---|
| 字幕是簡體 | 讀字幕檔 | initial_prompt 不夠,轉錄後固定跑 OpenCC s2twp |
| 「Claude Code」變成「Cloud Code」 | 讀字幕檔 | 專有名詞表 GLOSSARY |
| 「Whisper」被拆成「Whispe/r」兩行 | 抽 4 格畫面看 | 依逗號切短句,時間按字數分配 |
subs.srt、抽幾格畫面看。
這套管線的限制在哪?
- 只剪靜音,不剪贅字。 「嗯、那個」、講錯重來,聲音都不是靜音,第 3 步看不出來。要剪這些,得讓 LLM 讀逐字稿決定剪點,這正是 video-use 那一層。
- 素材是 TTS。 合成語音句子乾淨、停頓整齊,真人口播的呼吸聲和背景噪音會讓 VAD 分段變碎,
--gap和--pad可能要重調。 - 字幕時間按字數比例分配。 沒用到逐字時間戳,長句可能差 0.1 到 0.3 秒。
- 字型寫死微軟正黑體。 要在 macOS/Linux 跑,改
FONT常數。 - 轉錄吃 GPU。 沒有 CUDA 就把
device改成cpu、compute_type改成int8,速度會慢很多。
什麼時候該用別的工具?
| 需求 | 工具 | 代價 |
|---|---|---|
| 只想去掉停頓 | auto-editor,auto-editor video.mp4 一行 | 依音量判斷,不產字幕 |
| 剪贅字、重講、調色、加動畫 | video-use,裝成 Claude Code skill | 需要 ElevenLabs API key(轉錄用 Scribe) |
| 剪空白+繁中字幕+配樂,全部本機 | 本文這支管線 | 自己維護專有名詞表與參數 |
延伸資源
- 原始 Reel:@aicreator_dae 的 5 步剪片 Reel
- browser-use/video-use:讓 LLM 讀逐字稿剪贅字、重講,MIT 授權
- auto-editor:只依音量剪掉靜音,Unlicense
- faster-whisper:本文第 2 步用的轉錄引擎
- 轉錄想用 CPU 跑:whisper.cpp 本機語音轉文字
- 需要逐字時間戳和語者分離:WhisperX 實測
- 剪好之後檢查開場留不留得住人:HookAce 與 Hook6 的開場評分