懶人包
- Daon&Lui 2026-11-07 發的巨大貓地鐵 Reel,2026-11-09 有 18.2 萬讚、275 則留言,讚數是帳號 5.33 萬粉絲的 3.4 倍。
- 這支短片的笑點一格就懂:巨大動物走進通勤畫面,旁邊的人照常滑手機。
- 我在 RTX 4070 12GB 用 ComfyUI 跑 Wan2.2,做原創的列車長帽巨兔:首幀每張 30–40 秒,5 秒影片 220 秒算完,輸出 480×832、81 幀。
- 同一個模型測了 3 種提示寫法:描述身高的版本只做出半人高,寫明相對比例會變大但臉不清楚,改成「畫面裝不下」的構圖效果最好。
- 成品的帽子和背景路人都穩定,但巨大感有一部分來自貼近廣角鏡頭,兔子也沒有走上軌道,要上架還得補放大和音效。
- 帳號主頁自稱 Higgsfield Creative Partner,官方聯盟計畫的抽成上限是 25%、最長 12 個月;這個帳號實際拿多少查不到。
Instagram 上有一支短片:地鐵月台上,一隻戴青蛙帽的巨大貓沿著軌道走過來,前景的女生低頭滑手機。文案只有一句 POV: Just another normal day on the subway,再標註 Made with @higgsfield.ai。
我想回答兩個問題:這種鏡頭用自己的顯卡做得出來嗎?一個 5 萬粉的 AI 帳號,靠什麼把這件事變成生意?第一題我實際跑了一次,第二題查了官方條款。
這支巨大貓 Reel 為什麼會紅?
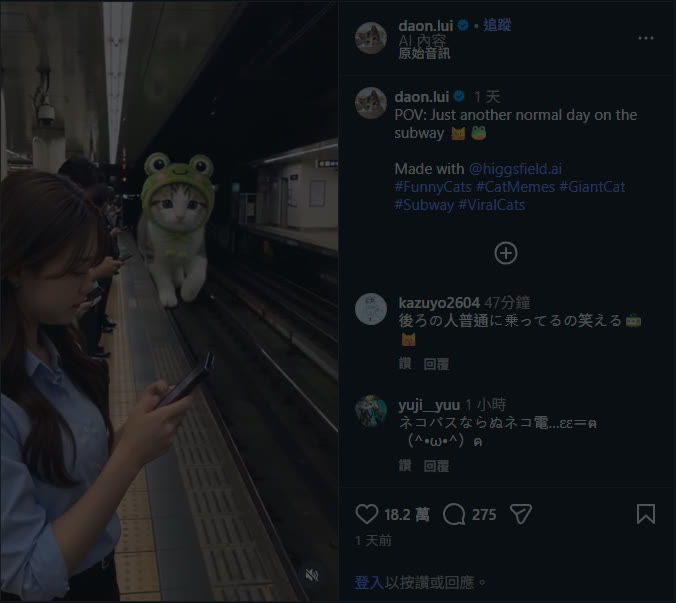
截圖來自 原始 Reel 的公開頁面,2026-11-09 未登入狀態。頁面標著「AI 內容」和「原始音訊」。原片需要登入才能下載,所以下面的鏡頭分析只根據這張畫面和看得到的留言,沒有逐格看完整支影片。
| 項目 | 2026-11-09 讀到的數字 |
|---|---|
| 帳號 | daon.lui,已認證 |
| 粉絲 | 5.33 萬 |
| 這支 Reel | 18.2 萬讚、275 則留言 |
| 讚數/粉絲 | 3.4 倍 |
| 讚數/留言 | 約 662 比 1 |
畫面的設計可以拆成三層:
- 一格就懂:巨大動物和通勤族放在同一個畫面,不用對白,也不用看前後文。
- 笑點在旁人:看得到的留言有一則寫「後ろの人普通に乗ってるの笑える」,意思是後面的人照常搭車太好笑。
- 像隨手拍:直式、手機視角,加上 POV 文案,有偽紀錄的感覺。
用 Wan2.2 在本機怎麼做這種鏡頭?
我不重做對方的貓和青蛙帽,只借「巨大動物+地鐵+路人無感」這個格式,角色換成戴列車長帽的白兔。
| 項目 | 實測環境 |
|---|---|
| 顯卡 | RTX 4070 12GB |
| 軟體 | ComfyUI 0.3.71,走本機 API http://127.0.0.1:8000 |
| 首幀模型 | wan2.2_ti2v_5B_fp16 |
| 影片模型 | wan2.2_i2v_high_noise_14B_fp8_scaled、wan2.2_i2v_low_noise_14B_fp8_scaled |
| 加速 LoRA | wan2.2_i2v_lightx2v_4steps_lora_v1 的 high/low 兩個檔 |
"7": {"class_type": "Wan22ImageToVideoLatent", "inputs": {
    "vae": ["3", 0], "width": 704, "height": 1280, "length": 1, "batch_size": 1}},
"8": {"class_type": "KSampler", "inputs": {
    "model": ["4", 0], "seed": seed, "steps": 30, "cfg": 5.0,
    "sampler_name": "uni_pc", "scheduler": "simple",
    "positive": ["5", 0], "negative": ["6", 0],
    "latent_image": ["7", 0], "denoise": 1.0}},
選好首幀再丟 i2v 14B,高噪和低噪模型各跑 2 步,共 4 步,輸出 480×832、81 幀、16 fps。Wan2.2 的 12GB 設定與 LoRA 接法,我在 RTX 4070 跑 Wan 2.2 I2V 那篇 寫得比較完整。
| 步驟 | 實測耗時 | 結果 |
|---|---|---|
| 第二輪首幀 4 張 | 每張 30–40 秒,合計 140 秒 | 全部 success |
| 影片生成 | 220 秒 | h264、480×832、81 幀、5.06 秒、936 KB |
怎麼讓 AI 把動物畫得夠巨大?
這是整個流程最難的一步。同一個模型,我測了 3 種寫法。
第一種直接描述身高,提示寫 an enormous fluffy white rabbit as tall as a subway train。4 張首幀的兔子都不夠大,選用的那張約半人高,站在月台上。影片本身是穩的,只是看起來像一隻大兔子。
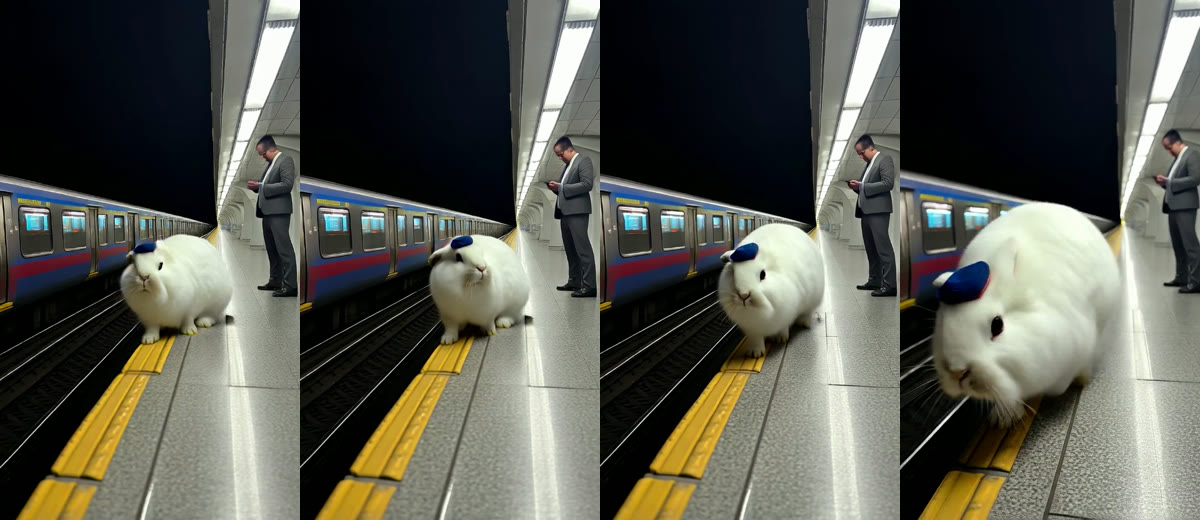
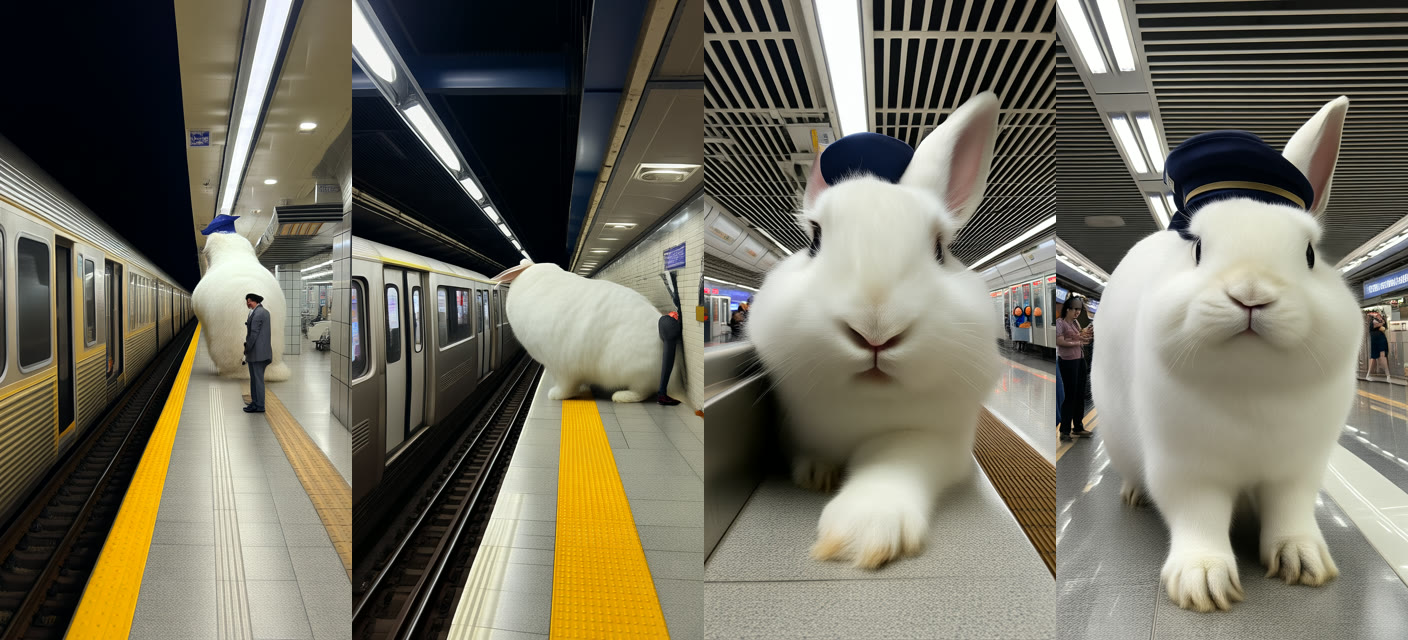
後兩種我各跑 seed 11 和 22,下圖左邊兩張是寫明相對比例,右邊兩張是畫面裝不下的構圖。
| 寫法 | 提示重點 | 結果 |
|---|---|---|
| 描述身高 | as tall as a subway train | 約半人高,尺寸指令幾乎沒生效 |
| 相對比例 | back touching the station ceiling、head far bigger than the man's whole body | 體型明顯變大,seed 11 看不到臉,seed 22 的頭埋進陰影 |
| 畫面裝不下 | too large to fit in the frame、fill the top half of the image | 臉和帽子清楚,尺度最有衝擊力 |
cartoon, anime, 3d render, text, watermark, deformed hands, extra limbs, low quality 這類常用詞:
Photorealistic smartphone photo, vertical frame, low angle looking up inside a subway station.
A gigantic white rabbit is too large to fit in the frame: its enormous furry face and navy
conductor hat fill the top half of the image and press against the ceiling lights, the body is
cut off by the frame. Bottom of the frame: tiny commuters on the platform looking at their
phones, unaware, standing beside one huge white paw on the tracks. Realistic fur, candid
documentary look.
提示裡要求的 press against the ceiling 和 paw on the tracks 都沒有完全做到,模型給的是貼近鏡頭的大兔子。我的做法是不再追加形容詞,改用構圖:讓動物佔滿畫面,再讓路人留在背景當尺度參照。
實測成品能直接上架嗎?
我挑 seed 22 的首幀生成影片,下面是第 0、27、54、80 幀。
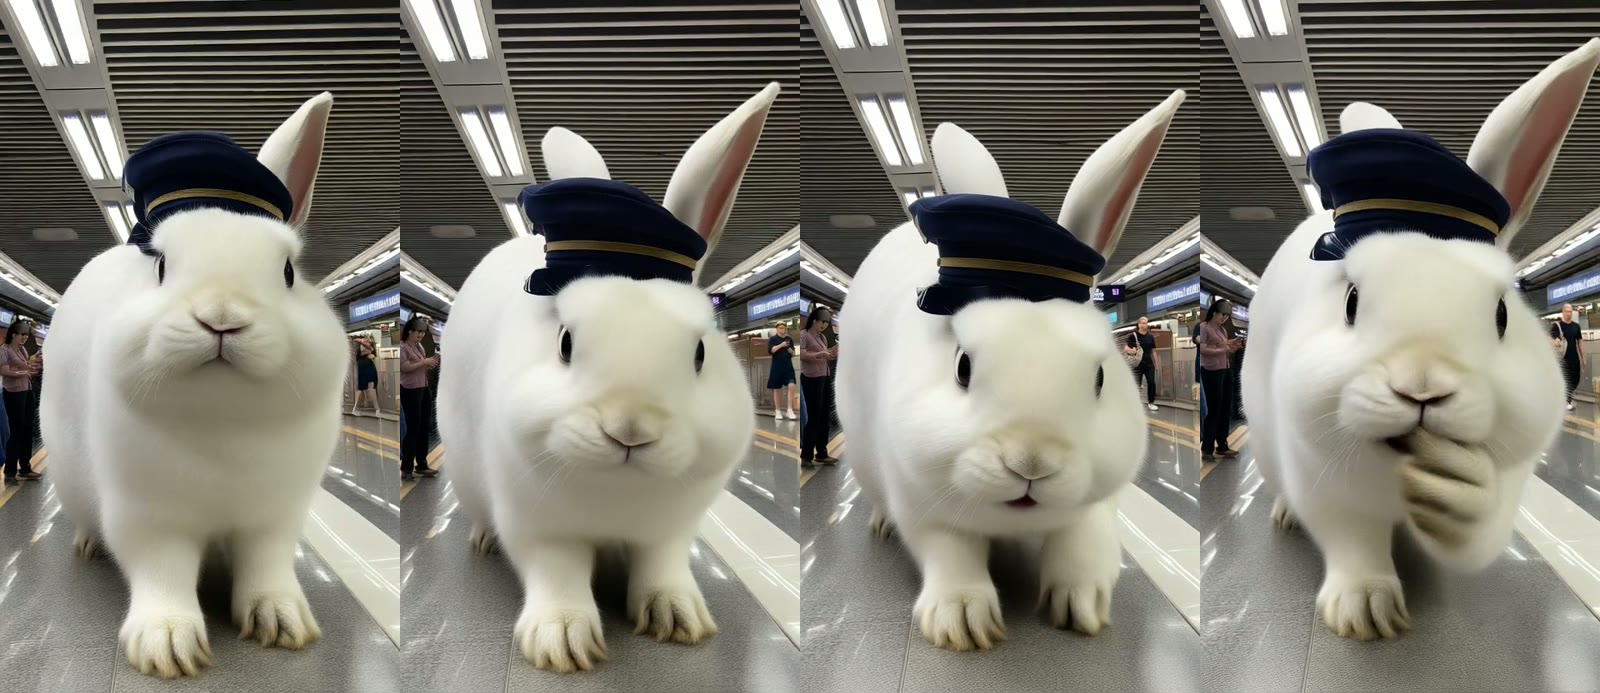
我看的是這四格抽幀,沒有逐格檢查完整影片。
| 檢查項目 | 結果 |
|---|---|
| 列車長帽 | 四格都留在頭上 |
| 背景路人 | 持續自然走動、看手機,反差成立 |
| 第二隻耳朵 | 第 0 幀只看得到一隻,後面三格出現兩隻 |
| 第 80 幀前腳 | 舉到嘴邊時形狀模糊,有點像握拳的手 |
| 巨大感 | 兔子靠近廣角鏡頭,有機會被看成近距離的普通尺寸兔子 |
| 軌道場景 | 兔子全程在月台地面,沒有走上軌道 |
下一步我會試兩件事:用專門的圖像模型先做好首幀,或把巨兔和月台分開做再合成。這兩個方向我還沒有實測,先列在這裡當待辦。
Daon&Lui 靠什麼賺錢?
主頁 bio 寫著 AI Videos & Images Featuring Our Real Cats / Higgsfield Creative Partner,外部連結指向 Higgsfield,網址帶 fpr= 參數。「真貓」只有帳號自述,我無法驗證。
Higgsfield 的 Creator Partnership Program 寫得很明確:合作夥伴每月拿到完整方案、額外點數、新模型搶先用,並且有聯盟計畫可以賺分潤;官方也要求工具用在作品裡時要標註或提及 Higgsfield。這支片的 Made with @higgsfield.ai 和這條要求吻合。
| 官方聯盟計畫條款 | 內容 |
|---|---|
| 抽成 | 最高為方案價格的 25%,依帶來的營收提升,官方頁沒列分級 |
| 期間 | 自成為推薦對象起最長 12 個月,含續訂和升級 |
| 年繳/季繳 | 整期佣金一次入帳 |
| 被推薦者優惠 | 最高 5 折,透過連結登入後 3 小時內有效 |
| 退款 | 退款的訂單沒有佣金(官方說明) |
| 禁止 | 付費廣告、競價 Higgsfield 品牌字、優惠券與返現網站 |
fpr= 我判斷是推薦參數,這支片用了哪個模型、帳號的分潤比例和收入,都查不到。在未登入的頁面上,我也沒有看到「付費合作」的標示;這只代表我看到的畫面,不足以判斷這支片有沒有收費。
這個案例讓我注意到的是資產的位置:主頁的貼文幾乎都是同一種貓,帳號累積的是可以反覆出現的角色,工具商合作建立在這個受眾上。Higgsfield 和本機模型的差別,我這次沒有做同題對比,不對畫質下結論。
想做同類短片,先從哪裡開始?
- 只想試格式:本機有 12GB 顯卡,照上面的流程,一支 5 秒試片約 4 分鐘加上選首幀的時間。
- 要穩定發片:先固定一個原創角色,換場景連發,比追單支爆款更容易累積受眾;這是我的判斷,還沒有自己頻道的數據支持。
- 想要更高的畫質:先補放大和音效,真的不夠再評估付費工具。
- 不要做的事:直接複製別人的角色、帽子和畫面,也不要把 AI 畫面當成真實影像發布。