懶人包
- Threads 上 @nkriderking 的做法只有兩句 prompt:ChatGPT 把角色照照著參考圖做成多格分鏡,Gemini 再把分鏡變成寫實 K-pop 舞蹈影片;貼文有 394 讚、238 次分享。
- 分鏡圖在這條流程裡是「動作地圖」:每一格先把姿勢定下來,影片模型只要負責兩格之間怎麼動。
- 我用本機 ComfyUI 跑 Wan2.2 TI2V 5B 重做:1 張角色主圖、6 格姿勢分鏡、6 段舞台影片串成 12.25 秒,RTX 4070 純生成約 13 分鐘,不用付費。
- 角色一致性靠「主圖跑 33 幀短 i2v、取最後一幀當新姿勢」,6 格的臉、瀏海、灰背心和白工裝褲都沒跑掉,比每格重新文生圖穩。
- 12GB 顯卡跑 5B fp16 會部分載入,每步約 30 秒;UNETLoader 改
fp8_e4m3fn後同樣 33 幀每步約 1.75 秒,快了約 17 倍。- 本機版的缺口很清楚:段落硬切、沒有聲音、480×832 解析度,第 3 格甩頭髮時頭髮蓋住臉;要上架還得補轉場和配樂。
Threads 上有一篇貼文,內容只有兩行 prompt,配一張 16 格的人物分鏡圖和一支 K-pop 舞台影片。底下好幾則回覆只寫一個字:Prompt。
我想知道的是另一件事:同樣的流程,不用 ChatGPT 和 Gemini 的雲端額度,在自己的顯卡上做得出來嗎?答案是做得出來,代價是畫質和轉場。下面是完整流程、腳本關鍵段和每一步的實測時間。
這篇 Threads 的 K-pop 分鏡影片是怎麼做的?
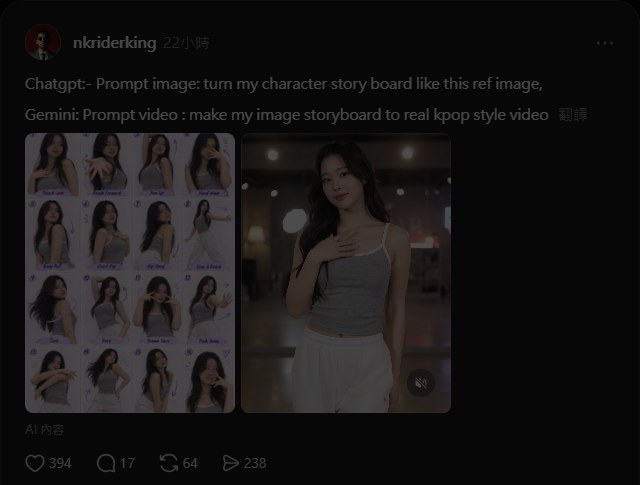
截圖是 2026-11-14 未登入狀態抓的公開頁面,貼文發出約 22 小時。作者 NK Rider 寫的完整流程就這兩句:
| 步驟 | 工具 | 原文 prompt |
|---|---|---|
| 1. 角色照變分鏡 | ChatGPT 生圖 | turn my character story board like this ref image |
| 2. 分鏡變影片 | Gemini 生影片 | make my image storyboard to real kpop style video |
Gemini 的照片轉影片由 Veo 3 生成。Google 官方部落格 2025-09-19 的說明寫的是每次產生一段 8 秒、帶聲音的影片,Google AI Pro 每天 3 支、Ultra 每天 5 支(來源)。額度會調整,實際上限以你帳號裡看到的為準。
為什麼要先做分鏡圖,不直接叫 AI 生跳舞影片?
直接寫「她跳一段 K-pop 舞」,影片模型要同時決定角色長相、動作順序和鏡頭,結果常常是原地搖擺。先做分鏡,等於把問題拆成兩半:
- 分鏡圖決定「跳什麼」:每一格就是一個定格姿勢,比心、指鏡頭、甩頭髮、雙手上舉,順序也固定了。
- 影片模型只負責「怎麼動過去」:它拿到的是一張已經有角色、有服裝、有姿勢的圖,要猜的東西少很多。
本機版:ComfyUI + Wan2.2 怎麼重做這條流程?
我的環境:
| 項目 | 規格 |
|---|---|
| 顯卡 | NVIDIA GeForce RTX 4070,12 GB |
| 介面 | ComfyUI,透過 HTTP API(/prompt、/history、/upload/image)用 Python 驅動 |
| 影片模型 | wan2.2_ti2v_5B_fp16.safetensors,載入時轉 fp8_e4m3fn |
| 文字編碼器 | umt5_xxl_fp8_e4m3fn_scaled.safetensors |
| VAE | wan2.2_vae.safetensors |
| 取樣 | KSampler 20 步、cfg 5.0、uni_pc、ModelSamplingSD3 shift 8.0 |
腳本拆成 5 個階段,一次跑一段,失敗可以從中間接:
python pipeline.py hero     # 角色主圖
python pipeline.py panels   # 6 格姿勢
python pipeline.py grid     # 拼成 3x2 分鏡圖
python pipeline.py clips    # 每格生一段舞台影片
python pipeline.py concat   # 串成一支
第 1 步:用 Wan2.2 生角色主圖
Wan2.2 是影片模型,但 Wan22ImageToVideoLatent 的 length 設成 1,它就只生一幀,等於文生圖。主圖用 704×1280,seed 1113:
CHAR = ("a young Korean-style female idol with long straight black hair and see-through bangs, "
        "wearing a fitted grey ribbed tank top and loose white cargo pants, white sneakers, "
        "full body shot, standing on a dark dance practice room floor, soft spotlight from above, "
        "photorealistic, 35mm photo")

g["7"] = {"class_type": "Wan22ImageToVideoLatent",
          "inputs": {"vae": ["3", 0], "width": 704, "height": 1280, "length": 1, "batch_size": 1}}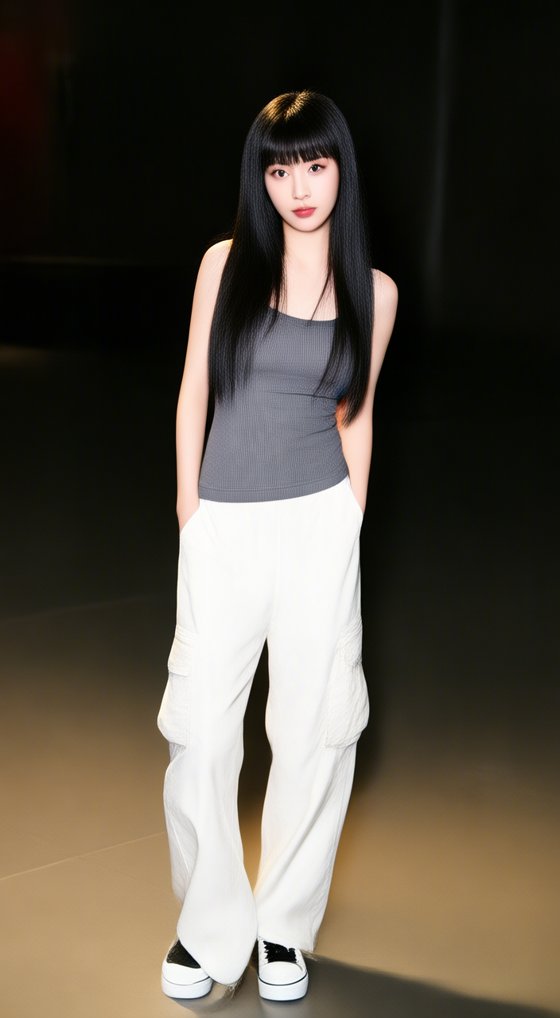
這張是整條流程唯一一次「從零生角色」。後面 12 次生成都拿它或它的後代當首幀。
第 2 步:短 i2v 取最後一幀,做出 6 格姿勢分鏡
這是本機版最關鍵的一招。我不重新文生圖 6 次(每次臉都會不一樣),而是拿主圖當首幀,跑 33 幀的圖生影片,prompt 只寫「她做出某個動作」,然後只留最後一幀:
POSES = {
    "p1_hand_heart": "she smoothly raises both hands and makes a heart shape over her chest, smiling at the camera",
    "p2_point":      "she steps forward and points her right index finger straight at the camera with a confident wink",
    "p3_hair_flip":  "she turns her head sharply and flips her long hair with one hand, hips swaying to the side",
    "p4_arms_up":    "she throws both arms high above her head in a V shape, jumping slightly on the beat",
    "p5_body_wave":  "she does a slow body wave, hands sliding down along her waist, eyes on the camera",
    "p6_final_pose": "she ends in a finishing pose: one hand on her hip, the other hand making a peace sign next to her face",
}

# 從解碼後的影格裡只取最後一張存檔
g["14"] = {"class_type": "ImageFromBatch",
           "inputs": {"image": ["9", 0], "batch_index": length - 1, "length": 1}}
影片模型在 33 幀裡必須讓同一個人連續動作,角色長相就被「拖」到最後一幀。6 格拼起來是這樣:
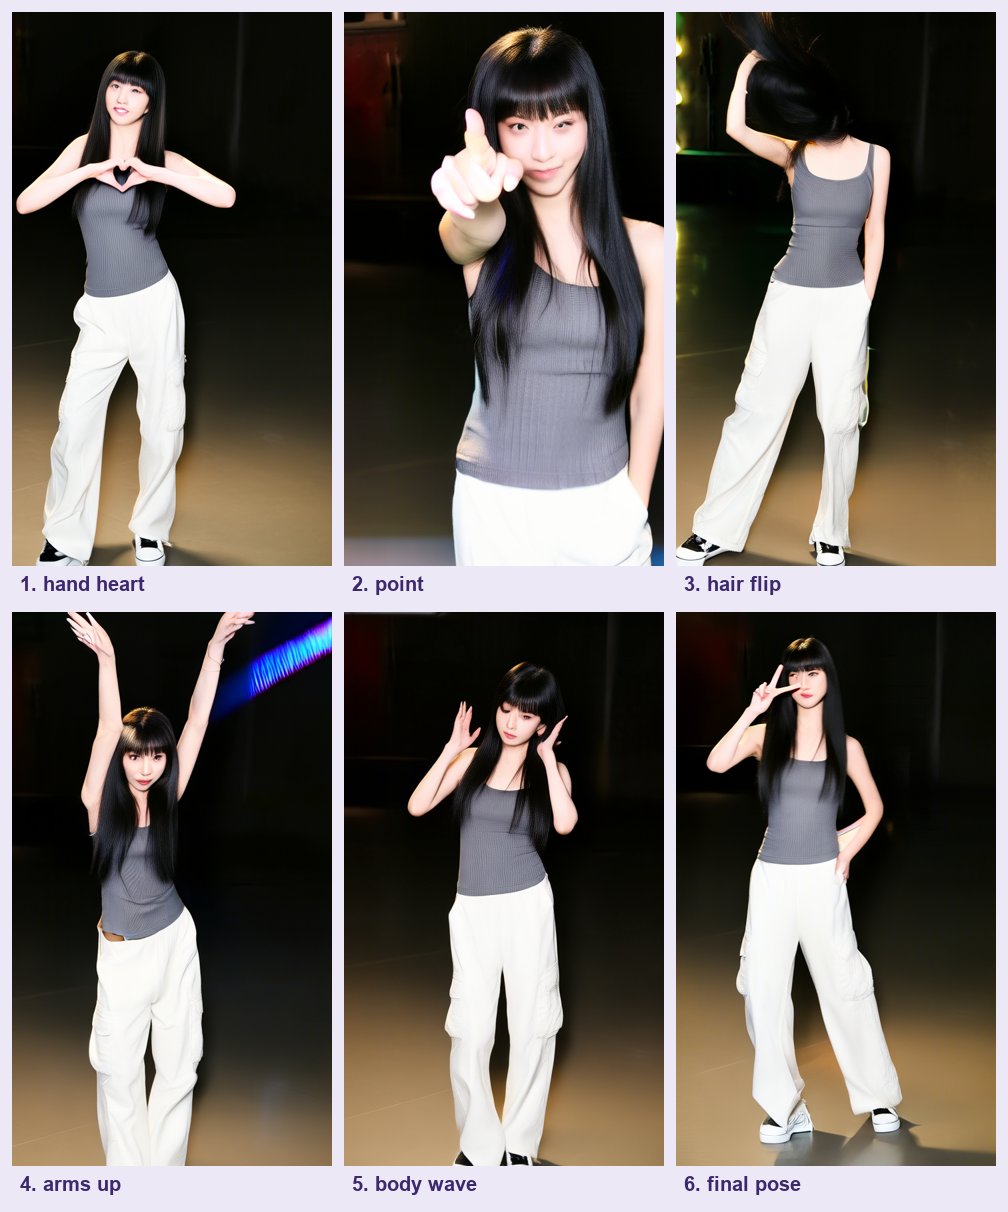
6 格的臉、空氣瀏海、灰背心、白工裝褲都對得上。第 3 格「甩頭髮」是失敗格:最後一幀剛好停在頭髮甩過臉的瞬間,看不到正臉。要修的話換 seed 或改成取倒數第 5 幀就好,這次沒重跑。格子下面的英文標籤是 PIL 加的,畫面本身全部是 Wan2.2 生成。
第 3 步:每格當首幀,生成舞台影片再串接
每格分鏡當首幀,跑 49 幀(24 fps 約 2 秒)的 i2v,480×832。prompt 前面加一段舞台描述,後面接原本的動作和角色描述:
STAGE = ("K-pop music video style, she dances energetically on a glossy stage with pink and purple concert lights, "
         "light beams and haze, dynamic camera, same girl, same outfit, ")

prompt = STAGE + motion + ". " + CHAR
6 段跑完用 ffmpeg concat 串起來:
ffmpeg -y -f concat -safe 0 -i list.txt -c:v libx264 -pix_fmt yuv420p -crf 20 kpop_storyboard_mv.mp4成品 480×832、24 fps、294 幀、12.25 秒、2.5 MB。下面是每段抽 4 幀的檢查圖,一列一段:
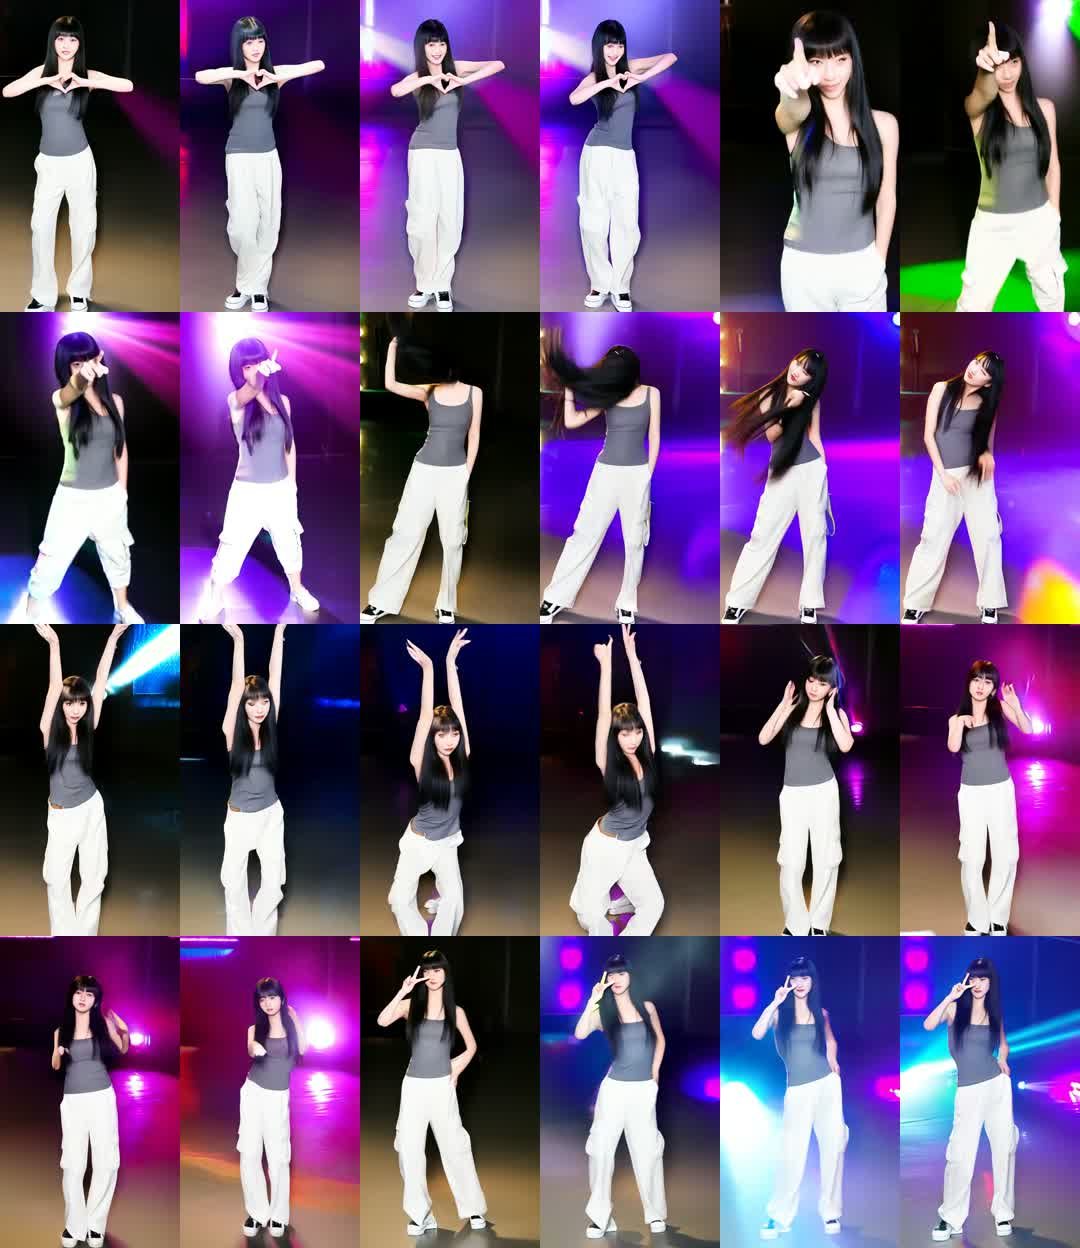
舞台燈、光束、反光地板都有出來,角色在 6 段裡沒有換臉。成品影片可以在 html.yanchen.app/kpop-storyboard-mv 直接播放,主圖、分鏡、影片三張並排對照。
RTX 4070 跑一支要多久?fp8 為什麼快 17 倍?
每一步都從 ComfyUI 的 log 讀回實際秒數:
| 階段 | 內容 | 單次耗時 | 取樣速度 |
|---|---|---|---|
| 主圖 | 704×1280、1 幀、fp16 | 240 秒(含載入模型) | 約 7 秒/步 |
| 分鏡第 1 格 | 33 幀、fp16 | 625 秒 | 約 29.8 秒/步 |
| 分鏡第 2–6 格 | 33 幀、fp8 | 52–92 秒 | 約 1.75 秒/步 |
| 舞台影片 6 段 | 49 幀、fp8 | 76–80 秒 | 約 2.6 秒/步 |
| 串接 | ffmpeg | 不到 1 秒 | — |
loaded partially; 128.00 MB usable, 128.00 MB loaded, 1216.08 MB offloaded, lowvram patches: 0
 20/20 [09:55<00:00, 29.76s/it]
5B 模型的 fp16 權重檔是 9,999,658,848 bytes,約 10 GB,加上文字編碼器、VAE 和 33 幀的 latent,12 GB 顯卡放不下,ComfyUI 只好把一部分權重搬回系統記憶體,每一步都在搬資料。ComfyUI 官方文件說 5B「靠原生 offloading 可以在 8 GB 顯卡上跑」(來源)——跑得動是真的,速度是另一回事。
解法是 UNETLoader 一個參數:
{"class_type": "UNETLoader",
 "inputs": {"unet_name": "wan2.2_ti2v_5B_fp16.safetensors", "weight_dtype": "fp8_e4m3fn"}}
權重在載入時轉成 fp8,log 變成 loaded completely ... 4769.33 MB loaded, full load: True,整個模型留在顯卡上。同樣 33 幀的分鏡,每步從 29.8 秒降到約 1.75 秒,約 17 倍。分鏡第 1 格是 fp16、第 2–6 格是 fp8,放在同一張分鏡圖裡看不出畫質落差;這是目測,沒有跑客觀指標。
扣掉 fp16 那兩次,fp8 下的 5 格分鏡加 6 段影片合計約 13 分鐘。電費以外沒有花錢。
本機版跟 ChatGPT + Gemini 差在哪?
| 比較 | ChatGPT + Gemini(原貼文) | ComfyUI + Wan2.2 5B(本機) |
|---|---|---|
| 操作 | 兩句 prompt、手機就能做 | 要裝 ComfyUI、下載模型、寫腳本 |
| 角色一致 | ChatGPT 參考圖編輯 | 同一張主圖用短 i2v 延伸 |
| 一次輸出 | Veo 3 每段 8 秒、帶聲音 | 每段 49 幀約 2 秒、無聲 |
| 解析度 | 依 Gemini 輸出 | 480×832 |
| 額度 | 依訂閱方案每日上限 | 只受顯卡和時間限制 |
| 可批次 | 手動一支一支 | 改 POSES 就能換一套舞步重跑 |
本機版還差什麼、哪一格失敗了?
- 段落之間是硬切:每段都從分鏡格起跳,段尾跟下一格的姿勢對不上。ComfyUI 有
WanFirstLastFrameToVideo節點,可以拿相鄰兩格當首尾幀補中間動作。我本機的 ComfyUI 有這個節點,也有 Wan2.2 i2v 14B fp8 模型(高低噪各 14.3 GB),但 14B 每段要跑更久,這次沒做。 - 沒有聲音:Veo 3 會一起生聲音,Wan2.2 不會。要配樂得自己準備,K-pop 原曲有版權,上架前要換成能用的音樂。
- 解析度只有 480×832:手機上看可以,要上 1080p 得再過一次放大。
- 第 3 格失敗:分鏡「甩頭髮」停在頭髮蓋住臉的瞬間,連帶第 3 段影片開頭也看不到正臉。
- 動作幅度偏小:2 秒的片段裡,大動作(跳起來、轉圈)容易糊,比心、指鏡頭、比 YA 這類手部定點動作最穩。
- 寫實人像的界線:我用的是虛構角色。原貼文流程是丟「自己的角色照」,換成真人照片時,要確認是自己或已取得同意的人。
延伸資源
- Threads 原貼文(NK Rider):兩句 prompt 和 16 格分鏡範例。
- 成品頁:主圖、分鏡、影片對照:可直接播放 12 秒成品。
- Gemini 照片轉影片官方說明:Veo 3、8 秒帶聲音、各方案每日上限。
- ComfyUI Wan2.2 官方教學:5B 與 14B 的 workflow、
Wan22ImageToVideoLatent參數。 - AI 巨大動物影片怎麼做?3 種提示實測:同一張 RTX 4070 用 14B i2v 搭 4 步 LoRA 出片。
- Claude 接 MCP 做 AI 影片:把本機 Wan2.2 包成 MCP,讓 Claude Code 直接叫它出片。
常見問題
一定要有 ChatGPT Plus 和 Gemini 付費方案嗎?
原貼文的雲端流程要看當下兩邊的方案和額度;Gemini 的照片轉影片在 Google 官方說明裡是 Google AI Pro/Ultra 的功能。本機版不用訂閱,但要一張夠力的 NVIDIA 顯卡。
12GB 顯卡跑 Wan2.2 5B 很慢怎麼辦?
先看 ComfyUI log 有沒有 loaded partially。有的話把 UNETLoader 的 weight_dtype 改成 fp8_e4m3fn,我這次同樣 33 幀從每步 29.8 秒降到約 1.75 秒。
為什麼不每格直接文生圖?
每次重新文生圖,臉和衣服都會變。用主圖跑短 i2v 取最後一幀,模型必須讓同一個人連續動作,6 格的長相和服裝都對得上。
可以換成自己的角色嗎?
可以。把主圖那步換成上傳自己的角色圖(/upload/image),後面 panels、clips 照跑;要換舞步就改 POSES 裡的 6 句動作描述。