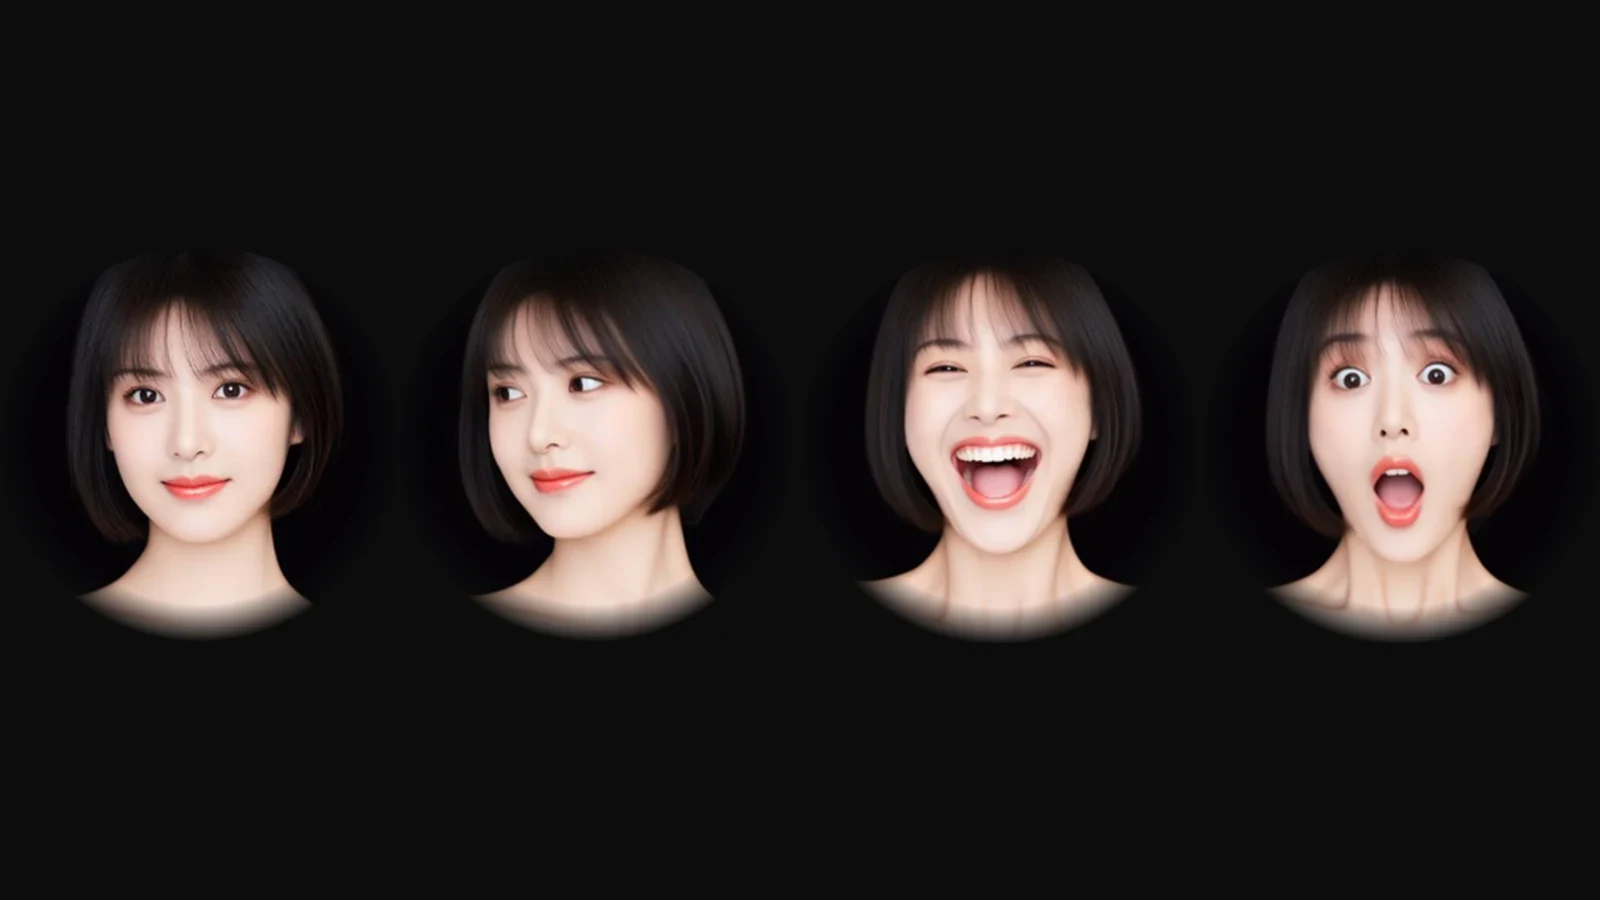
懶人包
- wayturn.dev 首頁那顆會盯著游標轉頭的頭像,拆開程式後是 21 張表情圖加一個狀態機:游標角度用
atan2分成 8 個方向挑圖,每 2.2 到 5.6 秒眨一次眼,閒置 30 到 45 秒打哈欠。- 作者偉騰說以前自己刻要 3 天,這次靠 MotionSites 的 prompt 加 ChatGPT 生圖,大約 5 輪對話、30 分鐘做完;MotionSites 另外開源了一個 Claude skill,2026-11-10 有 1,930 顆星。
- 我改用本機 Wan2.2 重做:先生一張虛構人物定裝照,再從同一張照片生 6 支 33 格的短片,抽出 95 格當素材,轉頭是連續的,不是一格一格跳。
- 實際踩到 3 個坑:「往左看」「往右看」兩支片轉向同一側(改用水平翻轉)、每支片第 4 到 10 格都自帶一次眨眼(剛好抽出來當眨眼組)、第一次組裝左右對應反了。
- 成品是 1.5 MB 的單一 HTML、不用 WebGL,線上版在 html.yanchen.app/living-portrait。
2026-11-10 我在 Threads 看到 @wayturn_(偉騰)的貼文:「以前做這種動畫自己刻要弄 3 天,現在怎麼下幾個 prompt 然後 30 分鐘就搞定了」。影片裡是他的個人網站 wayturn.dev,首頁頭像會跟著滑鼠轉頭、眨眼,點一下還會做表情。我截圖時這篇有 920 個讚、475 次分享。
我想知道兩件事:這個效果的原理是什麼,以及不用 ChatGPT 生圖,改用本機的影片模型能不能做。結論是原理很單純,影片模型做出來的轉頭還更順。
會跟著游標轉頭的頭像是怎麼做的?
原理是事先準備好很多張「看向不同方向」的臉,再依游標位置挑一張顯示。頭並沒有真的在 3D 空間裡轉,是在換圖。
我下載 wayturn.dev 的前端程式(engine-CDNop416.js)讀過,它的素材清單寫在一個陣列裡,共 21 張:
| 用途 | 圖片名稱 |
|---|---|
| 正面與眨眼 | rest、half、closed |
| 8 個視線方向 | left、right、up、down、upleft、upright、downleft、downright |
| 表情 | winkl、winkr、cross、tongue、puff、laugh、angry、shock、scrunch、yawn |
- 看游標:算游標相對臉中心的角度,用
atan2除以 45 度分成 8 格,對到 8 張方向圖;游標靠近臉的中心時顯示rest。 - 眨眼:程式裡寫的是
nextBlink = now + 2200 + 3400 * random(),也就是每 2.2 到 5.6 秒眨一次,播half → closed → half。 - 點臉做表情:點臉的不同位置觸發不同表情,例如點鼻子是鬥雞眼(
cross),點嘴巴是吐舌(tongue)。 - 閒置:
idleDelay = 3e4 + 15e3 * random(),30 到 45 秒沒動作就打哈欠或閉眼。 - 繪製:用 WebGL 把臉貼在網格上,兩張臉之間用 shader 的
mix()交叉淡化,拖曳時網格會變形,看起來像在捏臉。
原作者怎麼在 30 分鐘內做完?
作者在留言裡寫了步驟,我照原文整理:
- 到 motionsites.ai 挑一個免費模板,按「Copy prompt」。
- 把 prompt 貼給 AI,先問「做到這個效果需要準備什麼」,討論好再開工。他用的是 ChatGPT 加 Codex,因為要用 GPT 生圖。
- 讓 GPT 根據自己的照片生 60 多張不同表情的臉。
- 開工加微調,他說大約 5 輪對話就結束。
貼文提到的 MotionSites 有一個開源 repo:Motionsites-AI/claude-skill,建立於 2026-10-26,我查的時候有 1,930 顆星。README 寫它內含 40 個範例 prompt、50 多支 hero 影片素材、55 種以上的技法範例(例如滑鼠控制影片進度、景深輪播),以及一個「截圖自己做的頁面、看了再修」的檢查流程。Claude Code 的安裝方式照 README:
/plugin marketplace add Motionsites-AI/claude-skill
/plugin install motionsites-web-builder@motionsites
這個 skill 是免費樣本,完整的 prompt 庫在官網是付費方案 MotionSites Unlimited。
改用本機 Wan2.2 重做:我的流程
原作用生圖模型一張一張生臉,每張之間是獨立的,所以要靠交叉淡化把跳動藏起來。我的想法是:轉頭本來就是一段連續動作,直接叫影片模型生「慢慢往左看」的短片,抽出來的格子天生就是連續的。
環境:
| 項目 | 值 |
|---|---|
| 顯示卡 | RTX 4070 12GB |
| 介面 | ComfyUI 0.3.71(本機 API) |
| 定裝照 | wan2.2_ti2v_5B_fp16,length 設 1 當文生圖用,640×640、30 步 |
| 短片 | wan2.2_i2v_high_noise_14B_fp8_scaled 與 low_noise 兩段各跑 2 步,加 lightx2v 4 步 LoRA,480×480、33 格 |
第一步:一張定裝照
人物是虛構的,不用真人照片。Wan2.2 TI2V 5B 是影片模型,把 length 設成 1 就只生一格,等於拿來當文生圖。生了兩個 seed,挑了比較正面、背景比較乾淨的那張。
第二步:同一張照片生 6 支短片
6 支都從同一張定裝照出發,prompt 前半固定,只換動作那一句。這是「往左看」那支:
Static camera, the same young woman, black background, head and shoulders, realistic.
She slowly turns her head and eyes to look toward the left side of the frame, then holds still.
另外 5 支的動作句分別是往右看、往上看(tilts her head up and raises her eyes)、往下看、大笑(breaks into a big happy laugh)、嚇一跳(eyebrows raised high, eyes wide, mouth open in an O shape)。負向 prompt 放了 camera movement, zoom,避免鏡頭自己推近。
Static camera 和 then holds still 這兩句是為了讓第一格和最後一格都穩住:第一格要跟定裝照一樣,才能當「正面」;最後一格要停住,才能當「看到底」。
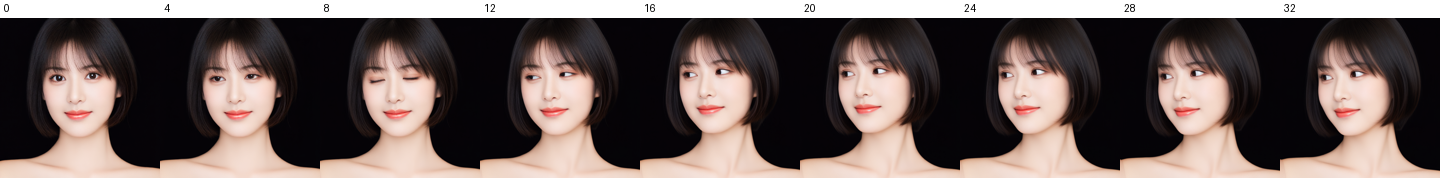
第三步:抽格、組成單一 HTML
每支片挑一段格子,用 Pillow 縮成 400px JPEG,base64 內嵌進一個 HTML。頁面上是一個 canvas,每一幀做三件事:
function pickGaze(x, y) {
  const mag = Math.hypot(x, y);
  if (mag < 0.06) return [null, 0];              // 游標在中間:正面
  const horiz = Math.abs(x) >= Math.abs(y);
  const set = horiz ? (x < 0 ? 'left' : 'right') : (y < 0 ? 'up' : 'down');
  return [set, Math.min(1, (horiz ? Math.abs(x) : Math.abs(y)) * 1.6)];
}- 依游標方向挑一組(左、右、上、下),再依游標離中心多遠,決定播到這組的第幾格。游標越遠,頭轉得越多。
- 游標位置先做平滑(每幀往目標靠近 12%),頭不會跟著滑鼠抖。
- 每 2.6 到 5.8 秒播一次眨眼組;點臉或按按鈕就把表情組來回播一次(0 → 1 → 停住 → 0)。
實際踩到的 3 個坑
「往左看」和「往右看」轉向同一側。 兩支片的 prompt 只差 left 和 right,模型生出來卻轉向同一邊。我沒有重生,改把其中一支水平翻轉當另一側用。這張臉和中分瀏海差不多左右對稱,翻轉後看不出破綻;如果角色有明顯不對稱的特徵(側分、痣、單邊耳環),這招就不能用。
每支片開頭都自帶一次眨眼。 從上面那張抽格圖可以看到,第 8 格是閉眼。6 支片都一樣,大約在第 4 到 10 格眨一次眼。處理方式:轉頭組直接跳過這幾格,跳過的地方看起來像眼球快速移動;這段眨眼反而剛好抽出來當眨眼組,原本排程要另外生的「眨眼」短片就取消了。
第一次組裝時左右反了。 游標往左,頭卻往右轉。這種錯從程式看不出來,要真的把游標移過去看。我用 Playwright 把游標移到上下左右四個位置各截一張圖才發現,交換鏡像設定後重測就對了。
成品長什麼樣?
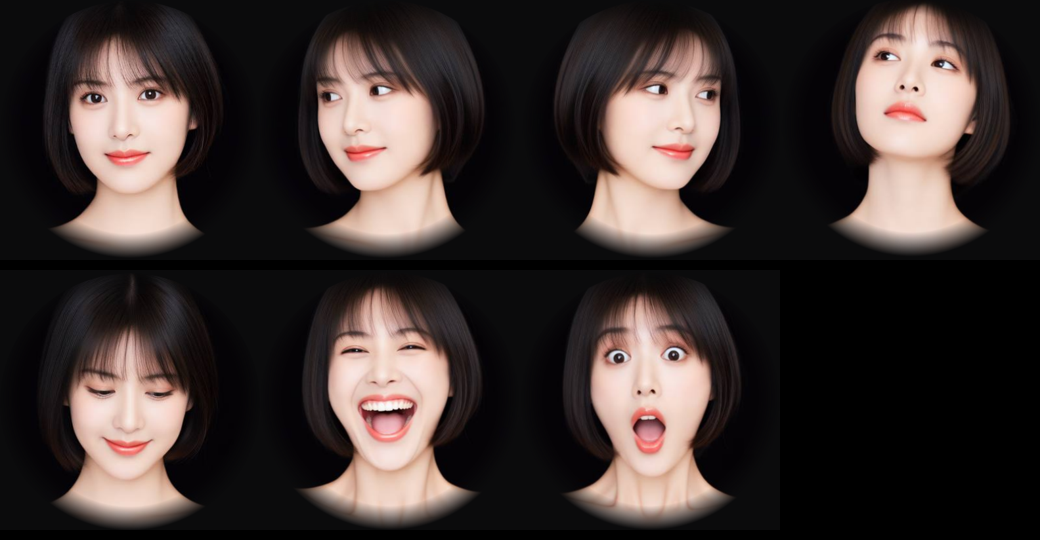
Playwright 對線上網址跑的結果:
frames per set: {'left': 19, 'right': 19, 'up': 16, 'down': 16, 'blink': 5, 'smile': 10, 'surprise': 10}
pageerrors: none| 項目 | 數字 |
|---|---|
| 短片 | 6 支,每支 33 格,全部生成成功 |
| 用到的格子 | 95 格(左右兩組共用同一支片) |
| 檔案大小 | 1,505,188 bytes,單一 HTML |
| 生成時間 | 約 20 分鐘,大部分在排 ComfyUI 佇列 |
跟原作比,差在哪?
| wayturn.dev 原作 | 我的 Wan2.2 版 | |
|---|---|---|
| 素材來源 | GPT 生圖,21 張靜態圖 | 影片模型,6 支短片抽 95 格 |
| 方向 | 8 個方向(含斜向) | 4 個方向,斜向取比較大的那個軸 |
| 轉頭過渡 | 兩張圖交叉淡化 | 連續格,本身就順 |
| 互動 | 點臉不同部位觸發不同表情、拖曳捏臉、14 秒內連拉 5 次會生氣 | 點臉或按按鈕隨機播「笑」或「嚇一跳」 |
| 繪製 | WebGL 網格 | canvas drawImage |
| 成本 | 需要 ChatGPT 生圖 | 本機 GPU,無額外費用 |
要補斜向,再多生 4 支「往左上看」這類短片即可,程式的 pickGaze 改成 8 個方向。
常見問題
可以用自己的照片做嗎?
技術上可以,第一步改成上傳自己的照片當起始圖就好,Wan2.2 I2V 吃的就是一張圖。要注意的是成品會放上公開網站,用真人照片前先確定本人同意;我這次用的是生成出來的虛構人物。
一定要用 Wan2.2 14B 嗎?
我只測了 14B 加 lightx2v 4 步 LoRA 這個組合,480×480、33 格在 RTX 4070 12GB 上可以跑。5B 我只拿來生定裝照,沒有拿來生轉頭短片,所以不能保證 5B 生出來的轉頭一樣穩。
檔案 1.5 MB 會不會太大?
這是把 95 張 400px JPEG 全部 base64 內嵌的結果,好處是單一檔案、丟到哪都能跑。要放進正式網站,可以改成外部 webp 檔、手機只載入正面和四個方向的少數幾格,原作在小螢幕上也有另外的處理。