懶人包
- IG 上 Rand 林鴻仁的「我用 Claude 做動畫,6 個步驟全部給你」,安裝指令與規則要留言「mo」才拿得到;我沒留言,照貼文公開的 6 步自己補上工具,做出一支 23.47 秒、1080×1920、有配音的直式短片。
- 工具組合:Claude Code 寫程式、edge-tts 7.3.1 配音、HyperFrames 0.9.28 把 HTML 渲染成 MP4、ComfyUI 的 Wan2.2 ti2v 5B 生角色圖。從開資料夾到成片約 15 分鐘,渲染本身 36.3 秒。
- 讓畫面跟得上台詞的關鍵是第 ④ 步:配音時順便拿每句話的起訖秒數,第 ⑤ 步直接拿這些秒數當每一鏡的
data-start,鏡頭就會在句子交界切換。- 第 ⑥ 步的「給規則自己檢查」我用
hyperframes check:6 輪裡擋下字型沒宣告@font-face、對比 2.98:1 低於 3:1、<video>放錯層三類錯誤,Claude 照錯誤訊息改到 0 error。- check 沒抓到的是字幕把「抓出」拆成兩行,我看截圖才發現;ComfyUI 生的揮手動作 2.5 秒後手臂變形,只用了前 2 秒。
我在 IG 看到 Rand 林鴻仁(@life.coach.mtcity)2026-11-06 的 Reel,標題是「我用 Claude 做動畫,連續 6 支 Reels 破萬」。貼文把流程寫成 6 步,安裝指令、每一步的指令範例和他在用的規則,要留言「mo」才私訊。
我沒有留言,改用貼文公開的 6 步當規格,每一步自己挑工具補上,實際做一支短片出來。下面是每一步用了什麼、跑出什麼數字、哪裡卡住。
IG 這 6 步分別要做什麼?
貼文原文的 6 步,和我實作時對應的工具:
| 步驟 | 貼文原文(節錄) | 我用的工具 | 產出 |
|---|---|---|---|
| ① | 打開 Claude Code 桌面版,先開一個新資料夾 | Claude Code | 空的工作目錄 |
| ② | 影片輸出跟配音的工具讓它自己裝,動畫技能包是選配 | HyperFrames 0.9.28、edge-tts 7.3.1、FFmpeg | 可渲染的專案骨架 |
| ③ | 找風格參考,請 AI 先做一張示意圖給你改 | ComfyUI+Wan2.2 ti2v 5B | 704×704 角色圖 |
| ④ | 寫台詞,照台詞配音,把每一句的時間抓出來 | edge-tts 的 SentenceBoundary | voice.mp3+timings.json |
| ⑤ | 參考圖跟台詞全部給 AI 設計動畫,每一鏡直接講 | Python 產生 HyperFrames 的 index.html | 5 鏡 6 句字幕 |
| ⑥ | 給規則讓它自己檢查、自己改,改過幾次就存成 skill | hyperframes check | 6 輪後 0 error |
hyperframes render 輸出 MP4。整條流程的資料走向如下:
畫面是 HTML、CSS 加 GSAP 動畫畫出來的動態圖文,角色圖由 ComfyUI 生成。原 Reel 用的是哪一套影片框架,貼文沒寫;HyperFrames 是我選的,原理在〈HyperFrames 是什麼?「9 個 Claude 動畫 Skill」實測〉寫過。
①② 開資料夾、裝工具要裝什麼?
需要三樣:渲染影片的 HyperFrames、配音的 edge-tts、HyperFrames 會呼叫的 FFmpeg。HyperFrames 是 HeyGen 開源的 HTML 轉影片框架,Apache-2.0,2026-11-10 查 npm 最新版是 0.9.28。
mkdir hf && cd hf
npm i hyperframes
./node_modules/.bin/hyperframes init reel --example blank --resolution portrait
pip install edge-tts
--resolution portrait 產生 1080×1920 的直式專案。init 會在專案裡放一份 CLAUDE.md 和 AGENTS.md,寫了合成檔的規則,Claude Code 開這個資料夾就讀得到。貼文說「動畫技能包是選配」,我沒有另外全域安裝 HyperFrames 的 skill,只靠這兩份檔案。
我這台的 npm 11.6.2 直接跑 npx hyperframes 會出現 ECOMPROMISED Lock compromised,改成在專案內 npm i hyperframes,再直接呼叫 node_modules/.bin/hyperframes 就過了。
③ 角色參考圖怎麼生?
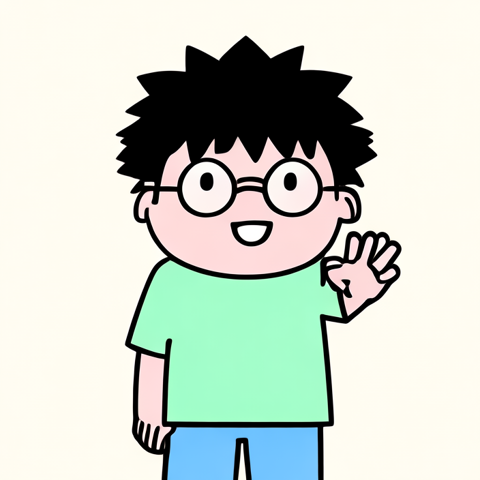
貼文建議上 Pinterest 找人物造型和配色,再請 AI 畫一張示意圖。我直接用本機 ComfyUI 的 Wan2.2 ti2v 5B,把 length 設成 1,讓影片模型只出一格,當文生圖用:704×704、seed 42,約 30 秒。
接著把這張圖當起始幀,同一個模型生 73 格(3.04 秒)的揮手動作,耗時 295 秒。結果前 2 秒正常,2.5 秒後手臂開始變形:
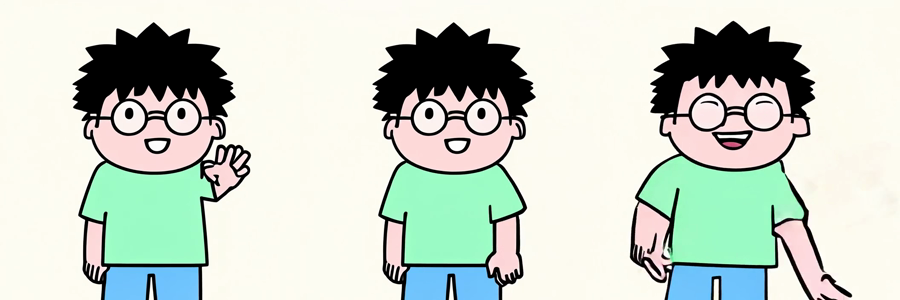
所以成片只用前 2 秒的揮手當開場,之後的鏡頭都放靜態角色圖,用 GSAP 做上下浮動。
④ 配音時怎麼把每句的時間抓出來?
edge-tts 串流音訊時,會一起送出句子邊界事件,裡面有每句的起點(offset)和長度(duration),單位是 100 奈秒。存下來就是時間軸:
comm = edge_tts.Communicate(" ".join(lines), "zh-TW-HsiaoChenNeural",
                            rate="+5%", boundary="SentenceBoundary")
async for chunk in comm.stream():
    if chunk["type"] == "audio":
        audio += chunk["data"]
    elif chunk["type"] == "SentenceBoundary":
        marks.append({"text": chunk["text"],
                      "start": chunk["offset"] / 1e7,
                      "end": (chunk["offset"] + chunk["duration"]) / 1e7})
5 行台詞跑出 23.45 秒的配音,切成 6 句(第一行「你知道嗎?用 Claude 也能做動畫。」被拆成兩句):
| 句子 | 起 | 訖 |
|---|---|---|
| 你知道嗎? | 0.10 | 1.69 |
| 用 Claude 也能做動畫。 | 1.64 | 4.01 |
| 第一步,開一個新資料夾,貼一段安裝指令。 | 4.01 | 8.49 |
| 第二步,寫好台詞,讓它配音,抓出每一句的時間。 | 8.49 | 13.89 |
| 第三步,把參考圖跟台詞丟給它,每一鏡直接講。 | 13.89 | 18.79 |
| 最後,給它規則自己檢查,改好就存成 skill。 | 18.79 | 23.38 |
⑤ 每一鏡怎麼對齊配音?
HyperFrames 的合成檔是一個 HTML,每個元素用 data-start、data-duration、data-track-index 決定在第幾秒出現、放在哪一軌。我讓 Claude 寫了一支 130 行的 build_comp.py,讀 timings.json,把每一鏡的開始秒數設成該鏡第一句的起點:
def scene_bounds(i):
    start = 0.0 if i == 0 else marks[SCENES[i]["lines"][0]]["start"]
    end = total if i == len(SCENES) - 1 else marks[SCENES[i + 1]["lines"][0]]["start"]
    return round(start, 2), round(end - start, 2)
前兩句合成開場鏡,其餘一句一鏡,共 5 鏡。字幕放另一軌,一句一個元素,同樣用句子秒數。動畫寫在 GSAP 時間軸裡:標題從下方彈入、三個圖示依序放大、角色從右側滑入。換台詞重跑 tts.py 和 build_comp.py,鏡頭會自動跟著新的秒數切。
貼文說「每一鏡想要什麼直接講」,對應到這裡就是 SCENES 那個清單:每鏡的標題、徽章、三個圖示。我跟 Claude 講需求,它改的是這份清單,不用碰時間。
⑥「給規則讓它自己檢查」實際抓到什麼?
hyperframes check 會開無頭 Chrome 載入合成檔,檢查 lint、版面、動畫、WCAG 對比、字型和音軌。Claude 跑 check、讀錯誤訊息、改 build_comp.py、重產、再跑,6 輪的紀錄:
| 輪次 | 結果 | 擋下的問題 |
|---|---|---|
| 1 | 失敗 | 字型 microsoft jhenghei、noto sans tc 沒有 @font-face;字幕對比最低 2.98:1,低於 3:1 |
| 2 | 失敗 | 對比已 39/39 通過,字型來源仍不固定 |
| 3 | 失敗 | noto sans tc 沒有 @font-face 宣告,渲染會退回預設字型 |
| 4 | 通過 | 之後加入 ComfyUI 揮手影片 |
| 5 | 失敗 | <video> 帶 data-start,卻放在同樣帶 data-start 的 <section> 裡 |
| 6 | 通過 | 0 error,剩 7 個 style warning |
NotoSansTC-VF.ttf 複製進專案的 assets/,在合成檔裡宣告 @font-face;影片的改法是把 <video> 移到最外層,自己佔一軌。
第 3 輪的錯誤訊息原文:
[StaticGuard] Invalid HyperFrame contract: Font family used without @font-face declaration: noto sans tc. These are not in the auto-resolved font list, so the renderer cannot supply them automatically. Text will fall back to a generic font, producing incorrect typography in the video.錯誤訊息直接寫了原因和後果。第 5 輪那條也一樣,說明影片會抽錯格、在時段中途消失。Claude 讀完就知道要改哪裡,這是自檢迴圈能自己收斂的原因。
渲染 704 格、4 個 worker,花 36.3 秒,輸出 23.47 秒、5.06 MB 的 MP4。最終版的 5 個時間點:
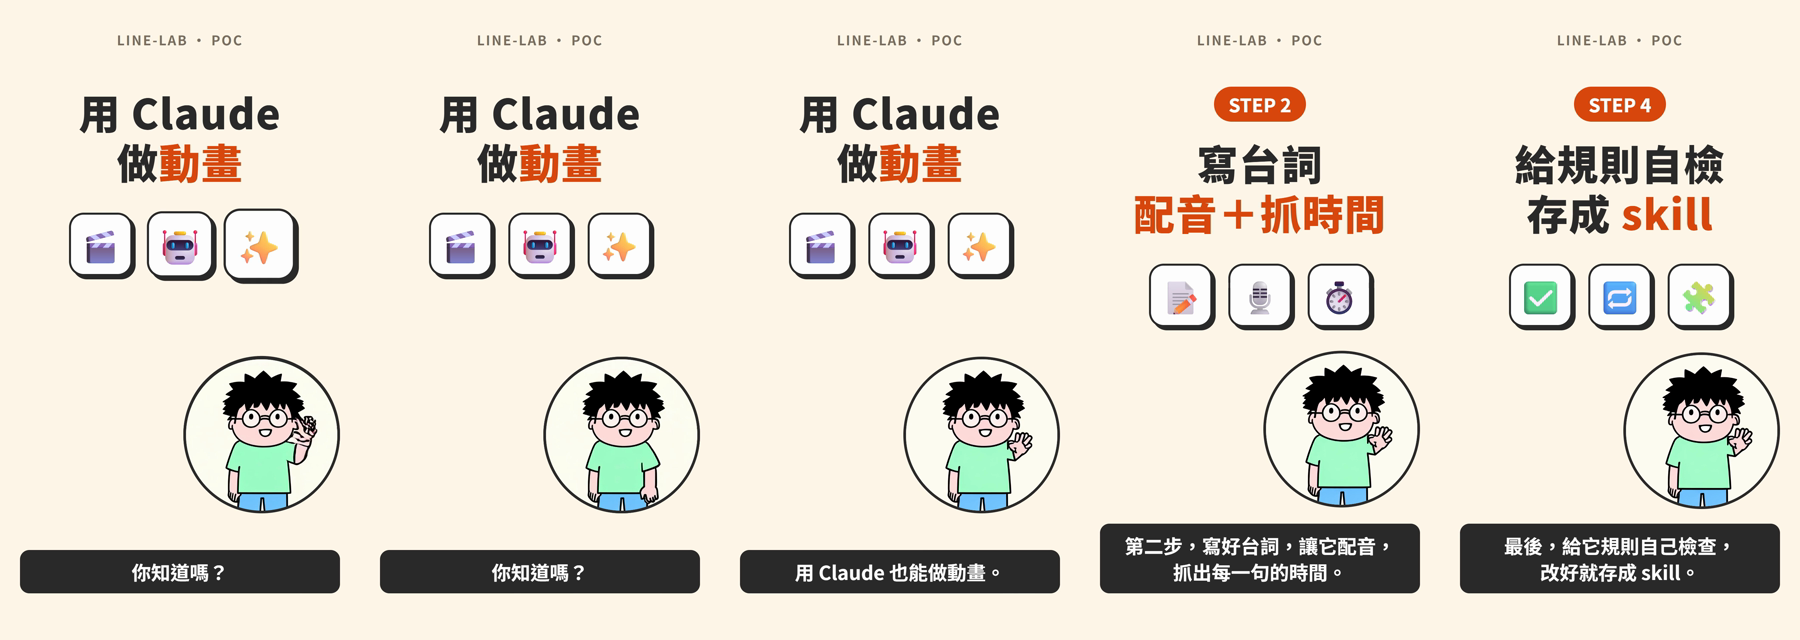
成品影片放在 html.yanchen.app/claude-anim-poc,可以直接播。
check 全過之後還要看什麼?
check 抓不到語意。第一版 check 已經通過,我抽 5 格截圖看,字幕在固定字數處斷行,把「抓出」拆成上下兩行:
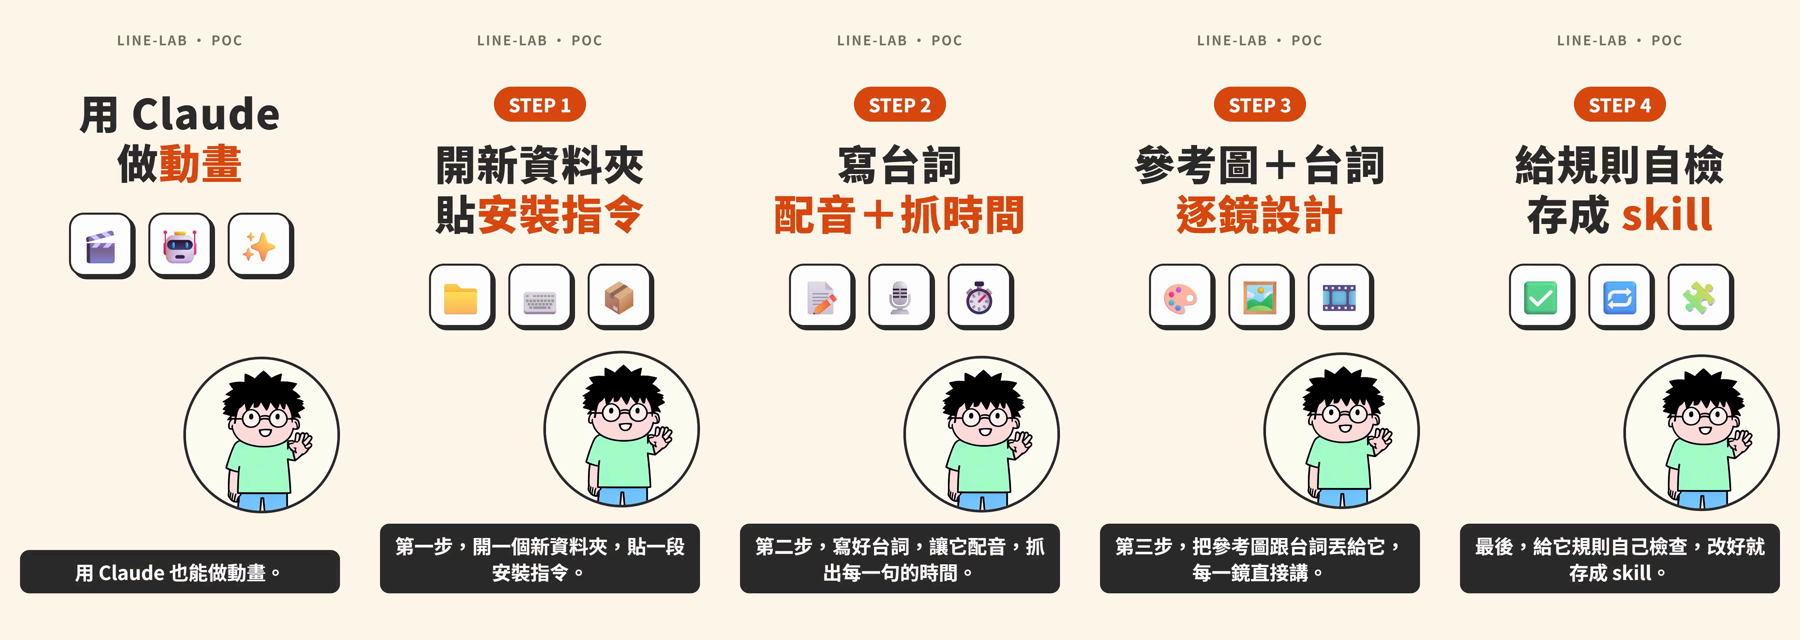
修法是字幕超過 15 字時,在最靠近中間的全形逗號後斷行:
def wrap_caption(text, max_chars=15):
    if len(text) <= max_chars:
        return text
    commas = [k for k, ch in enumerate(text) if ch == ","]
    if not commas:
        return text
    cut = min(commas, key=lambda k: abs(k - len(text) / 2)) + 1
    return text[:cut] + "<br>" + text[cut:]
貼文說「改過幾次就存成 skill」。我會把這類 check 管不到、但人眼一看就知道錯的規則寫進 skill:字幕只在標點斷行、AI 生成片段只取變形前的秒數、每次渲染後抽 5 格截圖給 Claude 看。
這套流程適合做什麼、不適合做什麼?
適合:
- 教學重點回顧、步驟說明這類文字為主的直式短片。換
script.txt重跑tts.py、build_comp.py、check、render,一支新片 1–2 分鐘,不含 ComfyUI 生角色。 - 需要固定版型的系列片。版型寫在 HTML 和 CSS 裡,每支片風格一致。
- 需要角色連續表演的內容。這次 Wan2.2 5B 的揮手撐 2 秒多就變形,AI 生成片段只能當點綴。
- 想完全不看成品就上架。check 管得到字型、對比、時間軸,管不到斷字、語意和好不好看。
延伸資源
- HyperFrames GitHub:框架原始碼與 README,
check、render的完整選項。 - 原始 Reel:Rand 林鴻仁的 6 步貼文。
- 本次成品影片:23 秒配音短片,可直接播放。
- 〈HyperFrames 是什麼?「9 個 Claude 動畫 Skill」實測〉:HyperFrames 原理與安裝。
- 〈Claude 動畫特效包是什麼?HyperFrames 448 個現成積木實測〉:現成特效積木怎麼套。
- 〈Claude Code 剪影片 5 步流程實測〉:真人口播片的自動剪輯。