懶人包
- Threads 顯示「此內容並未開放所有人查看/特定受眾無法查看此內容」,點「查看原因」寫的是 Meta 收到法律要求、在內容違反當地法律的地區限制存取,不是要登入、也不是貼文被刪。
- Meta 透明度中心的說法:依當地法律處理的內容,只在被指違法的司法管轄區限制存取,並通知發文者;其他地區照常看得到。
- 不用開瀏覽器也分得出來:用
facebookexternalhit/1.1抓頁面,看og:url與og:title三種簽章——公開、法律限制(作者欄被清空成@/post/)、不存在或私人(Threads • Log in)。- 我寫了一支只用 Python 標準函式庫的
threads_probe.py,2026-11-13 對 4 個網址實測,公開、法律限制、捏造代號三種狀態都判對,還能從貼文代號還原發文時間。- 判讀結果只代表「從你這台機器所在的地區看」;HTML 裡的
@是@實體,沒 unescape 的話比對字串會漏判。
我在台灣打開一則 Threads 分享連結,畫面只剩兩行字:
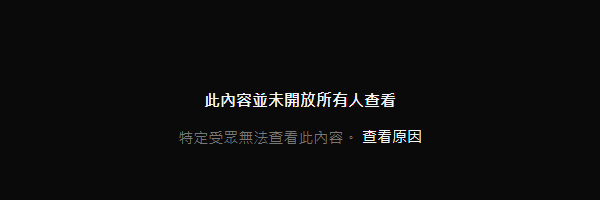
這篇講兩件事:這行訊息到底代表什麼,以及我怎麼讓自動化流程在不開瀏覽器的情況下,一次分辨「公開/被法律限制/不存在」這三種 Threads 連結。
「此內容並未開放所有人查看」是什麼意思?
點右邊的「查看原因」,會跳出 Meta 的說明:
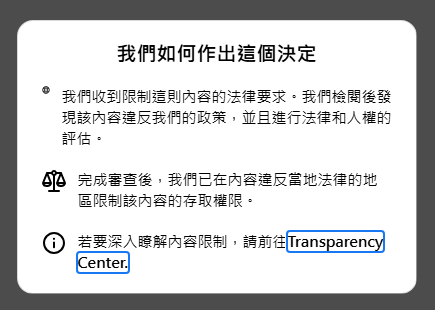
視窗原文三句:
- 「我們收到限制這則內容的法律要求。我們檢閱後發現該內容違反我們的政策,並且進行法律和人權的評估。」
- 「完成審查後,我們已在內容違反當地法律的地區限制該內容的存取權限。」
- 「若要深入瞭解內容限制,請前往 Transparency Center。」
所以這行訊息跟下面幾種狀況不同:
| 你看到的 | 實際狀況 | 登入有沒有用 |
|---|---|---|
| 此內容並未開放所有人查看+查看原因 | 依當地法律做地區限制 | 沒用,同一地區的帳號一樣看不到 |
| 導回登入頁 | 貼文不存在、已刪除,或是私人帳號 | 私人帳號要被核准追蹤才行 |
| 正常顯示內文 | 公開貼文 | 不需要 |
/post/<代號>/embed、爬蟲 UA,三條路都拿不到內文,embed 回的是「Thread not available」。
為什麼要在抓網址前先分辨?
我的流程是:LINE 收到網址 → 自動抓內容 → 研究或寫文。被法律限制的貼文,瀏覽器截圖只會拍到上面那兩行字,後面的研究全部白跑。
我想要的是抓網址前先打一次 HTTP 請求,就知道這個連結屬於哪一種,被限制的直接標「內容取得失敗」。
怎麼不開瀏覽器就分辨 Threads 貼文狀態?
Threads 會對連結預覽爬蟲回傳帶 Open Graph meta 的 HTML。我用 facebookexternalhit/1.1(Meta 自家的連結預覽 UA)抓三種已知狀態的頁面,比對 og:url 與 og:title,三種狀態的簽章不一樣:
| 狀態 | og:url | og:title | og:description |
|---|---|---|---|
| 公開 | threads.com/@作者/post/代號 | 作者 (@帳號) on Threads | 貼文內文 |
| 法律限制 | threads.com/@/post/代號(作者欄被清空) | 無 | 無 |
| 不存在/私人 | threads.com/ | Threads • Log in | 無 |
curl -s -A facebookexternalhit/1.1 "https://www.threads.com/@<作者>/post/<被限制的代號>" \
  | grep -oE '<meta (property|name)="og:(url|title)" content="[^"]*"'
<meta property="og:url" content="https://www.threads.com/@/post/<被限制的代號>"同一位作者的公開貼文:
<meta property="og:title" content="<名字> (@<作者>) on Threads"
<meta property="og:url" content="https://www.threads.com/@<作者>/post/<公開的代號>"注意 @ 在原始 HTML 裡是 @。直接拿 threads.com/@/post/ 去比對原始字串會對不到,要先 html.unescape。
分享連結 threads.com/share/<id> 會先 302 轉到 /@作者/post/代號,所以就算貼文被限制,從轉址後的網址還是拿得到作者帳號與代號:
302 https://www.threads.com/@<作者>/post/<被限制的代號>?xmt=...&slof=1threads_probe.py:一支連結預檢器
只用 Python 標準函式庫,Python 3.10 以上(用到 str | None 型別寫法)。核心是三個函式:
import datetime, html, re, urllib.request

CRAWLER_UA = "facebookexternalhit/1.1"
SHORTCODE_ALPHABET = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789-_"
IG_EPOCH_MS = 1314220021721
TAIPEI = datetime.timezone(datetime.timedelta(hours=8))


def fetch(url: str) -> tuple[str, str]:
    req = urllib.request.Request(url, headers={"User-Agent": CRAWLER_UA})
    with urllib.request.urlopen(req, timeout=20) as resp:
        return resp.geturl(), resp.read().decode("utf-8", errors="replace")


def meta(page: str, prop: str) -> str | None:
    m = re.search(rf'<meta (?:property|name)="{re.escape(prop)}" content="([^"]*)"', page)
    return html.unescape(m.group(1)) if m else None


def classify(og_url: str | None, og_title: str | None) -> str:
    if og_url and re.search(r"threads\.com/@/post/", og_url):
        return "restricted_by_law"
    if og_title and "Log in" in og_title:
        return "not_found_or_private"
    if og_title and "on Threads" in og_title:
        return "public"
    return "unknown"
urlopen 會自動跟 302,resp.geturl() 拿到的是轉址後的網址,再用 threads\.(?:com|net)/@([^/]*)/post/([A-Za-z0-9_-]+) 抽出作者與代號。公開貼文順手回傳 og:description(內文)與 og:image(首圖),自動化流程就不用再開一次瀏覽器。
跑法:
python -I threads_probe.py <網址1> <網址2> ...每個網址輸出一行 JSON。2026-11-13 13:24 我重跑一次的結果(作者與代號改成占位字、內文截短):
{"input": "https://www.threads.com/share/<分享id>", "status": "restricted_by_law", "author": "<作者>", "shortcode": "<代號A>", "posted_at_taipei": "2026-11-13T08:10:13+08:00", "text": null, "image": null}
{"input": "https://www.threads.com/@<作者>/post/<代號B>", "status": "public", "author": "<作者>", "shortcode": "<代號B>", "posted_at_taipei": "2026-11-12T21:10:27+08:00", "text": "<貼文內文>", "image": "https://scontent...jpg"}
{"input": "https://www.threads.com/@<作者>/post/<捏造代號>", "status": "not_found_or_private", "author": "<作者>", "shortcode": "<捏造代號>", "posted_at_taipei": null, "text": null, "image": null}
前一輪我用 4 個網址測:被限制的分享連結、兩則同作者的公開貼文、一個把最後一碼改掉的捏造代號,4 個都判對。
被限制的貼文,還能知道什麼時候發的嗎?
可以,從貼文代號算。Threads 的代號沿用 Instagram 的 shortcode 格式:把代號當成 64 進位數字(字母表 A–Z a–z 0–9 - _)轉回整數,右移 23 位,就是從 Instagram 自訂紀元 1314220021721 毫秒起算的毫秒數。
def shortcode_time(code: str) -> str:
    n = 0
    for ch in code:
        n = n * 64 + SHORTCODE_ALPHABET.index(ch)
    ms = (n >> 23) + IG_EPOCH_MS
    return datetime.datetime.fromtimestamp(ms / 1000, TAIPEI).isoformat(timespec="seconds")
這不是 Meta 公開文件寫的 API,是我拿公開貼文對時間驗證出來的:上面那則公開貼文解出 2026-11-12 21:10,我 2026-11-13 13:20 看頁面顯示「16 小時」,吻合。被限制的那則解出當天 08:10,比作者時間軸上最新的公開貼文還新,順序也對得上。
這個判讀有哪些限制?
- 結果綁地區。Meta 只在被指違法的地區限制,所以預檢器回的
restricted_by_law是「從這台機器的出口 IP 看」。我只在台灣跑過,境外節點會看到什麼我沒測;把預檢器放到海外主機上跑,結果可能是public。 - 不存在和私人帳號分不開,兩種都導回登入頁。
- 依賴目前的 og meta 格式。這三種簽章是我 2026-11-13 觀察到的,Meta 改版就要重驗;遇到
unknown就該停下來看原始 HTML,不要硬猜成某一類。 - 繞過地區限制不在這支工具的範圍。被限制的貼文,我的處理是標成「內容取得失敗」,要看原文就請手上有截圖的人轉傳,或直接問作者。
接進自己的流程怎麼做?
- 收到
threads.com或threads.net網址時,先跑threads_probe.py。 public:直接用回傳的text與image,需要留言或多張圖再開瀏覽器。restricted_by_law:標成「內容取得失敗」,記下作者、代號與還原出來的發文時間,不再開瀏覽器。not_found_or_private或unknown:存下原始 HTML 給人看,不自動判斷。