懶人包:Strata 是 Niko1221 在 2026-09-24 開源的 MIT 推論引擎,目標只有一個:讓 Qwen3.8-Flash-Next 這個 125B 參數的模型,在一台 12GB 顯卡加 32GB 以上 RAM 的遊戲電腦上跑起來,並在本機開出 OpenAI 與 Anthropic 相容的 API。截至 2026-10-15 有 24,998 顆星、最新版 0.1.44.1,幾乎每天出一版。我把 repo clone 下來讀文件和原始碼,在自己的 8GB M2 MacBook 跑了官方的硬體檢查。檢查會通過,但 8GB 遠低於官方實測過的最小 32GB,所以我沒有下載模型。這篇講清楚它怎麼做到、要什麼硬體、怎麼接 Claude Code,以及目前的限制。
Strata 這個名字在 GitHub 上撞名很多(Linux 檔案管理器、OpenGamma 的金融函式庫、Klavis 的 MCP router 都叫 Strata)。這篇講的是 Niko1221/Strata,也就是最近在「本機跑大模型」圈子爆紅的那個。
Strata 是什麼?
Strata 是一個專門為單一模型家族打造的推論引擎,加上一鍵安裝程式。它不是 Ollama 或 LM Studio 那種「什麼模型都能載」的通用工具,引擎針對 Qwen3.8-Flash-Next 的架構重寫了核心,部分元件沿用 llama.cpp/ggml。
我在 2026-10-15 查到的專案狀態:
| 項目 | 數值 | 來源 |
|---|---|---|
| Repo | Niko1221/Strata,MIT,主要語言 C++ | GitHub API |
| 建立日期 | 2026-09-24 | GitHub API |
| Stars/Forks | 24,998/2,563 | GitHub API |
| 最新版 | v0.1.44.1(2026-10-14) | GitHub releases |
| Commit 數 | 2,174,其中 1,397 筆出自作者本人 | 本機 git log |
| Open issues + PR | 916 | GitHub API |
| 支援平台 | Windows、Linux;Mac 為實驗性 | README |
Qwen3.8-Flash-Next 是什麼模型?
Strata 跑的是 Qwen 團隊 2026-08-24 在 Hugging Face 發布的 Qwen3.8-Flash-Next。官方 model card 稱它是 Qwen4 架構的實驗性預覽。關鍵規格:
| 規格 | 數值 |
|---|---|
| 參數量 | 125B,每個 token 啟用 6B;另有 51B n-gram embedding 和 4B MTP |
| 層數 | 48 層 |
| MoE | 每層 512 個 expert,每個 token 選 10 個 routed + 1 個 shared |
| 原生 context | 262,144 tokens(官方說可擴到 1M) |
| 輸入 | 文字 + 圖片(附 vision encoder) |
| 授權 | qwen-community-1.0,不是 MIT |
授權要分開看:Strata 引擎是 MIT,模型權重走 Qwen 自己的 community license。要拿去商用,請先讀模型的 LICENSE。
12GB 顯卡怎麼塞得下 125B 模型?
重點在 MoE 的特性:模型雖然有 125B 參數,每個 token 只會動到其中約 6B。Strata 依照使用頻率,把 24,576 個 expert 分層放到電腦的不同位置。
README 和 HOW_IT_WORKS.md 的說法,整理起來是四層:
- 顯卡放最常被選中的幾千個 expert,熱門的走最快的路。
- RAM 放全部 expert,顯卡沒有的由 CPU 同時算。這也是為什麼 RAM 決定你能選哪個量化大小。
- SSD 放那 51B 參數的 n-gram embedding(官方 model card 說這種 embedding 本來就比 MoE 更適合 offload),檔案約 28.8GB,一次只讀幾行。
- 猜了再驗:一個小的 MTP draft 層先猜後面幾個 token,大模型一次驗完,README 寫輸出完全相同、速度快 1.6-1.8 倍。
跑 Strata 需要什麼硬體?
官方 README 的最低需求:
| 項目 | 需求 |
|---|---|
| 顯卡 | NVIDIA RTX 20/30/40/50 系列,或 AMD RX 7700 XT 以上、RX 9060 XT/9070 系列等,12GB VRAM 以上 |
| RAM | 32GB 以上,64GB 所有量化大小都能跑 |
| 硬碟 | 約 80GB 空間,建議 SSD |
| 系統 | Windows 10/11 或 Linux,加上新版顯卡驅動 |
| 你的 RAM | 建議選 | 備註 |
|---|---|---|
| 32GB | Coder | 砍掉一半 expert 的程式碼專用版 |
| 48GB | IQ2_XS 或 Q2_0 | 更大的放不下 |
| 64GB | IQ2_XS(推薦)、IQ3_XXS、IQ3_S | IQ3_S 品質最好也最慢 |
| 96GB 以上 | IQ3_S 或 Unsloth UD-IQ4_XS | — |
Tesla P40/V100、Intel Arc、AMD Strix Halo 和 Apple Silicon Mac 都有社群貢獻的實驗性支援,各自有獨立文件。
Strata 速度有多快?
以下全部是作者在自己機器上測的數字,我沒有能驗證的硬體。README 用兩台遊戲電腦測,生成 4K tokens、prompt 32K tokens:
| 量化 | RTX 5070 12GB + 64GB RAM 生成 | 讀 prompt | RX 9070 XT 16GB + 47GB RAM 生成 | 讀 prompt |
|---|---|---|---|---|
| Q2_0 | 94 tok/s | 2,650 tok/s | 60 tok/s | 1,160 tok/s |
| IQ2_XS | 79 tok/s | 2,090 tok/s | 52 tok/s | 1,110 tok/s |
| IQ3_S | 53 tok/s | 1,620 tok/s | — | — |
| Coder | 55 tok/s | 2,180 tok/s | 44 tok/s | 1,420 tok/s |
想知道自己電腦實際多快,官方附了 BENCH.bat/./bench.sh,跑 5-10 分鐘會輸出一份可以分享的報告。
怎麼安裝 Strata?
Windows 和 Linux 的流程一樣:下載 repo,執行安裝腳本,回答幾個問題(模型大小、context 長度、要不要讀圖),按 Enter 就是推薦值。
git clone https://github.com/Niko1221/Strata && cd Strata

# Windows:直接雙擊 START-HERE.bat
# Linux / Mac:
./setup.sh

# 只檢查硬體、不安裝
./setup.sh --check
安裝程式會下載約 70GB 的模型,斷線重跑會續傳。裝好後瀏覽器自動開 http://127.0.0.1:8080,裡面有 Chat、即時監看 GPU/CPU/RAM 的 Monitor 頁,和顯示設定的 About 頁。
第一次啟動電腦會卡 1-3 分鐘。README 特別寫了這是正常的:Strata 要把 35-55GB 載進 RAM,並鎖住一部分給顯卡用,這段時間不要關視窗。
Mac 版沒有現成的執行檔,./setup.sh 會在你的 Mac 上從原始碼編譯 Metal 引擎(官方說約 7 分鐘),需要先裝 Command Line Tools(xcode-select --install),且要 macOS 15 以上。
README 另外提供一種裝法:把一行指令貼給 Claude Code、Cursor 或 Codex,讓 AI 照著 docs/AI_SETUP.md 幫你檢查硬體、挑模型、安裝、啟動。
怎麼把 Strata 接到 Claude Code 和 Codex?
Strata 啟動後在本機同時開三種 API:
| 介面 | 位址 | 給誰用 |
|---|---|---|
| OpenAI Chat Completions | http://127.0.0.1:8080/v1 | 一般 OpenAI 相容工具,API key 和模型名隨便填 |
| Anthropic Messages | http://127.0.0.1:8080/v1/messages | Claude Code、Anthropic SDK |
| OpenAI Responses | http://127.0.0.1:8080/v1/responses | Codex CLI |
export ANTHROPIC_BASE_URL=http://127.0.0.1:8080
export ANTHROPIC_AUTH_TOKEN=anything        # 有設 api_key 就填那個
export ANTHROPIC_MODEL=<Claude Code 認得的 Claude 模型名>
claude
ANTHROPIC_MODEL 要填 Claude Code 認得的名字,因為 Claude Code 會拒絕它不認識的模型名,Strata 收到後則會忽略這個欄位。
有個細節我讀到覺得很實用:Claude Code 每次請求都會在 system prompt 裡蓋一個會變動的 billing header,正常情況下這會讓 prompt cache 每次都失效。Strata server 把這兩個戳記固定掉,讓 system prompt 和工具清單每輪都被視為同一段 prompt,可以重用快取,不用每次從頭讀。對 agent 這種 system prompt 很長的用法,這差很多。
Claude Code 接本機模型的整體接法(Ollama、claude-code-router、網路搜尋怎麼補)我在 Claude Code 接本地模型還能上網嗎? 整理過,Strata 自帶 Anthropic 相容端點,可以直接當那篇裡的本機後端。
我在 8GB M2 MacBook 上實際跑了什麼?
我手上只有一台 Apple M2、8GB 統一記憶體的 MacBook。官方 Mac 文件寫得很清楚,實測過的只有 128GB 的 M5 Max 和 32GB 的 M4 Mac mini,所以我沒打算硬跑模型,只做三件事:clone repo、讀 Mac 安裝程式的原始碼、跑官方的 --check。
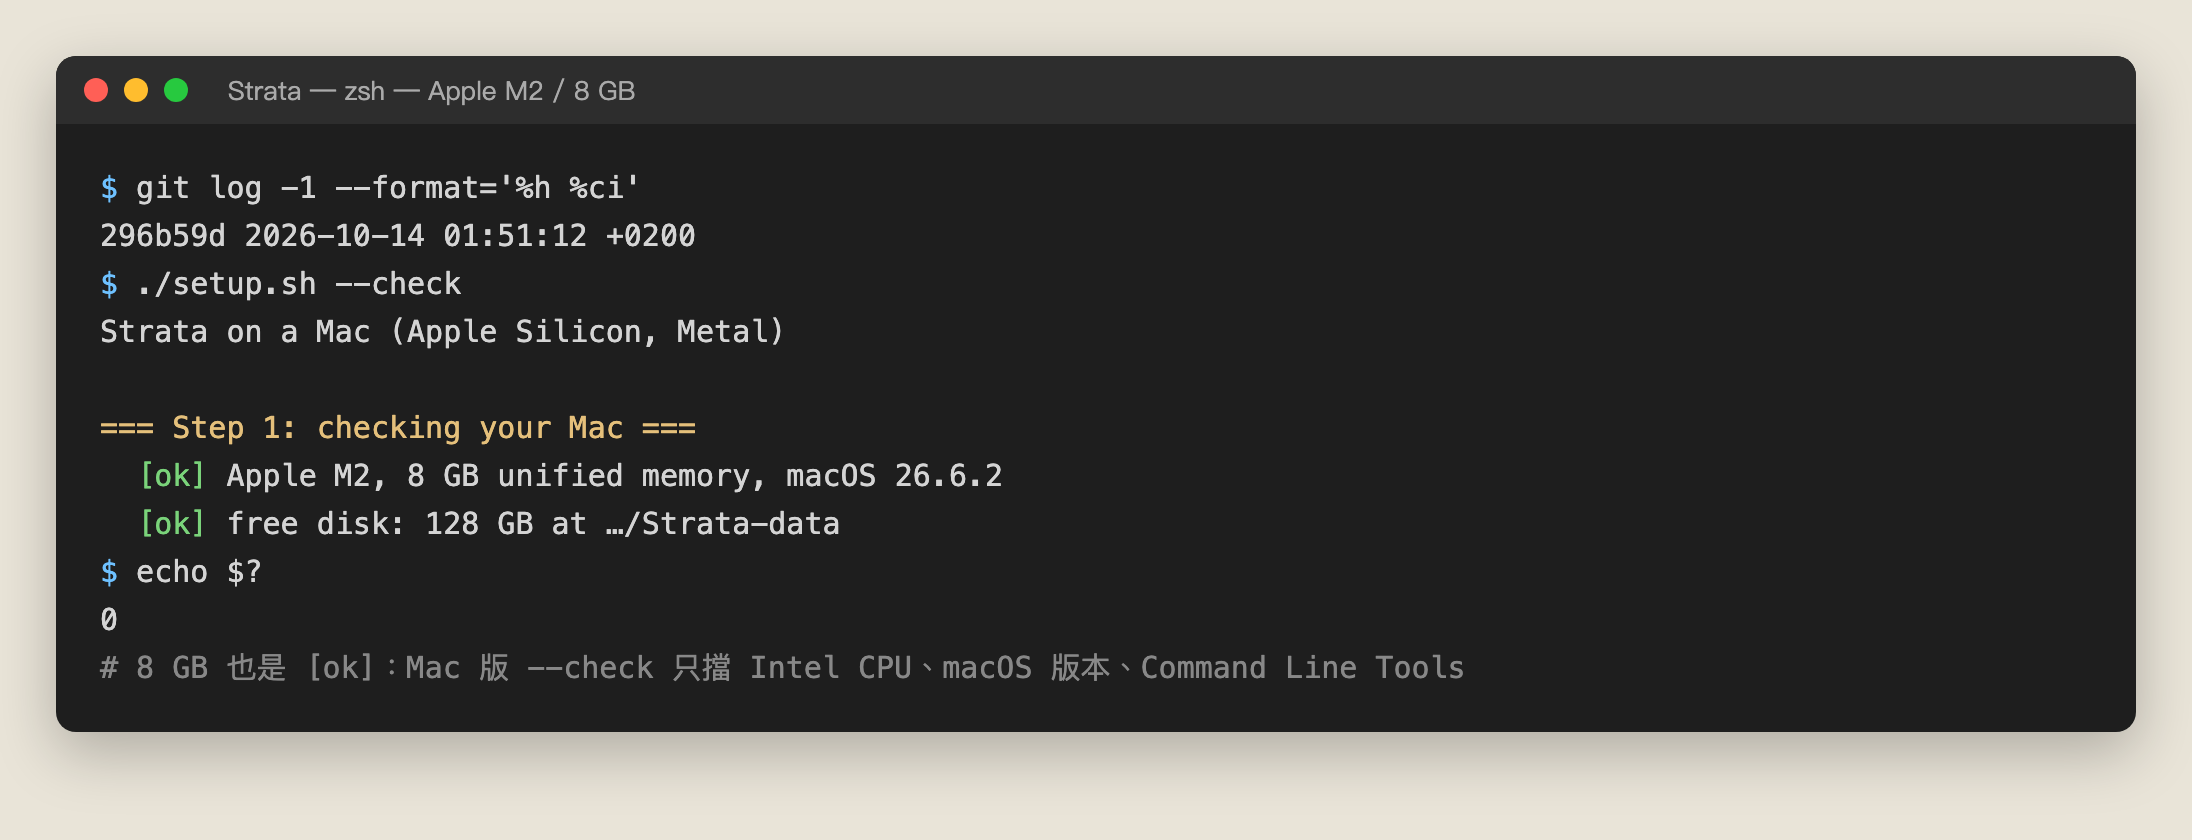
結果是兩項 [ok],exit code 0。我回頭讀 metal/setup_mac.py,擋住安裝的條件只有三個:
def mac_problems(info: dict) -> list[str]:
    """What stops the setup on this Mac (each with what to do)."""
    p = []
    if not info["arm64"]:
        p.append(...)  # Intel Mac
    if macos_tuple(info["macos"]) < MIN_MACOS:
        p.append(...)  # macOS 15 以下
    if not info["clt"]:
        p.append(...)  # 沒有 Command Line Tools
    return p
記憶體不在擋的條件裡。這是刻意的設計,Mac 文件寫的原則是「Setup recommends, and never forces」:記憶體不夠時,引擎會自動改成從 SSD 串流 expert。依 recommend_model() 的邏輯,8GB 的 Mac 會被推薦 Q2_0 串流模式,同時附上一句「smaller Macs are untested」。
所以 --check 綠燈的意思是「這台 Mac 能編譯、能啟動引擎」,不是「這台跑得順」。32GB 的 M4 串流模式,作者實測依可用記憶體落在約 7-14 tok/s,8GB 的機器扣掉 macOS 自己要的 7GB 後,幾乎沒有空間放 expert 快取。加上下載就要 66-84GB,我判斷不值得在這台機器上試。要在 Mac 上用 Strata,看 32GB 以上的機器再開始。
Strata 有什麼限制?
- 預設一次只處理一個請求。其他請求排隊,要並行得在設定加
"parallel": 2,12GB 顯卡上每個回答會變慢。Mac 版還沒移植並行功能。 - 第一則訊息讀得慢。長 prompt 約每 30,000 tokens 要 1 分鐘,之後的追問幾秒就開始回。
- Mac 支援非常新。2026-10-07 作者還在 issue #836 回覆「沒有 Metal backend,不支援 Apple Silicon」;
metal/目錄的第一筆 commit 是 2026-10-12。0.1.44 發布當天就出了 0.1.44.1,修正「M4/M5 以外的 Mac」等問題。 - AMD 在 Windows 上還不能讀圖,Linux 則是由 CPU 處理圖片。
- 只跑這個模型家族。0.1.44 加了 Qwen3.6-35B-A3B,但它不是通用推論引擎,換別家模型請用 llama.cpp、Ollama 這類工具。
- 版本變動快。三週 51 個 release,安裝前以 GitHub 上最新的 README 為準,不要照抄舊教學(包含這篇)的參數。
什麼情況值得裝 Strata?
| 你的狀況 | 建議 |
|---|---|
| 有 12GB 以上 NVIDIA/AMD 顯卡 + 64GB RAM,想要不上雲的強模型 | 值得裝,這是它的目標族群 |
| 32GB RAM、主要寫中文 | 只能選 Coder,中文較弱,先評估 |
| 想給 Claude Code/Codex 一個本機後端 | 可以,三種 API 都有 |
| 需要多人同時用、高併發 | 預設單請求,不適合當服務 |
| Mac 32GB 以下 | 能裝但是串流模式,速度有限;16GB 以下官方沒測過 |
| 想跑各種不同模型 | 選通用工具,Strata 是專用引擎 |
./setup.sh --check(Windows 用 START-HERE.bat --check)。不過看完我的結果你也知道,Mac 上的綠燈不保證跑得順,記憶體要自己對照上面的表格。