懶人包
- OpenViking 是火山引擎開源的 AI Agent 上下文資料庫,把知識文件、使用者記憶、技能放進同一個
viking://檔案系統;2026-11-10 查詢時 GitHub 41,931 星、最新版 v0.5.4、授權 AGPL-3.0。- 我在 Windows 本機裝 v0.5.4,搭 OpenAI 的 text-embedding-3-small 與 gpt-4o-mini:匯入 4 份小文件花 33.4 秒、21,933 tokens,3 題繁中查詢的第 1 名都找對。
- 一段 6 句的對話 commit 後,它自動抽出「不用 Flyway」「k3s 健康檢查用 /actuator/health」等記憶,換一個 session 用
ov find查得回來(分數 0.847)。- 新對話說「部署改成只在週三晚上」,舊偏好被原地改寫成 version 2,沒有多存一份重複的記憶。
- 三個坑:gpt-4o-mini 要在
ov.conf手動設vlm.max_tokens,不然記憶萃取直接 400;目錄摘要預設把繁體輸出成簡體,設output_language_override: "zh-TW"才變繁體;官方一鍵安裝腳本只支援 macOS/Linux。
我想知道一件事:OpenViking 宣稱能同時管 RAG 知識庫和 agent 長期記憶,還會在新對話跟舊記憶衝突時自己改寫,這些在本機到底跑不跑得起來。所以我在 Windows 上照官方流程裝了 v0.5.4,餵自己的測試文件和一段模擬對話,每一步都留了輸出。
結論先講:三件事都跑通了,但要先補兩行設定:記憶萃取的 max_tokens,和摘要的輸出語言。
OpenViking 是什麼?
OpenViking 是字節跳動旗下火山引擎(volcengine)開源的專案,README 的定位是「Self-evolving Context Database for AI Agents」,要把 Agent Memory、Knowledge RAG、Skills 三件事統一管理。2026-11-10 我用 GitHub API 查到的狀態:
| 項目 | 數值 |
|---|---|
| Stars/Forks | 41,931/3,433 |
| 建立日期 | 2026-01-05 |
| 最新 release | v0.5.4(2026-11-09) |
| 授權 | AGPL-3.0(主專案) |
viking://resources/,使用者記憶在 viking://user/<id>/memories/,agent 用 ls、tree、read、find 這類指令瀏覽。記憶本身是 Markdown 檔,人也能直接打開來改。
L0/L1/L2 分層摘要怎麼運作?
每個被處理過的目錄會自動多出兩個檔:
| 層級 | 檔案 | 內容 |
|---|---|---|
| L0 | .abstract.md | 一句話摘要,用來快速判斷相不相關 |
| L1 | .overview.md | 導覽頁,列重點和子目錄連結 |
| L2 | 原始檔 | 完整原文,真的需要才讀 |
我怎麼在本機裝起來?
我的環境是 Windows 11、Python 3.11、uv。官方 README 寫的一鍵安裝 curl -fsSL https://openviking.ai/install | bash 標明需要 macOS 或 Linux,Windows 要用桌面版,所以我改用 pip 套件直接起 server:
uv venv .venv --python 3.11
uv pip install --python .venv/Scripts/python.exe openviking   # 實裝到 0.5.4
export OPENAI_API_KEY=<你的 key>
.venv/Scripts/openviking-server.exe --config ov.conf        # 預設聽 127.0.0.1:1933
ov.conf 我只設 embedding、VLM(負責摘要與記憶萃取的 LLM)、儲存位置三塊。key 用環境變數引用,不寫死在檔案裡:
{
  "storage": {"workspace": "./ov-data"},
  "embedding": {"dense": {"provider": "openai", "model": "text-embedding-3-small",
    "api_key": "${OPENAI_API_KEY}", "api_base": "https://api.openai.com/v1", "dimension": 1536}},
  "vlm": {"provider": "openai", "model": "gpt-4o-mini",
    "api_key": "${OPENAI_API_KEY}", "api_base": "https://api.openai.com/v1",
    "temperature": 0.0, "max_retries": 2, "max_tokens": 16000},
  "server": {"host": "127.0.0.1", "port": 1933}
}
max_tokens: 16000 這行是後來踩坑才補的,下面會講。CLI 端接上 server:
.venv/Scripts/ov.exe config add custom --name local --url http://127.0.0.1:1933 --activate實測一:知識檢索準不準?
測試語料是我寫的假專案 demo-shop,4 份短文件:backend/auth.md(登入與權限)、backend/database.md(MSSQL、不用 Flyway、備份策略)、frontend/ui.md、ops/deploy.md(GitHub Actions 推 ghcr.io、k3s 部署與回滾)。內容都是繁體中文。
ov add-resource ./corpus/demo-shop --wait| 指標 | 實測值 |
|---|---|
| 狀態 | success,4 檔都用 MarkdownParser 解析 |
| 產生的 context 數 | 20 |
| 耗時 | 33.4 秒 |
| tokens | 21,933(LLM 15,411+embedding 6,522) |
接著用 ov find 問三題:
| 查詢 | 第 1 名 | 分數 |
|---|---|---|
| 帳號被鎖多久會解開 | backend/auth/auth.md | 0.740 |
| 怎麼回滾上線失敗的版本 | ops/deploy/deploy.md | 0.646 |
| 資料庫要用 Flyway 嗎 | backend/database/database.md | 0.798 |
ui.md 拿 0.644,只差 0.002,算是險勝。加上 --uri viking://resources/demo-shop/ops 可以把搜尋限縮在某個子樹,題目範圍明確時這樣比較穩。ov read 讀回的 L2 原文跟原檔一致。
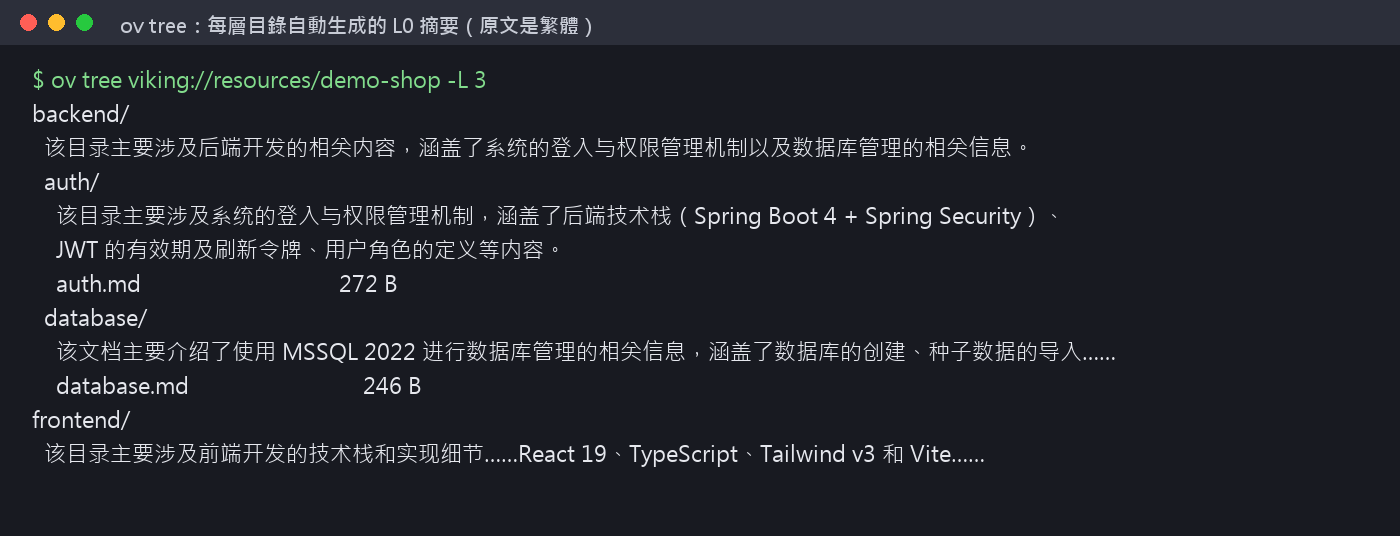
摘要內容抓得到重點,例如 auth 目錄寫到 Spring Boot 4、JWT 有效期、角色定義。問題是原文是繁體,摘要卻輸出成簡體。
翻原始碼找到原因:openviking/session/memory/utils/language.py 的語言偵測,中文候選只有 zh-CN,繁體文件也會被判成簡體。設定檔有一個 output_language_override 欄位,說明寫著非空值會跳過偵測、強制摘要與記憶萃取用指定語言。我在 ov.conf 最外層加一行,另開一個乾淨的資料目錄重匯 database.md:
{
  "output_language_override": "zh-TW",
  "storage": {"workspace": "./ov-data-zhtw"}
}
embedding、vlm、server 三塊跟前面一樣,這裡省略。ov tree 的結果:
backend/
  這個資料夾主要涵蓋與後端開發相關的內容,特別是資料庫設置和管理。根據提供的摘要,資料夾內的內容包
  括使用 MSSQL 2022 的建表 SQL 腳本、種子資料的 SQL...
  database/
    這份資料夾主要提供有關使用 MSSQL 2022 的資料庫設置和管理的指導。內容涵蓋建表的 SQL
    腳本、種子資料的 SQL...
摘要變成繁體字了。用詞還有「設置」「腳本」這類對岸慣用語,要完全台灣用語得再處理。
實測二:對話記憶能自己抽出來嗎?
我送進一段 6 句的對話,內容是「我是 Bob、回答用繁體中文」「資料庫不用 Flyway,用 create_table.sql 加 seed_data.sql」「部署習慣週二週四晚上」「上次 k3s 部署失敗是 health check 寫成 /health,正確是 /actuator/health」。然後 commit 這個 session,讓背景 LLM 去抽記憶。
第一次 commit 直接失敗:
status  failed
error   Error code: 400 - {'error': {'message': 'max_tokens is too large: 32768.
        This model supports at most 16384 completion tokens, whereas you provided 32768.'}}
原因在 openviking/session/memory/extract_loop.py 第 58 行,記憶萃取的預設輸出上限是 32768。原始碼註解寫得很清楚:這個值是照豆包模型調的,輸出上限比它低的模型(註解舉的例子就是 gpt-4o-mini 的 16384)要自己在 ov.conf 設 vlm.max_tokens。我加上 "max_tokens": 16000、重啟 server,重新 commit 就過了:
status              completed
processing_seconds  16.6
memories_extracted  {"memory_write": 2, "memory_edit": 1}
抽出來的東西:
| 記憶檔 | 內容 | 評價 |
|---|---|---|
preferences/bob/專案資料庫使用習慣.md | 不用 Flyway、用兩支 SQL;部署週二週四晚上 | 正確 |
events/2026/11/10/k3s健康檢查修正.md | 一句摘要加原始對話紀錄 | 正確 |
identity.md | 把 Bob 填進範本,但範本的 Creature 欄是「AI assistant」 | 填錯:這是 agent 自己的身分檔 |
接著換一個新 session,只問「k3s 健康檢查路徑該填什麼」,限定在記憶目錄搜尋:
ov find "k3s 健康檢查路徑該填什麼" --uri viking://user/default/memories第 1 名就是 k3s健康檢查修正.md,分數 0.847。跨 session 的回想是通的。
實測三:記憶衝突時會改寫還是重複堆?
這是我最想驗的部分。如果新資訊只是新增一筆、舊的那筆還留著,記憶久了就會互相矛盾。
我開第三個 session,只說一句「部署改成只在週三晚上」,再 commit。結果是 memory_edit: 1,沒有 memory_write。偏好目錄裡還是只有一個檔案,內容被改寫了:
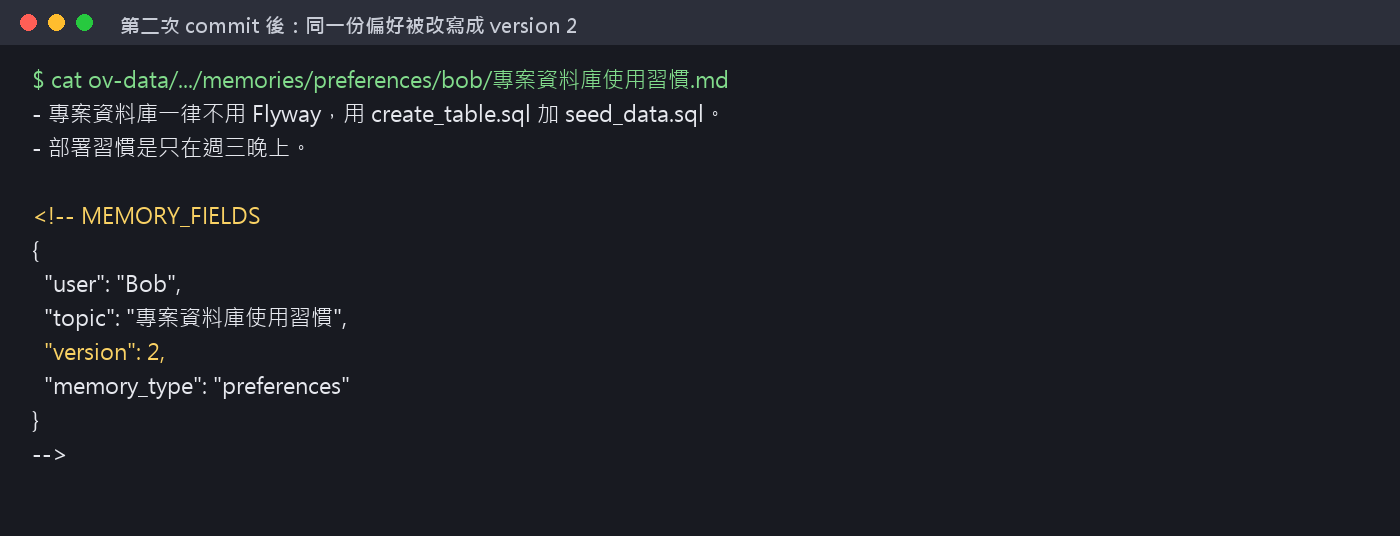
「不用 Flyway」那行保持不動,只有部署那行從「週二週四」變成「只在週三」,檔尾的 version 從 1 變成 2。README 說的 self-evolving,在這個單一案例裡行為符合預期。
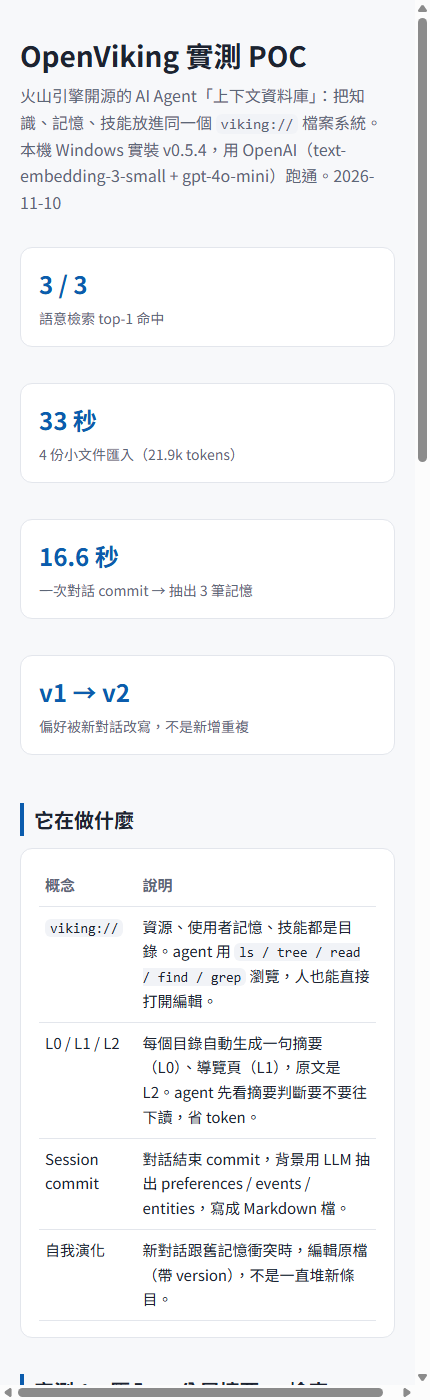
我把三組實測整理成一頁結果,放在 html.yanchen.app/openviking-poc:
官方 benchmark 說了什麼?
README 引用 v0.3.22 的評測,接 OpenViking 前後的 LoCoMo 長對話記憶準確率:
| Agent | 原生記憶 | 接 OpenViking |
|---|---|---|
| OpenClaw | 24.20% | 82.08% |
| Hermes | 33.38% | 82.86% |
| Claude Code | 57.21% | 80.32% |
哪些情況先不要用?
- 要做成對外產品的底層:主專案是 AGPL-3.0,網路服務也有開源義務。README 另外聲明不允許把整個專案改寫後重新開源。
- 知識庫很大、預算很緊:每層目錄都要 LLM 生摘要,我 1 KB 不到的語料就花了 15k LLM tokens。
- 需要台灣用語的摘要給人看:設
output_language_override能變繁體字,但用詞仍偏對岸,直接給使用者看要再潤一次。 - 只有 Windows、想用一鍵安裝:官方安裝腳本要 macOS/Linux+Node.js 18+curl。Windows 可以像我一樣用 pip 起 server,或用官方桌面版。
接下來怎麼試?
如果你在用 Claude Code、Codex 或 Cursor,README 有官方記憶外掛安裝流程,會改你 agent 的設定,建議先在測試機或另一個帳號上試。我的做法是先照本文起一個本機 server,用自己的文件跑一次 add-resource 和 find,看摘要品質和 token 成本能不能接受,再決定要不要接 agent。
相關文章:
- 〈個人知識庫怎麼讓 AI 真的用上?Obsidian + Claude Code hook 讀寫兩條路實作〉:我現在用的記憶做法,跟 OpenViking 解同一類問題。
- 〈ANNsmemory 是什麼?Claude Code 認知記憶外掛完整教學〉:另一個 Claude Code 記憶外掛的實測。