懶人包
- Google Cloud 在 2026-11-11 公布 Professional Agentic Architect 認證;官方認證頁寫的是 2 小時、50–60 題選擇題、200 美元、英文、效期 1 年、沒有報考資格限制。
- 這張證照分兩關:Pearson 監考的選擇題過了,才會收到 Google Skills 實作 lab 的考試通知,要在真的雲端環境裡建、測、除錯 agent。
- 官方考綱 5 大範圍裡,「自訂 agent」佔 33%、「評測與部署」佔 22%,兩項加起來超過一半;考綱 2.1 直接點名 Claude Code on Google Cloud。
- 我用 Google ADK 2.14.1 照考綱 4.1 做了一份 golden evalset:正常版 3 題全過,把 agent 改成永遠呼叫錯的 tool 之後 3 題全被抓出來。
- 這次受測的是規則式假模型(手上的 Gemini key 失效),所以驗到的是 ADK 評測流程,不是任何 LLM 的能力。
這篇回答兩個問題:Google 新出的 AI Agent 架構師認證到底考什麼、值不值得考? 還有考綱最重的「agent 評測」實際長什麼樣子?起點是 Threads 上 @aiposthub 的一篇貼文,它把官方公告整理得很清楚。我把貼文裡的數字逐一對回官方認證頁和 exam guide,再用 Google 自家的 Agent Development Kit(ADK)把考綱 4.1 那段 golden evalset 實際跑了一次。
Professional Agentic Architect 是什麼認證?
它是 Google Cloud 的專業級(Professional)認證,2026-11-11 在 blog.google 公布,Google Cloud Blog 在 11-12 補了一篇格式說明。官方 exam guide 對持證人的描述是:在 Google Cloud 上設計、管理自主 agent 工作流程的技術人員,要同時顧到可靠性、效能、成本、安全和擴充性。
我在 2026-11-13 重新打開官方認證頁,規格如下:
| 項目 | 官方認證頁寫的 |
|---|---|
| 考試時間 | 2 小時 |
| 題數與題型 | 50–60 題選擇題 |
| 報名費 | 200 美元(另計稅) |
| 語言 | 英文 |
| 考試方式 | 線上監考或考場監考 |
| 效期 | 1 年 |
| 報考資格 | 無 |
| 建議經驗 | 3 年以上雲端實務,其中 1 年以上在 Google Cloud 做 agent |
第三方網站 certcrush 的備考文寫的是「約 80 題、3 小時」,那篇談的是 Beta 版考試。準備正式版時,題數和時間以官方認證頁為準。
為什麼說它「要動手做出 agent」?
官方認證頁把認證拆成兩部分:
- Part 1:選擇題。由 Pearson 監考,考概念、系統設計取捨和架構標準。
- Part 2:實作 lab。選擇題通過後,會在 CM Connect 收到通知,去 Google Skills 考 PAA 專屬的 hands-on lab。Google Cloud Blog 的說法是把你放進真的雲端環境,建、測、除錯正在跑的 agent 工作流程。
考綱 5 大範圍各佔多少?
下表整理自官方 exam guide PDF(4 頁):
| 範圍 | 權重 | 考綱點名的工具 |
|---|---|---|
| 1. 用低程式碼工具建 agent | ~13% | Gemini Enterprise Workflow Builder、CX Agent Studio、Agent Search |
| 2. 用 coding agent 開發應用 | ~17% | Antigravity、Claude Code on Google Cloud、MCP、Agents CLI |
| 3. 開發自訂 agent | ~33% | ADK、Memory Bank、Vector Search、Agent Identity、Agent Registry、A2A |
| 4. 評測與部署 agent | ~22% | ADK evalset、Gen AI evaluation service、Agent Runtime、Cloud Run、GKE |
| 5. agent 安全與治理 | ~15% | Agent Gateway、Agent Identity(PAB)、Model Armor、HITL |
- 範圍 3 加範圍 4 佔 55%。 寫 agent、評測 agent、部署 agent 是主幹,低程式碼工具只佔 13%。
- 考綱 2.1 寫的是「Antigravity and Claude Code on Google Cloud」。 Anthropic 的 Claude Code 出現在 Google 的考試範圍裡。2.2 考 Antigravity 的 skills、plugins、hooks、rules、subagents,這組概念跟 Claude Code 幾乎一一對應,平常用 Claude Code 的人這段有優勢。
- 產品剛改名。 考綱的工具清單寫明 Agent Runtime 原名 Agent Engine、Agent Search 原名 Vertex AI Search、Workflow Builder 原名 Agent Designer。拿舊教材讀的時候,名稱會對不上。
考綱最重的「agent 評測」,用 ADK 實際跑一次
考綱 4.1 有兩條寫得很具體:建立 golden data 測試集,以及用 ADK evalset 對 golden dataset 評估 agent 的回應品質。我照這個範圍做了一個小 POC,目的是看清楚「評測」在 ADK 裡到底是什麼。
環境與受測 agent
我的環境是 Windows 11、Python 3.11.9,用 venv 裝 ADK:
python -m venv .venv
.venv/Scripts/pip install "google-adk[eval]" litellm
.venv/Scripts/pip show google-adk   # Version: 2.14.1
受測 agent 是一個備考教練,用 ADK 的 LlmAgent 掛兩支 tool,資料直接取自官方 exam guide:
def get_section(section: int) -> dict:
    """Return the official exam-guide section info (title, weight %, key tools) for section 1-5."""
    ...

def allocate_study_hours(total_hours: int) -> dict:
    """Split total study hours across the 5 sections proportional to official exam weights."""
    ...

root_agent = LlmAgent(
    name="paa_coach",
    model=build_model(os.environ.get("COACH_MODEL", "scripted")),
    instruction="... Always call get_section for questions about a specific section, and "
                "allocate_study_hours for study-plan questions. Never invent weights.",
    tools=[get_section, allocate_study_hours],
)
問它「我有 40 小時準備,怎麼分配?」,它會呼叫 allocate_study_hours(40),照權重分成 5.2、6.8、13.2、8.8、6.0 小時。
golden evalset 長這樣
evalset 是一份 JSON,每筆寫三件事:使用者問什麼、預期呼叫哪支 tool 帶什麼參數、預期最後回答。下面是 3 筆裡的第 1 筆(節錄):
{
  "eval_id": "section3_weight",
  "conversation": [{
    "user_content": {"parts": [{"text": "Section 3 佔考試幾%?"}], "role": "user"},
    "final_response": {"parts": [{"text": "Section 3 (Developing custom agents) is 33% of the exam; key tools: ADK, ..."}], "role": "model"},
    "intermediate_data": {
      "tool_uses": [{"name": "get_section", "args": {"section": 3}}]
    }
  }]
}
門檻寫在同目錄的 test_config.json:
{
  "criteria": {
    "tool_trajectory_avg_score": 1.0,
    "response_match_score": 0.6
  }
}
tool_trajectory_avg_score 看 agent 呼叫 tool 的順序和參數是否跟預期完全一樣;response_match_score 比對最後回答跟預期回答的相似度。執行用 ADK 的 AgentEvaluator:
await AgentEvaluator.evaluate("cert_coach", "eval/paa_coach.test.json", num_runs=1)正常版全過,改壞版全被抓
我跑了兩個版本。正常版照問題選對 tool;改壞版模擬 prompt 被改壞,不管問什麼都呼叫 get_section(1)。
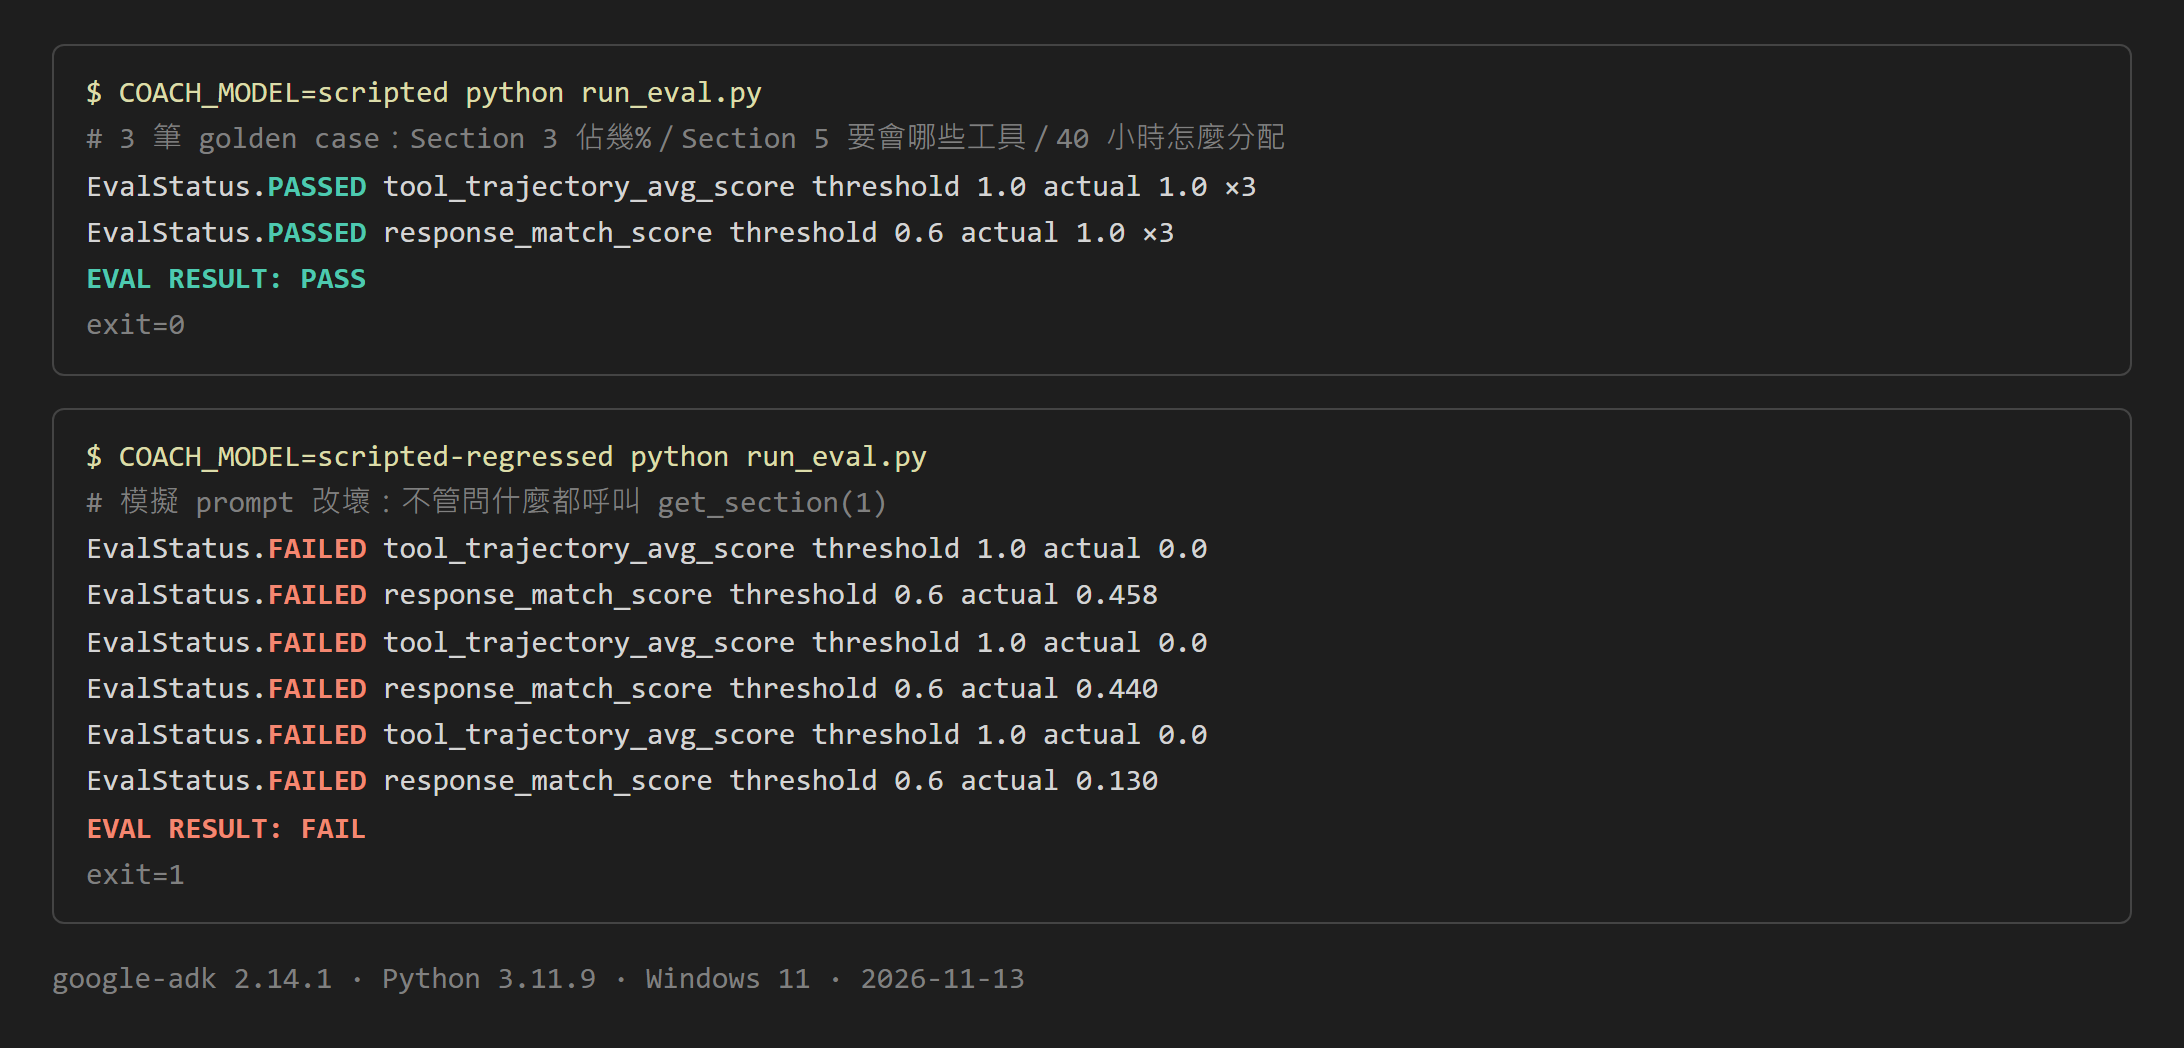
上圖整理自 2026-11-13 兩次實跑的輸出。改壞版三筆的 tool 軌跡分數都是 0.0,回答相似度掉到 0.13–0.46,AgentEvaluator 丟出 AssertionError,程式以 exit code 1 結束,可以直接接進 CI 當回歸測試。
這就是考綱 4.1「continuous evaluation pipeline」在最小規模下的樣子:把預期行為寫成資料,每次改 prompt、換模型或加 tool 都重跑一次,分數掉了就擋下來。
這次實測有什麼限制、哪裡失敗了?
受測模型是我寫的規則式假模型,不是 LLM。 我寫了一個繼承 ADK BaseLlm 的 ScriptedLlm,用正規式判斷該呼叫哪支 tool。原因是這台機器上兩把 Gemini API key 打 generativelanguage.googleapis.com 都回 API_KEY_INVALID,改走 LiteLLM 接 OpenAI 也回 401,本機 Ollama 起不來。
所以這次證明的是:ADK 的 Runner、evalset 格式、AgentEvaluator 這條評測管線能跑,而且真的抓得到 tool 軌跡退化。它沒有證明任何 LLM 的推理品質。換上有效的 Gemini key 後,把 COACH_MODEL 設成 Gemini 模型名,同一份 evalset 就能拿來測真模型。
另一個要注意的點:response_match_score 是文字相似度,LLM 換個說法回答,分數就可能掉到門檻下。真模型上場時,0.6 這個門檻要依實際輸出重新校準,或改用考綱也提到的 Gen AI evaluation service、自訂 autorater 來評語意。
誰適合考這張證照?
我的判斷:
- 主力在 Google Cloud、工作要交付企業 agent 的人:值得考。考綱涵蓋的 Agent Identity、Agent Gateway、Model Armor 是 GCP 專屬的治理工具,這些在實務上本來就要會。
- 主力在其他雲或用 Claude Code、自架 agent 的人:拿考綱當學習地圖就夠。範圍 2、3、4 的概念(MCP、skills、subagents、多 agent 協作、golden evalset)不綁平台,照著補洞很有效率;但效期只有 1 年、費用 200 美元,為了證照本身去考的 CP 值普通。
- 還沒寫過 agent 的人:官方建議經驗是 3 年雲端加 1 年 GCP agent,而且第二關是實作 lab,先動手做幾個 agent 再說。
延伸資源
- 官方認證頁:規格、報名、樣題連結
- 官方 exam guide PDF:5 大範圍與工具清單
- Google Cloud Blog 公告:兩關混合格式說明
- 還沒系統學過 agent:先看我整理的免費 Agentic AI 課程查證,或照 awesome-agentic-ai-zh 中文學習地圖從 CLI agent 練到自己寫 agent