懶人包
- 學長 Ethan 在 2026-10-30 推的「13 個免費 Claude skill 搞定 Instagram」,原始出處是 Jakeschincariol/instagram-agent-skill(MIT),11/1 查詢 4,214 星、880 forks。
- 原版 hookscore.py 吃中文開場,5 句全判 WEAK(43.4~20.4 分),「哈囉大家好,今天想跟大家聊聊」只被扣分,沒被當成打招呼擋下。
- 原版 caption.py 吃中文文案,4 個 hashtag 只數到 2 個(
#程式設計、#重構漏掉),「留言 PROMPT 我私訊你」判成沒有行動呼籲。- 兩支都是同一個原因:分詞與規則寫死成 ASCII 英文。我寫了 195 行的 zh_ig_lint.py,用中文字數估口播秒數、用中文詞庫抓打招呼與前言,排名變成 88.4/81.6/63.1/19.7/12.8,爛開場正確排到最後。
- 文案檢查改成任何非空白字元都算 hashtag、中文 CTA 用「留言/私訊/收藏…」比對,同一篇文案從 REVIEW 變成 OK;7 項回歸測試全過。
- 中文版的權重與語速(每秒 4.5 字)是我設的假設值,沒有用真實留存資料驗證。它跟原版一樣,只適合擋掉明顯爛的開場,不負責挑爆款。
IG 帳號 @ethanhuang01(學長 Ethan)在 2026-10-30 發了一支 Reel:「Claude 用 13 個免費 skill 搞定了 Instagram」,列出 Reel 寫手、留言、回覆、主頁評分、週計畫、爆款拆解六種用途,封面標著「只起草・不自動發佈」。我抓資料時是 2,922 個讚、6,675 則留言,貼文要你留言「SKILL」拿安裝指南。
它推的就是 instagram-agent-skill。10/30 我寫過一篇中文實測,補好了腳本估時和套話清理,當時留下 hookscore、caption 兩支沒補。這篇把剩下的補完:讓中文開場能被正確排名,讓中文文案的 hashtag 和行動呼籲能被數到。
instagram-agent-skill 的 hook 評分在做什麼?
/ig-reel 會用 26 個 hook 公式幫你寫 Reel 腳本,錄之前先把開場丟給 hookscore.py 打分。它看五個面向:
| 面向 | 原版怎麼量 |
|---|---|
| LENGTH | 開場的英文字數,換算成口播秒數 |
| SPECIFICITY | 數字、金額、大寫開頭的專有名詞 |
| STAKES | 損失、金額、「nobody tells you」這類利害詞 |
| FRONTLOAD | 重點有沒有出現在前幾個字 |
| ADDRESS | 有沒有對「you」說話 |
hey、hi、welcome)、前言(in this video)、要求注意力(stop scrolling)、開場放 emoji。中一項就重扣。
作者自己在 README 公開了實測:抓爛開場 AUC 0.83,從同一個創作者的作品裡挑贏家只有 0.56。所以這支工具的正確用法是「刷掉明顯爛的開場」,下面的中文版也照這個定位設計。
中文開場丟進原版 hookscore 會怎樣?
我準備了 5 句中文開場,從好到爛各一種,用原版跑(python -I -X utf8 hookscore.py hooks_zh.txt):
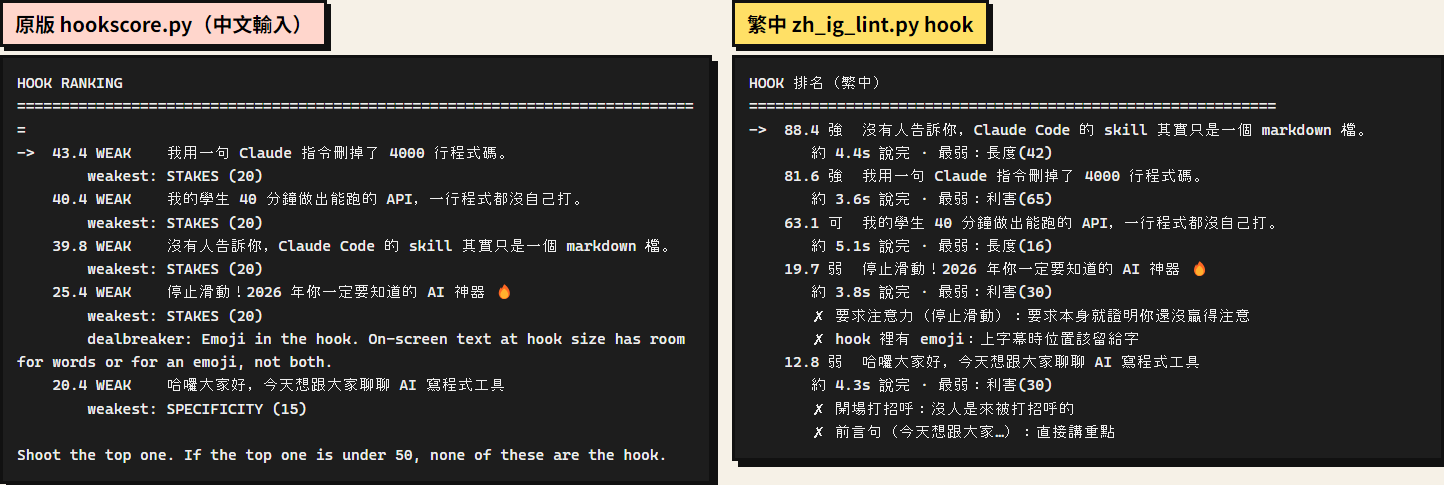
左邊原版的結果:
- 5 句全部 WEAK,最高 43.4。工具最後一行寫「If the top one is under 50, none of these are the hook.」,等於叫你 5 句都不要用。
- 「哈囉大家好,今天想跟大家聊聊 AI 寫程式工具」拿 20.4 分,沒有任何 dealbreaker。打招呼清單是
hey、hi、hello這些英文詞,「哈囉」「大家好」對不到。 - 只有「停止滑動!…🔥」因為 emoji 被抓到,emoji 的 regex 跟語言無關。
WORD_RE = re.compile(r"[A-Za-z0-9$%'’-]+")中文字不在裡面。「我用一句 Claude 指令刪掉了 4000 行程式碼。」只會數到 Claude 和 4000 兩個字,長度、前置、利害的判斷全部建立在這兩個英文 token 上。
同一組開場翻成英文,原版排得很合理:「Nobody tells you that Claude Code skills are just markdown files.」83.0、「I deleted 4,000 lines…」80.8,「Hey guys…」被打成 9.6 並標出打招呼。工具本身沒問題,它就是為英文寫的。
繁中 hook 評分怎麼設計?
zh_ig_lint.py 保留原版的五個面向和 dealbreaker 結構,只把計量單位和詞庫換成中文。單檔、只用 Python 標準函式庫,不連網。
口播秒數改用中文字數算,英文字和數字另外算,一個英文 token 抵 1.5 個中文字:
CHARS_PER_SEC = 4.5   # 中文口播語速假設值,可用 --cps 覆寫
HAN_RE = re.compile(r"[\u3400-\u9fff\uf900-\ufaff]")
LATIN_WORD_RE = re.compile(r"[A-Za-z0-9][A-Za-z0-9$%.,'-]*")

def say_seconds(text, cps):
    han = len(HAN_RE.findall(text))
    latin = len(LATIN_WORD_RE.findall(text))
    return (han + latin * 1.5) / cps
五個面向各 0~100 分,取平均;中一個 dealbreaker 分數乘 0.5:
length = 100 if secs <= 3 else max(0, 100 - (secs - 3) * 40)
specificity = min(100, 25 + concrete * 35)   # 數字+專有名詞個數
stakes = min(100, 30 + 35 * sum(w in hook for w in STAKES_WORDS))
frontload = 100 if (NUM_RE.search(hook[:8]) or any(w in hook[:8] for w in STAKES_WORDS + ["我"])) else 50
address = 100 if any(w in hook for w in ["你", "妳", "你們"]) else 70
score = sum([length, specificity, stakes, frontload, address]) / 5
score = score * (0.5 ** len(deal))
中文 dealbreaker 用四組詞庫比對:
| dealbreaker | 中文詞庫 |
|---|---|
| 打招呼 | 哈囉、嗨大家、大家好、各位好 |
| 前言句 | 今天想跟、今天要跟、今天來、在今天的影片、這支影片、這集我們 |
| 要求注意力 | 停止滑動、先別滑、不要滑走、等等先別走 |
| 開場 emoji | 沿用原版 emoji 範圍 |
NUM_RE = re.compile(r"\d[\d,]*(?:\.\d+)?|[一二兩三四五六七八九十百千萬億]+(?:個|次|年|天|分鐘|小時|行|萬|倍|%|元|塊)")同一組中文開場的結果在上圖右邊:
| 分數 | 判定 | 開場 | 標出的問題 |
|---|---|---|---|
| 88.4 | 強 | 沒有人告訴你,Claude Code 的 skill 其實只是一個 markdown 檔。 | 約 4.4 秒,偏長 |
| 81.6 | 強 | 我用一句 Claude 指令刪掉了 4000 行程式碼。 | 利害詞只中一個 |
| 63.1 | 可 | 我的學生 40 分鐘做出能跑的 API,一行程式都沒自己打。 | 約 5.1 秒,太長 |
| 19.7 | 弱 | 停止滑動!2026 年你一定要知道的 AI 神器 🔥 | 要求注意力、開場 emoji |
| 12.8 | 弱 | 哈囉大家好,今天想跟大家聊聊 AI 寫程式工具 | 打招呼、前言句 |
中文 IG 文案檢查漏了什麼?
/ig-caption 的 caption.py 會模擬動態牆前 125 字元的可見區,檢查首行、hashtag 數量與位置、行動呼籲只有一個。我丟了一篇中文文案進去:
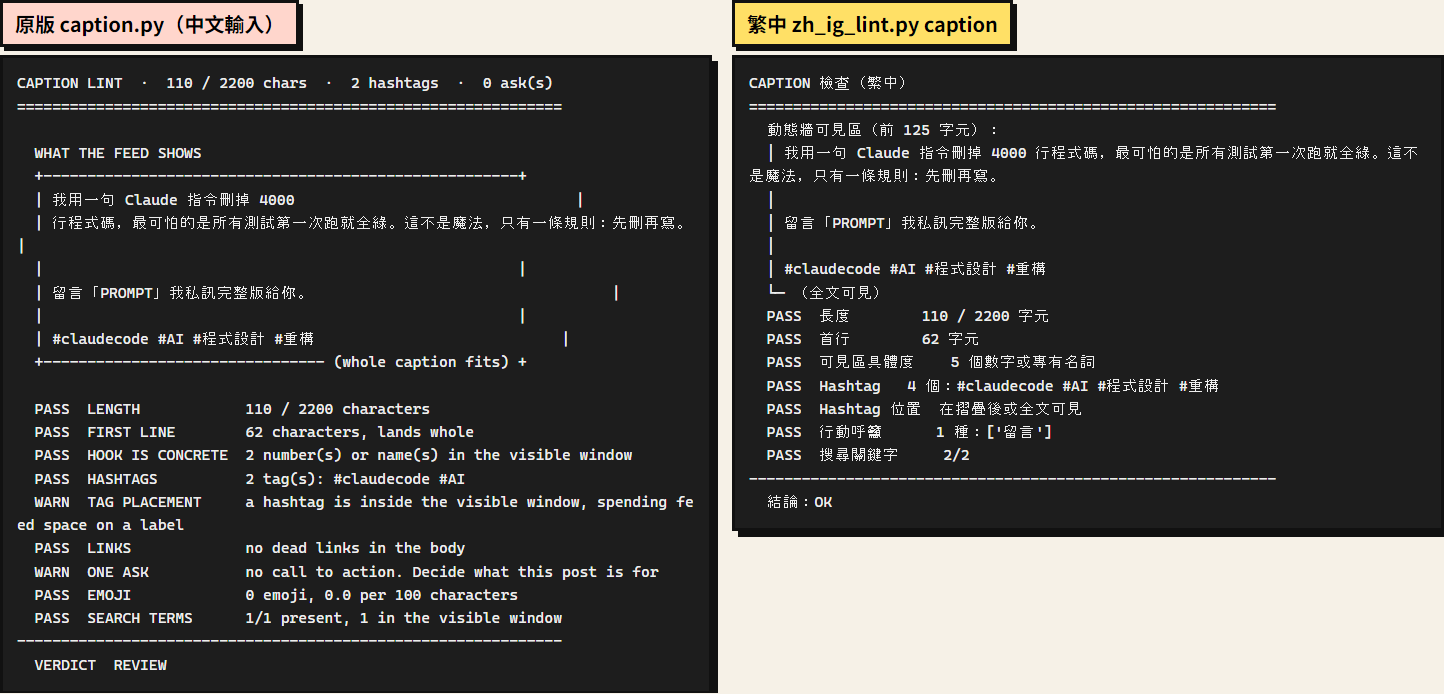
原版漏了兩件事:
- hashtag 只數到
#claudecode #AI。它的 regex 是(?:^|\s)(#[A-Za-z0-9_]+),#程式設計、#重構不符合,等於中文 tag 不存在。IG 從 2025-12-18 起每篇上限 5 個 tag(原版程式註解寫的),中文 tag 數不到,超量也就檢查不出來。 - 「留言「PROMPT」我私訊完整版給你」被判成沒有行動呼籲。原版的 ask 全是英文 pattern,例如
comment (the word )?[A-Z0-9]{2,}、dm me、link in bio。
中文版的改法:
HASHTAG_RE = re.compile(r"#[^\s#]+")       # 任何非空白字元都算 tag 內容
CTA_PATTERNS = [r"留言", r"私訊", r"點.*連結", r"收藏", r"分享給", r"追蹤", r"按讚"]

ctas = [p for p in CTA_PATTERNS if re.search(p, body)]
if "留言" in ctas and "私訊" in ctas:      # 「留言關鍵字 → 私訊給你」是同一個 ask
    ctas = [p for p in ctas if p != "私訊"]
最後那兩行是為了中文 IG 最常見的導流寫法。「留言關鍵字,我私訊你」同時命中「留言」和「私訊」,但它是一個動作,不該被判成兩個 ask。Ethan 這支 Reel 本身就是這個寫法,留言數是讚數的 2.3 倍。
hashtag 位置的判斷也調了一點:全文都在可見區內時,原版仍會警告「hashtag 佔了可見區」,中文版改成只在文案超過 125 字元、tag 又出現在前 125 字元時才警告。短文案整篇都看得到,tag 放哪不影響截斷。
--keywords 參數照原版保留,用來確認搜尋關鍵字有出現在文案裡。
怎麼在自己的電腦跑?
前置:Python 3(我用 3.11.9),不需要裝任何套件。程式是單一檔案,可以直接下載:zh_ig_lint.py(195 行,照原版的評分結構改寫成中文規則,只用標準函式庫)。
# 一行一個開場,輸出排名
python -I zh_ig_lint.py hook hooks.txt

# 文案檢查,可指定要出現的搜尋關鍵字
python -I zh_ig_lint.py caption caption.txt --keywords 重構,Claude

# 去 AI 味,修正後的版本另存
python -I zh_ig_lint.py human draft.txt --write cleaned.txt

# 語速比較快或慢,用 --cps 調整每秒字數
python -I zh_ig_lint.py hook hooks.txt --cps 5.5
中文版在程式開頭就把 stdout 設成 UTF-8,所以在繁中 Windows(cp950)不用另外加 -X utf8。原版在這個環境碰到 emoji 會丟 UnicodeEncodeError: 'cp950' codec can't encode character '\U0001f525',hookscore 和 humanize 都會。
結束碼照原版的慣例:hook 最高分低於 50、文案有任何 WARN/FAIL、去 AI 味後分數低於 70,都回傳 1,可以直接接進發文前的檢查流程。
human 模式這篇不展開。它用 24 條中文 AI 味詞庫做替換(「深入探討」「解鎖」「尖端」…),同一段套話段落自動修正 13 項,另外標出「不只是 X,更是 Y」、emoji 條列、🚀 三種要自己改的句型。原版 humanize 對同一段只刪了 1 個零寬字元,還把全形破折號換成英文半形「, 」。
回歸測試驗了什麼?
我用 7 項測試鎖住上面這些行為,全部通過:
| 測試 | 驗什麼 |
|---|---|
test_greeting_hook_is_dealbreaker | 「哈囉大家好」被標成打招呼 |
test_concrete_hook_beats_vague_hook | 有數字的開場分數高於空泛的開場 |
test_caption_counts_chinese_hashtags_and_single_ask | 中文 tag 數得到,「留言+私訊」算一個 ask |
test_caption_hashtag_over_cap_fails | 超過 5 個 tag 判 FAIL |
test_human_removes_invisible_and_slop | 零寬字元和中文套話被移除 |
test_human_emdash_becomes_fullwidth_comma | 破折號換成全形逗號,不是半形 |
test_emoji_output_does_not_crash_on_cp950 | cp950 環境輸出 emoji 不崩潰 |
$ python -I test_zh_ig_lint.py
...
7/7 passed
這個中文版的限制
- 權重和語速是假設值。每秒 4.5 字、一個英文字抵 1.5 個中文字、dealbreaker 乘 0.5,都是我依英文版結構設的,沒有拿任何留存曲線驗過。原版作者至少用 74 個真實開場量過 AUC,中文版連這一步都還沒做。
- 詞庫是我列的。打招呼、前言、利害詞、AI 味詞都是手寫清單,沒有用真實中文 Reel 逐字稿測命中率。「各位朋友」「Hi 各位」這類變體目前抓不到。
- 125 字元的可見區沿用原版。原版自己註明這個數字會隨裝置和字體變動;中文在手機動態牆實際顯示幾個字,我還沒用實機確認。
- 自動替換會讓句子變生硬。
human改完的版本有「用這些順、新的技巧」這種句子,只能當提示,最後還是要人改。
我該用原版還是中文版?
| 你的情況 | 建議 |
|---|---|
| 用英文經營 IG | 原版直接用,Windows 記得加 -X utf8 |
| 用中文經營 IG,只要提示詞 | 裝原版的 13 份 SKILL.md,填好 voice.md,Claude 照樣能產中文腳本與文案 |
| 用中文經營 IG,想用工具打分 | 原版的 hookscore、caption、humanize、beats 數字都不要信,換中文規則再用 |
| 想找能自動發文的版本 | 這個 repo 刻意不做,README 說自動化操作違反 IG 條款 |
git clone https://github.com/Jakeschincariol/instagram-agent-skill.git
cp -r instagram-agent-skill/skills/ig-* ~/.claude/skills/
搜尋 instagram-agent-skill 會看到很多內容一樣的複製 repo,裝之前認明 Jakeschincariol 這個原始帳號。
延伸資源
- instagram-agent-skill GitHub repo:README 的「What I actually measured」寫了 hook 評分能做到什麼、做不到什麼
- 上一篇:instagram-agent-skill 中文實測:腳本估時與套話清理的中文補丁
- 這次的中英對照輸出頁:5 支工具在中英文、cp950 下的完整輸出
- Claude Code 的 find-skills 怎麼找 Skill:裝別人的 Skill 之前先看它做什麼