懶人包
- Harness² 是 Google Research 與 Northwestern 在 2026-10-09 發表、Apache-2.0 開源的框架:模型權重不動,讓另一個 LLM 去改 agent 的 harness(system prompt、scripts、skills 等八個元件),repo 在 2026-11-01 有 21,764 顆星。
- 核心是 Propose–Probe–Compose:同一題先用原 harness 跑兩次,再提兩種候選 harness 各跑一次,比對軌跡差異後合成,不需要標準答案;採用的 harness 和附證據的教訓存進 library,下一題沿用。
- 論文數字是「最多」:單步最高 WorkBuddy-Bench +11.5 分、JobBench +4.5 分、LAB +11.8 個百分點,模型是 GLM-5 與 Gemini 3.5 Flash,目前沒有第三方複現。
- 官方 demo 不用任何 API key,但只支援 Linux;我在 Windows 改兩個地方(
fcntl、路徑反斜線)後跑通,2 題全過。- 我用
claude -p寫了約 350 行的迷你版,haiku 當執行器、sonnet 當編輯器,3 題帳本 18 次執行全對——分數沒有進步空間,變的是做法被固化成 script 與 skill,library 長出第一條經驗。- 結論:值得讀它的 prompt 設計並搬進自己的 Claude Code 工作流;官方 repo 綁 Vertex AI、只支援 Linux,我的迷你版一題要 6 次執行加 4 次編輯器呼叫,不適合直接當產品用。
一支 IG Reel 介紹 Google Research 開源的 Harness²,說它能「讓 AI 代理不換模型,就把工作環境越改越強」。這句話對每天在調 CLAUDE.md、skills、hooks 的人很有吸引力,因為模型是別人的,我們能動的本來就只有模型外面那一圈。
我想知道兩件事:它的「自己改」到底改了什麼、怎麼判斷改得好不好;以及這套方法能不能接上 Claude Code。所以我讀了論文和原始碼,在 Windows 跑了官方 demo,再用 claude -p 寫了一個迷你版實際跑三題。
Harness² 是什麼?
Harness² 的公設很簡單:agent = 凍結的模型 + 可編輯的 harness。harness 指模型外面那一圈,官方 README 列了八個可編輯元件:system prompt、guardrails、memory、tool guidance、subagents、skills、scripts、plugins。
| 項目 | 內容 |
|---|---|
| 論文 | arXiv 2610.14224〈Harness^2: Recursive Agent Harnessing for an Open World〉,2026-10-09 提交 |
| 作者 | Ruiyao Xu、Yanfei Chen、Chen-Yu Lee、Tomas Pfister 等 9 人 |
| Repo | google-research/harness2,Apache-2.0,2026-11-01 查為 21,764 stars |
| 執行器 | OpenCode、Codex |
| 模型接法 | .env 填 Vertex AI 專案與模型 ID,gcloud auth application-default login |
| Benchmark | JobBench、LAB(法律)、WorkBuddy-Bench(Office/網頁/程式,需要 Docker) |
| 定位 | README 結尾寫明 *This is not an officially supported Google product* |
| 層 | 做什麼 | 關鍵 |
|---|---|---|
| 任務層 Propose–Probe–Compose | 對目前這一題提出候選 harness、實跑、比對、合成 | 不需要標準答案,靠不同 harness 下的行為差異判斷 |
| Harnessing 層 improvement library | 每題結束後把採用的 harness 與 EXPERIENCE.md 存起來 | 下一題的編輯器先讀 library,這才是「越改越強」的來源 |
Propose–Probe–Compose 怎麼運作?
我讀的是官方 harness2/core/recursion.py 和 prompts.py。以 parallel、k=1 的設定為例,一題的流程是這樣:
我覺得最值得搬走的是三個設計:
- INV 與 DOM 分工:一個編輯器只管「怎麼做事」(流程、工具、腳本),另一個只管「領域規則」(skill、知識)。兩個方向分開提,composer 才看得出哪種改動有用。
- 用對比取代打分:沒有標準答案時,composer 看的是候選跟 base 的軌跡和產出哪裡不一樣,也允許判定
KEEP_BASE,什麼都不改。 - 經驗必須附證據:
EXPERIENCE.md每條要寫 cue、lesson、evidence、confidence 四欄,觀察不到效果就寫NO_ENTRY,不硬湊。
--k K --mode parallel 一次提 2K 個候選、合成 K 個;--mode sequential 連續跑 K 輪精煉。
論文的進步數字怎麼讀?
論文摘要原文是 *gains of up to 11.5 points on WorkBuddy-Bench, 4.5 points on JobBench, and 11.8 percentage points on LAB*。讀的時候注意三點:
- 是 up to:四種模型與 harness 組態裡最大的那一個,不是平均。
- 是單一 Harness² 步驟:模型是 GLM-5 和 Gemini 3.5 Flash,比較對象是它們各自的 base harness。
- 是作者自評:截至 2026-11-01 我沒找到獨立複現。要跑真正的 benchmark 得接 Google Cloud,會產生 API 費用。
官方 demo 在 Windows 怎麼跑起來?
官方 README 指定 Linux、Python 3.12 與 uv。demo 用確定性編輯器加真的 Python 執行,不需要任何模型憑證:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
Windows 原生環境踩到的兩個坑
我的機器是 Windows 11、沒有 WSL,直接用原生 Python 3.12 venv 跑,卡了兩個地方:
| 問題 | 位置 | 症狀 | 我的修法 |
|---|---|---|---|
Windows 沒有 fcntl | harness2/core/schedule.py 用 fcntl.flock 鎖 ledger | import 失敗 | 在 venv 的 site-packages 放一個 no-op 的 fcntl.py(只適合單行程 demo,沒有真的上鎖) |
| 路徑是反斜線 | harness2/core/tree.py 用 str(p.relative_to(d)) | 編輯器寫出的 scripts\summarize.py 被判為不允許的路徑,候選全部退回 base,demo 以 StopIteration 結束 | 改成 .as_posix() |
tree.py 的修改只有兩行:
-        rel = str(p.relative_to(d))
+        rel = p.relative_to(d).as_posix()
修完之後輸出:
  [accounting] 1/2 ok           ledger-1
  [accounting] 2/2 ok           ledger-2
Local demo: 2 tasks completed; 0 failed.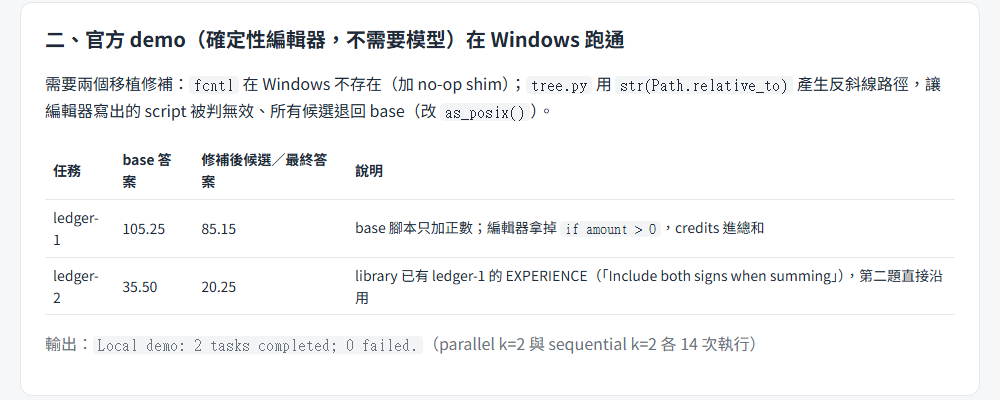
demo 的帳本題很好懂:base 腳本只加正數,編輯器拿掉 if amount > 0 後答案從 105.25 變成正確的 85.15。第二題 library 裡已經有第一題的經驗「Include both signs when summing」,編輯器直接沿用,35.50 修成 20.25。
用 claude -p 做迷你版:3 題、18 次執行
官方只接 Vertex AI 和 OpenCode/Codex,我想看這個流程接上 Claude Code 會怎樣,就照 parallel k=1 的流程自己寫了一支 mini_harness2.py,約 350 行,只用 Python 標準庫。
| 角色 | 指令 | 可用工具 |
|---|---|---|
| 執行器 | claude -p --model haiku,harness 用 --append-system-prompt-file SYSTEM.md 帶入 | Read、Write、Bash、Glob |
| INV/DOM 編輯器、Composer | claude -p --model sonnet | Read、Edit、Write、Glob、Grep(沒有 Bash) |
| Reflector | claude -p --model sonnet | Read、Glob、Grep |
cmd = ["claude", "-p", prompt, "--model", model, "--allowedTools", tools,
       "--dangerously-skip-permissions", "--max-turns", str(max_turns),
       "--output-format", "stream-json" if stream else "json"]
if system_file is not None:
    cmd += ["--append-system-prompt-file", str(system_file)]
起始 harness 只有兩行 SYSTEM.md。任務是三份帳本:算出有效交易的淨額,寫進 answer.txt。我在帳本裡埋了陷阱,下面是 ledger-c 的一部分:
id,date,description,status,amount
C202,2026-10-20,Courier,POSTED,120.00-
C203,2026-10-21,Consulting,POSTED,"4,000.00"
C203,2026-10-23,Consulting (corrected),POSTED,"4,400.00"
C204,2026-10-21,Refund,POSTED,(250.00)
C205,2026-10-22,Chargeback,REVERSED,"1,000.00"
C207,2026-10-23,Bank fee,POSTED,−18.50
C208,2026-10-24,Equipment,VOID,"3,000.00"
尾隨負號、括號負數、unicode 負號、同 id 的更正列、REVERSED、VOID 都有。正確答案放在 truth.json,只用來事後打分,執行器和編輯器都看不到——這符合 Harness²「不靠標準答案」的設定。
結果:
| 任務 | 隱藏答案 | library 既有條目 | base | 最終 harness |
|---|---|---|---|---|
| ledger-a | 24211.99 | 0 | 2/2 | 2/2 |
| ledger-b | 64786.90 | 1 | 2/2 | 2/2 |
| ledger-c | 23079.50 | 2 | 2/2 | 2/2 |
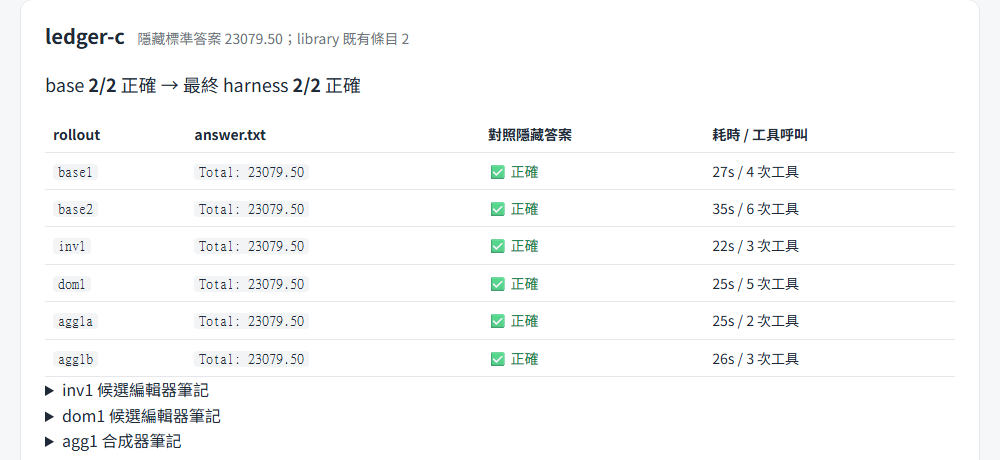
執行器每次 18–35 秒,編輯器每次約 40–50 秒,反思 60–90 秒,一題全程約 4 分鐘。完整結果頁發在 html.yanchen.app/harness2。
分數沒變,那它改變了什麼?
haiku 光靠兩行 system prompt 就把三題都做對了,所以這組題目沒有分數可以賺。這是實驗設計的限制,我照實寫。有變化的是下面四件事。
做法被固化成檔案。 最終 harness 從兩行長成三樣東西:寫滿帳務規則的 SYSTEM.md、一份 skills/ledger-validity/SKILL.md 檢查清單、一支 scripts/audit_ledger.py 確定性計算腳本。執行器之後改跑腳本,不再每次自己寫 inline Python。工具呼叫次數沒有一致下降:ledger-c 從 base 的 4/6 次降到 2/3 次,ledger-b 反而從 2/2 次變成 4/4 次。
library 有被沿用。 ledger-b 和 ledger-c 的候選 harness 直接從 library 複製前一題的 harness 再調整,三題的 SKILL.md 一個 byte 都沒變。
NO_ENTRY 真的會寫。 ledger-a 和 ledger-b 的 reflector 都判斷「六次執行答案一樣,規則沒有觸發,沒有證據支持任何經驗」,寫了 NO_ENTRY。
ledger-c 長出第一條經驗,跟帳務無關,是 Windows 編碼:
cue: A harness ships a helper script that prints text taken from the task's input data,
     which may contain non-ASCII characters (for example a unicode minus), and the agent
     may run on a machine whose console encoding is a legacy code page.
lesson: In the helper script under scripts/, set stdout and stderr to UTF-8 explicitly at
        startup (reconfigure(encoding="utf-8", ...)) so a print of input data cannot raise
        before the deliverable is written.
confidence: low.
證據是 base2 的 inline Python 印 −18.50 時兩次拋出 UnicodeEncodeError: 'cp950'。reflector 自己標 low,因為沒有任何一次執行跑過「沒修正的腳本」。我事後手動補驗:library 裡 ledger-b 版本的 audit_ledger.py 在第 48 行拋 UnicodeEncodeError: 'cp950',修正版印出 Total: 23079.50。寫這篇前我用 PYTHONIOENCODING=cp950 重跑一次,結果相同。
還有一個副作用值得記下來:composer 的筆記寫「I confirmed the fixed script runs under python -I」,但編輯器的工具清單裡沒有 Bash,它不可能跑過。結論碰巧是對的,過程是編的。reflector 只採信執行軌跡裡看得到的證據,把這條標成 confounded,正好擋住。這也是「經驗必須附 evidence」這個設計的價值所在。
什麼時候適合用、什麼時候不適合?
適合的情境是同領域、會重複很多次、沒有即時標準答案的任務:批次整理文件、報表核對、內容搬遷。跑幾題之後,規則會被固化成 skill 和 script,library 越來越厚。
不適合或要注意的地方:
- 成本:一題至少 base ×2、候選 ×2、合成後 ×2 共 6 次執行,加上 3 次編輯器與 1 次反思。我的迷你版一題約 4 分鐘。一次性任務不划算。
- 官方 repo 的門檻:Linux、Python 3.12–3.13(
pyproject.toml寫>=3.12,<3.14),模型只接 Vertex AI,執行器只有 OpenCode/Codex,WorkBuddy 要 Docker。要接 Claude 得自己寫 adapter。 - 網路沒有限制:README 的 Web access 段寫明執行器網路不受限、Codex 的 sandbox 是關閉的,跑 benchmark 前要自己設網路限制,否則可能查到答案與評分標準。
- base 已經會的題目賺不到分數:我的實驗就是這樣。要看到分數差,得挑模型會錯的題目。
- 編輯器會描述自己沒做過的事:上面 composer 的例子。reflector 那一關不能省。
想自己試,最短路徑是什麼?
- 先在 Linux 或 WSL 跑官方 demo,不用 API key,就能看到 Propose–Probe–Compose 的完整產物(
runs/demo/底下每題的 harness 與 trajectory)。Windows 原生要套上面兩個修補。 - 讀
harness2/core/prompts.py,這是整套方法最有價值的部分:INV、DOM、composer、reflector 四份 prompt。 - 挑一類你會重複做的任務,準備 3–5 題,寫一個兩行的起始
SYSTEM.md。 - 用
claude -p當執行器和編輯器,照 base ×2 → INV/DOM 候選 → 各跑一次 → 合成 → 反思寫 library 的順序串起來。編輯器不給 Bash,執行器才給。 - 看 library 裡的
EXPERIENCE.md:寫出NO_ENTRY是正常結果,代表這題沒有足夠證據。
延伸資源
- 論文:arXiv 2610.14224
- 原始碼:google-research/harness2,方法核心在
harness2/core/recursion.py與harness2/core/prompts.py - 專案頁:harness2.github.io
- 我的實驗結果頁(三題六次執行的完整表格與編輯器筆記):html.yanchen.app/harness2
- 同一條線的相關研究:Meta-Harness(arXiv 2603.28052),用 coding agent 搜尋 harness 程式碼,需要分數驅動