懶人包
- Cloudflare 開源的 security-audit-skill(MIT,2026-10-27 查約 4.96 萬星)讓一批 AI 找漏洞、另一批全新的 AI 專門推翻,沒在沙箱重現就不准標「已確認」。
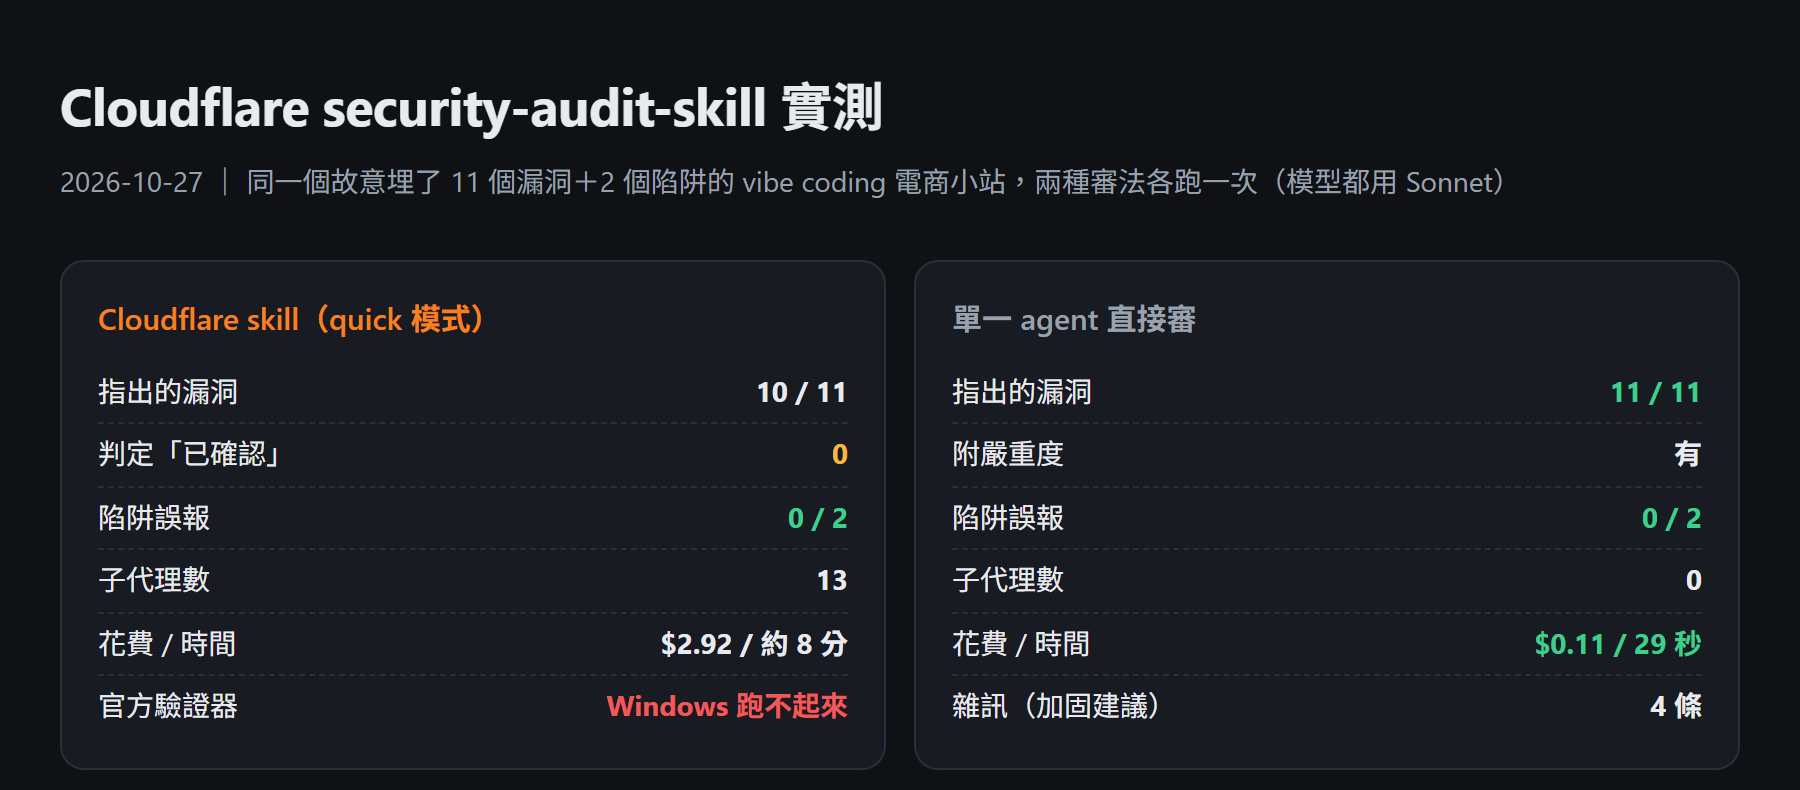
- 我用一個埋了 11 個漏洞、2 個陷阱的 Express 小站實測:skill 的 quick 模式指出 10 個、花 $2.92、約 8 分鐘;單一 agent 抓到 11 個、花 $0.11、29 秒。兩邊陷阱都沒誤報。
- skill 那 10 條全部是「待驗證」,0 條「已確認」:這次我沒給它沙箱,它照規矩不下定論。
- 官方兩支驗證器在 Windows 直接 exit 1,原因是 Node 在 win32 沒有
O_NOFOLLOW,整次 run 只能標成 incomplete。- 第三方盲測(issue #20,15 個漏洞、各跑 3 輪)結論一致:recall 跟單一 agent 同為 0.467,成本 14.5 倍。
- 我的用法:日常 vibe coding 用單一 agent 審;這個 skill 留給上線前、在 Linux 或 WSL 有沙箱的環境做正式稽核,而且要跑好幾輪。
Roboa.ai 有支 FB Reel 在介紹這個 skill,片尾自己註明「我們尚未實測」。我看完想知道的只有一件事:這套「AI 互相找碴」的流程,在一般 vibe coding 專案上,比直接叫一個 agent 審程式碼多抓到什麼? 所以我做了一個靶站,兩種審法各跑一次,答案卷事先寫好,放在審查範圍外。
Cloudflare security-audit-skill 是什麼?
cloudflare/security-audit-skill 是一份給 coding agent 讀的資安稽核 skill,2026-06-18 建立,MIT 授權。我在 2026-10-27 用 gh api 查到 49,579 顆星、3,109 個 fork。README 說它是 Cloudflare 內部漏洞挖掘系統的起點,後續演變寫在官方部落格 Build your own vulnerability harness。
它沒有執行檔。整個 repo 是一組 Markdown 提示詞,加上兩支零依賴的 Node 驗證器(validate-findings.cjs、validate-coverage-ledger.cjs)和一份 report-schema.json。agent 讀了 SKILL.md 之後,照裡面的六個階段指揮子代理:
判定只有三種:confirmed(已確認)、needs_validation(待驗證)、rejected(駁回)。只有 confirmed 會有嚴重度,而 confirmed 要求「有完整的資料流追蹤,加上一個有界的實際觀察結果」,也就是要在沙箱裡真的跑過。
模式有三種:quick 只跑一波獵人、一次覆蓋率檢查;standard 是預設;deep 給大型或高風險目標,critic 要跑到乾淨為止。
怎麼安裝?
README 的官方指令用 Skills CLI:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
加 --global 會裝到使用者層級。這次我沒有裝,因為它會改全域設定;我把 repo clone 下來,在提示詞裡直接指定 SKILL.md 的路徑讓 agent 讀,效果相同。裝好之後,README 給的觸發方式就是一句話:
security audit this codebase我怎麼比?
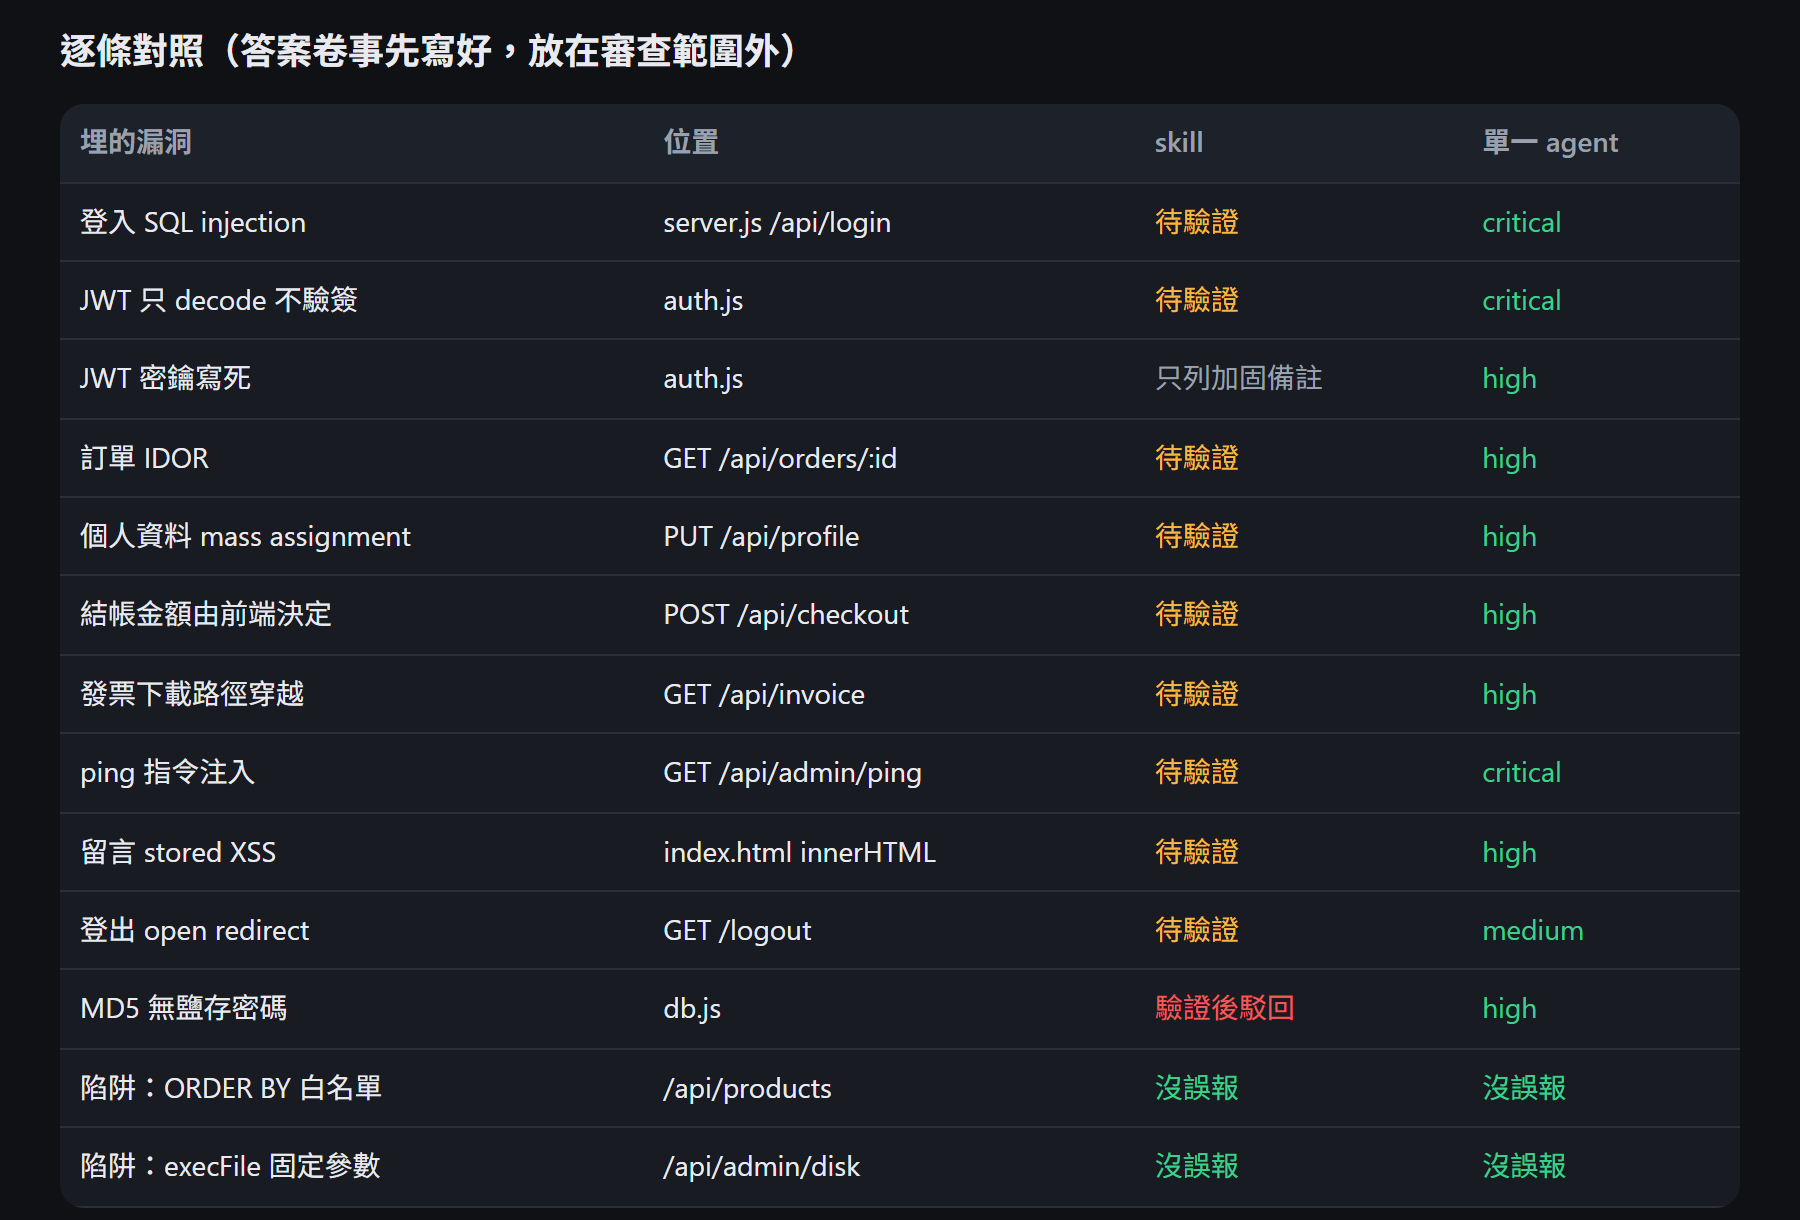
靶站是一個 Express + SQLite + JWT 的電商小站,我故意埋了 11 個教科書型漏洞,再放 2 個「看起來像漏洞、其實安全」的陷阱,用來測誤報:
| 類型 | 內容 |
|---|---|
| 11 個漏洞 | 登入 SQLi、JWT 只 decode 不驗簽、JWT 密鑰寫死、訂單 IDOR、個人資料 mass assignment、結帳金額由前端決定、發票路徑穿越、ping 指令注入、留言 stored XSS、登出 open redirect、MD5 無鹽存密碼 |
| 2 個陷阱 | 有白名單的 ORDER BY、參數寫死的 execFile |
claude -p --model sonnet,並加上 --strict-mcp-config --setting-sources project,local,排除我自己全域的 hook 和 MCP 干擾。兩組都被告知不准讀答案卷所在的目錄。
skill 組的提示詞要點:
Read and follow the skill at .../security-audit/SKILL.md
Request: full security audit of the codebase at .../shopdemo .
Full audit mode, profile "quick".
No OS-enforced sandbox is available on this host, so do NOT execute target code;
source-only analysis, keep sandbox-blocked items as needs_validation as the skill says.
單一 agent 組只有一段話:讀完所有原始碼、列出每個漏洞、輸出成 {"title","file","line","severity","description","fix"} 的 JSON 陣列。
注意 skill 組那句「不准執行目標程式」。這台是 Windows,沒有作業系統層級的沙箱,所以是我主動限制它,不是它自己做不到。
實測結果:誰抓到比較多?
| skill(quick) | 單一 agent | |
|---|---|---|
| 指出的種子漏洞 | 10/11 | 11/11 |
| 判定 confirmed | 0 | 不適用(每條都直接附嚴重度) |
| 陷阱誤報 | 0/2 | 0/2 |
| 子代理數 | 13(2 獵人、1 critic、10 驗證者) | 0 |
成本(total_cost_usd) | $2.917828 | $0.1128645 |
| 時間 | 約 8 分鐘(22:53:58 啟動,23:01:56 寫完) | 28.9 秒 |
| 額外雜訊 | 無 | 4 條加固建議(helmet、rate limit、lockfile 等) |
skill 少的那一條是「JWT 密鑰寫死」。它的理由寫在報告裡:token 從來沒被驗簽,所以密鑰目前沒有作用,列成加固備註。MD5 存密碼則被驗證者駁回,理由是「這條沒有自己獨立可達的讀取路徑」,同樣降成加固。兩個判斷都有根據,代價是讀報告的人可能把「現在打不到」讀成「不是問題」。issue #20 的作者也點出同一件事。
skill 多給了什麼?
數量上沒贏,但它每一條的內容比單一 agent 紮實。報告裡每條待驗證的漏洞都有:
- 跨了哪個信任邊界,例如
anonymous -> any user / admin。 - 卡在哪個未確認的事實,例如「上游 proxy 有沒有另外驗 JWT 看不到」。
- 一份不會破壞資料的驗證計畫。
如果我要把結果交給別人修,skill 的報告比較好用;如果我只是想在 commit 前知道哪裡有洞,單一 agent 29 秒就給了。
Windows 上的踩坑:官方驗證器跑不起來
skill 在第 4、5 階段要跑兩支驗證器。在我的 Windows 11、Node v24.11.1 上:
node validate-findings.cjs poc/skill-run/findings.jsonFailed to read findings JSON: OS no-follow and nonblocking input protection is unavailableexit code 1,validate-coverage-ledger.cjs 同樣錯誤。原因在 readFileWithinLimit():它要求 fs.constants.O_NOFOLLOW 和 O_NONBLOCK 都存在,用來防 symlink 和 FIFO 攻擊。Node 在 win32 這兩個常數是 undefined:
node -e "console.log(process.platform, require('fs').constants.O_NOFOLLOW)"win32 undefinedskill 自己的處理方式很誠實:它另外做了一份拿掉這道檢查的副本跑過,兩個檔案都通過 schema,但整次 run 還是標成 incomplete,原因寫 validators_unavailable_on_host。想在 Windows 用,請在 WSL 裡跑。
第三方盲測怎麼說?
我的靶站很小、漏洞都很典型,對單一 agent 有利,而且兩組都只跑 1 次。所以我去對照了 repo 的 issue #20:HetCreep 在 2026-09-16 發的盲測,15 個種子漏洞、2 個陷阱,每組各跑 3 輪。
| 指標 | skill quick | 單一 agent |
|---|---|---|
| precision 中位數 | 90% | — |
| 陷阱誤報 | 0 | — |
| recall 中位數 | 0.467 | 0.467 |
| 每次成本中位數 | $29.95 | $2.06 |
Cloudflare 的 README 自己也寫了:
In our test runs, a single run found roughly half of the vulnerabilities that repeated runs found in total.
單跑一次大約只抓到多跑幾次總和的一半。這個 skill 的設計是「同一個 repo 多跑幾次,後面的 run 讀前面的 ledger 去補缺口」,跑一次就下結論,不是它的用法。
什麼時候值得用它?
| 情境 | 我的選擇 |
|---|---|
| vibe coding 寫完一段,commit 前想知道有沒有明顯的洞 | 單一 agent,幾十秒、幾毛錢 |
| 登入、付款、權限這類改動要上線 | 單一 agent 先掃,修完再用 skill 跑 standard |
| 對外服務上線前的正式稽核、要交報告給別人 | skill,在 Linux/WSL 有沙箱的環境、跑多輪 |
| 想查依賴套件有沒有已知 CVE | 都不適合,用 npm audit、Dependabot 這類工具 |
| 只有 Windows、沒有 WSL | skill 會一直是 incomplete,先用單一 agent |
這次實驗的限制
- 兩組各跑 1 輪(n=1),只能看方向,不能當統計結論。
- 靶站約 6 KB、漏洞都是教科書型。真實專案的漏洞藏在商業邏輯裡,skill 的覆蓋率帳本在那種情況才比較有發揮空間。
- skill 組被我禁止執行程式,所以 confirmed 是 0。給它沙箱,結果會不一樣。
- 兩組模型都是 Sonnet。換更強或更弱的模型沒有測。