2026-09-20 晚上,我把一份故意留洞的計畫丟給 claudex-loop:規則寫了三條,驗收只驗其中兩條。
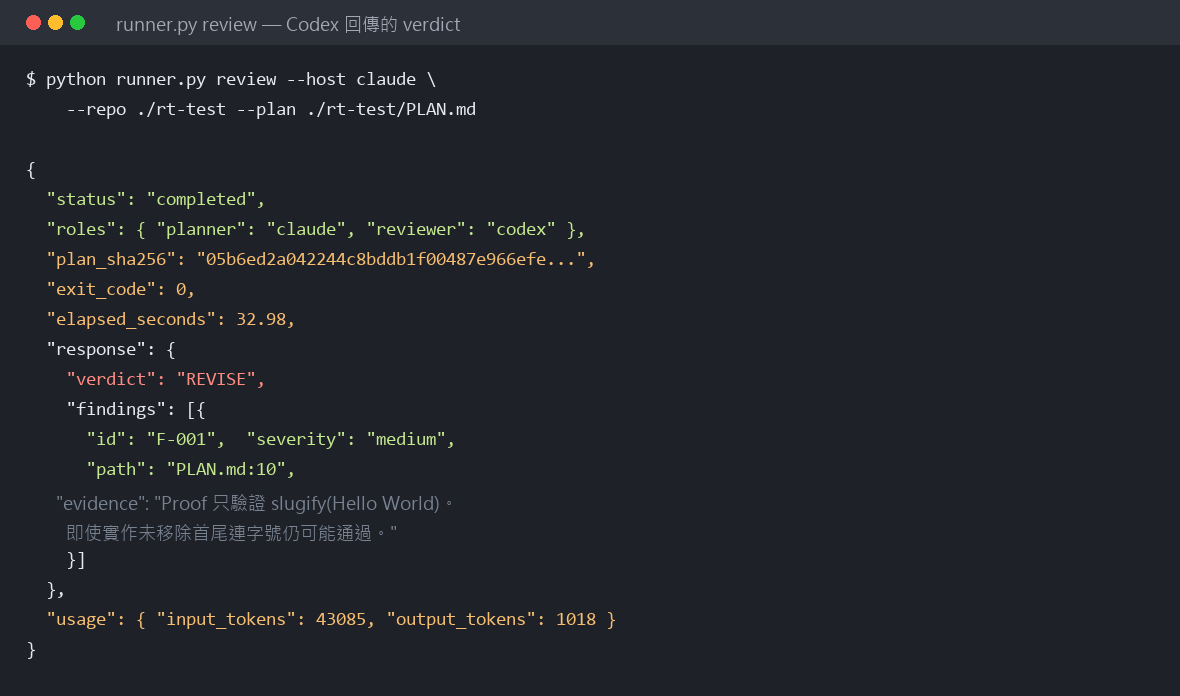
32.98 秒後,Codex 回傳 verdict: REVISE,並指名 PLAN.md:10:
「Proof」只驗證 slugify('Hello World') == 'hello-world'。即使實作未移除首尾連字號,或錯誤處理連續/首尾空格,此命令仍可能通過。
那正是我埋的洞。而且我跑了兩輪——兩個各自獨立的 Codex session,都抓到同一個。
這篇記錄我實際裝完、跑完、讀完原始碼之後,對這套工具的判斷:它解決什麼問題、靠什麼機制成立、以及哪些地方它幫不了你。
TL;DR:claudex-loop 把「寫計畫」跟「審計畫」硬性拆給 Claude 與 Codex 兩個不同模型,不通過不准動工,寫完 code 再換人檢查。我丟一份 Acceptance 只驗單一 happy path 的計畫進去,兩輪獨立實測(32.98 秒、40.58 秒)都回 REVISE 且指到同一行。審查方以 -s read-only 啟動、拿不到寫入權,審查結果綁定計畫的 SHA-256 不能挪用。代價是單輪四萬到八萬多 input tokens,走你的 ChatGPT 額度。
claudex-loop 是什麼?
chaseai-yt/claudex-loop 是一組 Claude Code skill,作者 Chase AI。核心規則只有一句,寫在 repo 描述裡:
Whoever built it never grades it.(誰建的,誰就不准評分。)
拆成兩個階段:
動工前——Claude 寫計畫,Codex 帶著證據反駁,來回修到通過才准寫第一行 code。
動工後——角色互換。Claude 寫的 code 交給 Codex 檢查,反之亦然。
這不是「兩個 AI 聊天」,也不是把同一個問題問兩次取交集。它是把利益衝突寫進流程:評分的那一方,沒有動機維護被評的產出。
撰文當下的客觀數據(2026-09-20 實查):
| 項目 | 值 |
|---|---|
| Stars | 約 2,300 |
| Forks | 224 |
| 建立 | 2026-06-05 |
| 最後 push | 2026-09-06 |
| 版本 | plugin.json 2.1.0 |
| 授權 | MIT,但有例外條款(見下) |
授權有個細節值得先講
GitHub API 對這個 repo 回的是 license: NOASSERTION,不是 MIT。但 repo 裡的 LICENSE 開頭明明白白寫著 MIT License。
兩邊不一致的原因,在 LICENSE 第 5 行起的一段例外聲明:
Portions of this project (the "grill" Act 1 of grill-me-codex and grill-with-docs-codex,
and the CONTEXT-FORMAT.md / ADR-FORMAT.md files) are adapted from skills by Matt Pocock
(https://github.com/mattpocock/skills), Copyright (c) 2026 Matt Pocock, used under the MIT
License. See each skill's THIRD-PARTY-NOTICES.md.
因為標準 MIT 文本被插入了自訂段落,GitHub 的授權偵測器就不敢歸類,於是回 NOASSERTION。實際上兩邊都是 MIT,只是其中一部分的著作權屬於 Matt Pocock 並已標註來源。
我把這段寫出來,是因為只看 GitHub 側邊欄,會以為「這專案沒授權、不能用」;只看 LICENSE 第一行,又會漏掉衍生來源。兩邊都看才是完整答案。
裝之前:我先讀了 runner.py
這類工具會在你的機器上叫起另一個 CLI、讀你的 repo。裝之前我把核心的 skills/claudex-loop/scripts/runner.py(420 行)讀過一遍,重點是確認它不會把東西往外送。
grep -nE 'requests|urllib|http|socket|api_key|token' skills/claudex-loop/scripts/runner.py零匹配。它只 import subprocess,職責是組指令、叫起本機的 claude / codex、收 JSON 回來。網路行為全部發生在那兩個官方 CLI 自己身上,不經過這支腳本。
官方也附了驗證器:
python scripts/validate.py
# Skill metadata, references and manifests passed.
它怎麼叫 Codex——這段決定了安全邊界
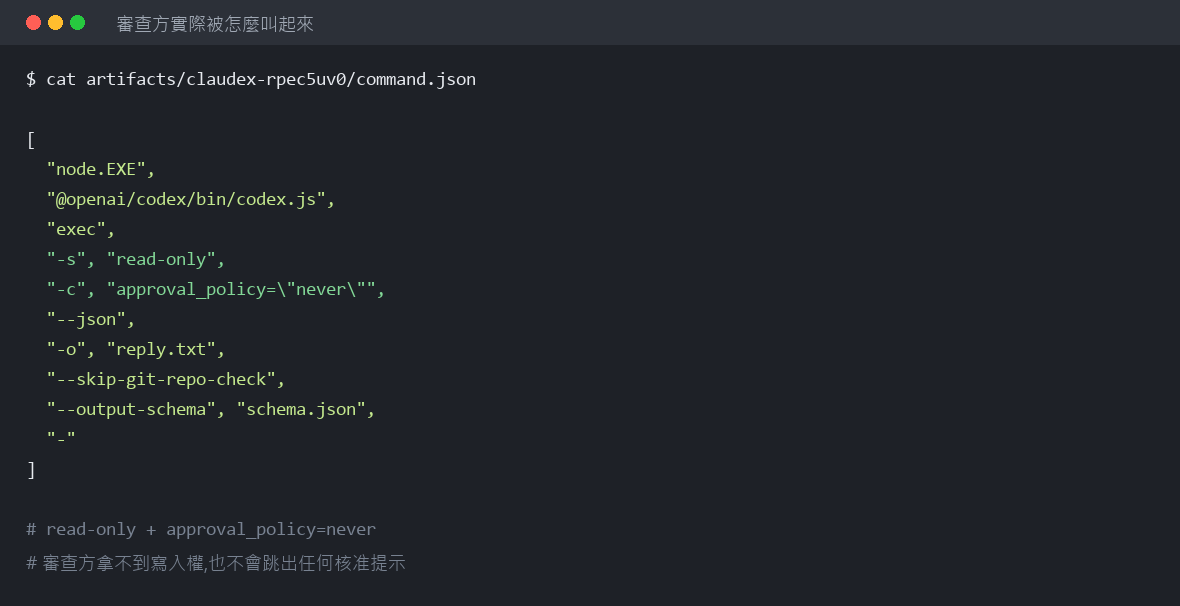
跑完一輪後,artifacts 目錄會留下 command.json,就是實際執行的那條指令。我這輪的內容(路徑已簡化):
[
  "node.EXE",
  "@openai/codex/bin/codex.js",
  "exec",
  "-s", "read-only",
  "-c", "approval_policy=\"never\"",
  "--json",
  "-o", "reply.txt",
  "--skip-git-repo-check",
  "--output-schema", "schema.json",
  "-"
]
三個關鍵參數:
-s read-only— Codex 以唯讀沙箱啟動。審查方在機制上無法修改你的 repo,不是靠 prompt 拜託它別亂改。approval_policy="never"— 不會中途跳出來要你按同意,適合自動化;代價是你要信任 read-only 這道牆。--output-schema— 強制回傳結構化 JSON。所以拿到的是可程式化處理的verdict/findings,不是一段要自己 parse 的散文。
- 表示 prompt 走 stdin。這是刻意的:早期版本會去讀 repo 裡某個固定檔名當 prompt,被社群指出是風險(ACKNOWLEDGMENTS.md 裡記了這筆,PR #13),現在改成由 runner 自己產生、從 stdin 餵入,repo 內的檔案無法冒充審查指令。
安裝
前置條件是兩個官方 CLI 都已安裝並登入。我的環境:
Python      3.12.10
codex-cli   0.152.0(已登入 ChatGPT 帳號)
Claude Code 2.1.278
skill 本體不需要任何 pip 套件。把 repo 的 skills/ 底下四個目錄放進 skill 目錄即可:
git clone https://github.com/chaseai-yt/claudex-loop.git
cd claudex-loop

# Claude Code 端
cp -r skills/claudex-loop skills/claudex-route skills/codex-build skills/codex-review \
      ~/.claude/skills/

# Codex 端(要能從 Codex 這側發起時才需要)
cp -r skills/claudex-loop skills/claudex-route skills/codex-build skills/codex-review \
      ~/.agents/skills/
四個 skill 各司其職:
| Skill | 用途 |
|---|---|
claudex-loop | 主流程,自動選審查方,計畫強化 +(可選)建置與交叉檢查 |
claudex-route | 只做「這題該給誰做」的建議與單次交辦 |
codex-build | 指定由 Codex 實作、Claude 檢查 |
codex-review | 指定由 Codex 審查既有計畫 |
實測:丟一份有洞的計畫進去
我建了一個乾淨的空 git repo,只放一份 PLAN.md。洞是刻意的——Behavior 寫了三條規則,Acceptance 只驗前兩條:
# Plan: add a slugify() helper

## Goal
Add `slugify(text: str) -> str` to `util.py`.

## Behavior
- lowercase the input
- replace every space with a single hyphen
- strip leading/trailing hyphens

## Acceptance
- `slugify("Hello World") == "hello-world"`

## Proof
- `python -c "from util import slugify; assert slugify('Hello World')=='hello-world'"`
"Hello World" 這個輸入頭尾本來就沒有連字號,所以就算實作完全漏掉「去除首尾連字號」這條規則,驗收還是會綠。人在 code review 時很容易放過。
執行:
python ~/.claude/skills/claudex-loop/scripts/runner.py review \
  --host claude --repo . --plan PLAN.md \
  --artifacts ../rt-artifacts --timeout 360
回傳結果
{
  "verdict": "REVISE",
  "summary": "計畫的功能規則大致明確,但驗證方式只涵蓋單一正常案例,無法證明所有列出的行為。",
  "findings": [
    {
      "id": "F-001",
      "severity": "medium",
      "path": "PLAN.md:10",
      "fix": "新增自動化測試,至少涵蓋小寫轉換、首尾既有連字號、首尾空格、連續空格、空字串,以及只有空格/連字號的輸入。"
    }
  ]
}
它不只說「測試不夠」,而是指到 PLAN.md:10、說明為什麼那條驗收證明不了規格,並列出該補的案例。
執行資訊:
| 欄位 | 值 |
|---|---|
status | completed |
exit_code | 0 |
elapsed_seconds | 32.98 |
input_tokens | 43,085(其中 cached 21,120) |
output_tokens | 1,018(含 reasoning 397) |
cli_version | codex-cli 0.152.0 |
coverage,交代它實際查了什麼:
已核對 PLAN.md 的 SHA-256,與提供值一致。
已檢查工作區完整檔案清單;目前只有 PLAN.md。
已搜尋slugify、util的引用及共享狀態讀寫。
已逐項比對 Goal、Behavior、Acceptance 與 Proof。
以及誠實的 limitations:
儲存庫目前沒有 util.py 或測試檔,因此無法審查實作。
依指示未執行測試,也未宣稱測試通過。
最後這句是我最看重的一行。 它明確區分「我審了計畫」與「我驗證過程式會動」,沒有把前者講成後者。
兩輪都抓到同一個
我在不同時間跑了兩次,是兩個獨立 session:
| 第一輪 | 第二輪 | |
|---|---|---|
| 耗時 | 40.58 秒 | 32.98 秒 |
| input tokens | 87,356 | 43,085 |
| verdict | REVISE | REVISE |
| 抓到的洞 | acceptance 只驗單一 happy path | 同左 |
token 數差一倍,是因為兩輪的快取命中狀況不同,不是審查深度不同。
plan_sha256:approval 不能挪用
result.json 裡有這麼一欄:
"plan_sha256": "05b6ed2a042244c8bddb1f00487e966efedf34ea15410d4d5de995200d74876d"審查結果綁定計畫內容的雜湊。這代表你不能先拿一份無害的計畫去換 APPROVED,再偷換成另一份拿去動工——雜湊對不上。後續的 build 階段用 --approval 帶入這份 result.json 時,這個綁定才有意義。
這是我讀完之後覺得設計最細緻的一處:它預設了「人會想抄捷徑」,而不是假設使用者一定照規矩來。
角色互換不是說說而已
result.json 的 roles 欄位,直接把分工寫成資料:
"roles": {
  "host": "claude",
  "planner": "claude",
  "reviewer": "codex",
  "builder": "claude",
  "inspector": "codex"
}
planner 與 reviewer 不同人,builder 與 inspector 不同人。這不是 prompt 裡的一句叮嚀,是流程參數——runner 依這個欄位決定去叫哪支 CLI。
成本:不是免費午餐
這是我認為最該講清楚、但多數介紹會略過的部分。
一輪計畫審查吃掉 43,085 個 input token,而且這只是「審一份 353 bytes 的 PLAN.md」——一份真實專案的計畫,加上它要掃的 repo 檔案清單,只會更多。
這些 token 走的是你的 ChatGPT / Codex 額度。所以:
- 它不適合拿來審每一個小修改。README 錯字、改個變數名,用這套是浪費額度。
- 它適合動工前那種「做錯方向要重來一週」的計畫。省下的是人的時間,花掉的是 token。
- 前置條件是你同時有 Claude 和 Codex 兩邊的可用額度。只有一邊的話,這套工具的前提就不成立。
not for trivial edits。
它幫不了你的地方
誠實列出我實測後認定的邊界:
1. 它審的是計畫的內在一致性,不是外部正確性。
上面那輪,Codex 抓到「驗收覆蓋不了規格」,因為規格和驗收都在同一份檔案裡,矛盾是可見的。但如果我的規格本身就寫錯——例如需求其實要保留大寫——它不會知道,因為那份知識不在計畫裡。
2. 它不執行測試。limitations 自己講了:「依指示未執行測試」。REVISE 或 APPROVED 都不等於程式跑得起來。
3. 第二意見仍有共同盲點。
兩個都是大型語言模型,訓練資料與思考傾向有重疊。兩邊都同意,不等於客觀正確,只等於「兩個不同模型在各自獨立的 context 下都沒看出問題」。這比一個模型自審強,但不是保證。
4. Windows 上請留意路徑與行程管理。runner.py 裡有 Windows 專屬的 CREATE_NEW_PROCESS_GROUP、CREATE_NO_WINDOW 與 taskkill 處理。我這輪在 Windows 11 跑完全正常,但這塊平台差異存在,遇到 timeout 相關問題可以往這邊查。
5. --artifacts 建議指向 repo 外面。
我第一輪跑完沒指定持久目錄,artifacts 被清掉,重寫這篇時得重跑一次才拿得回數據。要留存審查紀錄的話,--artifacts 給一個 repo 外的固定路徑。
一個附帶發現:它的 ACKNOWLEDGMENTS.md
跟工具本身無關,但值得一提。這個 repo 有一份 ACKNOWLEDGMENTS.md,逐條列出社群 PR、作者是誰、哪些內容被吸收進重寫版、哪些沒有被採納,以及每個 PR 後續該怎麼處理。甚至明說:
The original PR commits were not merged or cherry-picked into #16. Credit here recognizes the reports, analysis and proposed approaches.
意思是:重寫時用了你指出的問題與思路,但沒有直接合併你的 commit,所以在這裡具名致謝、並誠實說明差別。
開源專案處理「我重寫了你的 PR」這種尷尬局面,這是我看過比較乾淨的做法。
我踩到的坑
裝與跑的過程有三件事文件沒寫,我實際撞到了。
一、--artifacts 目錄要自己想清楚放哪。 它會在指定目錄下開一個 claudex-<隨機碼> 子資料夾,把 command.json、prompt.txt、reply.txt、result.json、schema.json、stdout.txt、stderr.txt 全部留著。這些是好東西——我這篇的證據幾乎都是從 result.json 挖出來的——但如果你指到 repo 裡面又沒加進 .gitignore,每跑一次就多一包檔案進版控。我是丟到 repo 外面的暫存目錄。
二、它預設不跑測試,也明說自己沒跑。 result.json 的 limitations 欄位裡寫得很清楚:「依指示未執行測試,也未宣稱測試通過」。這其實是優點——它不會假裝驗過——但如果你以為審查通過就代表程式會動,那是誤會。驗證能不能跑起來是另一件事,要自己做。
三、審查方只能就你給的材料講話。 我那輪的 coverage 欄位顯示它檢查了工作區完整檔案清單、搜尋了 slugify 與 util 的引用。因為我的測試 repo 是空的,它就直接在 limitations 說「沒有 util.py 或測試檔,無法審查實作」。換句話說它只能就你給的材料講話——計畫寫得含糊,它抓到的也只會是含糊的問題。
我的結論
值得裝,但要用在對的地方。
它真正的價值不是「兩個 AI 比一個聰明」,而是把利益衝突制度化:寫的人不准評,評的人拿不到寫的權限(-s read-only 強制),而且評分結果綁定計畫雜湊、不能挪用。這三件事湊起來,才讓第二意見有意義。
適用判斷:
| 情境 | 建議 |
|---|---|
| 動工前的重要計畫、架構決策 | ✅ 用,省下來的是重做的時間 |
| 小修、錯字、改個名稱 | ❌ 別用,浪費 token |
| 只有 Claude 或只有 Codex 額度 | ❌ 前提不成立 |
| 需要確認「程式真的會動」 | ❌ 它不跑測試,要另外做 |
runner.py 確認你接受它的行為,再拿一份你已經知道有問題的計畫去跑——像我這樣故意留個洞。它抓不抓得到,比任何介紹文都更能告訴你這套工具值不值得留下。
Repo:github.com/chaseai-yt/claudex-loop
延伸資源
- chaseai-yt/claudex-loop——本文實測的 repo,
runner.py在scripts/底下,建議裝之前先讀一遍。 - Codex CLI 官方文件——
-s(sandbox 模式)與approval_policy這兩個參數的完整說明,也是理解本文安全邊界那段的基礎。 - Claude Code skills 說明——claudex-loop 是以 skill 形式安裝的,想知道 skill 怎麼被載入與觸發看這裡。