懶人包
- IG 上一支「GROK BOT」影片說 $2,500 在 22 小時內變 $8,750,但面板右上角自己標了 SIMULATED DATA 和 DEMO,標題列寫的是 22H REPLAY:這是模擬回放,不是真實帳戶紀錄。
- 我照面板上的 6 個 Agent 流程寫了一個迷因幣狙擊模擬器,同一套邏輯跑 1,000 次:中位數 $2,102(虧 16%),只有 33.9% 有賺,最好的一次 $8,046,沒有一次到 $8,750。
- 加到 10,000 次,到 $8,750 以上的只有 4 次(0.04%)。隨機抽 10 次挑最好的一次,結果的中位數是 $4,022;抽 100 次挑最好的是 $5,888。
- 把手續費和滑價歸零重跑,中位數從 $2,102 回到 $2,467、賺錢比例從 33.9% 升到 48.9%:在我的參數下,最穩定的支出是每筆約 8% 的來回成本。
- 看到這類貼文先問四件事:有沒有標模擬或回放、給的是一次結果還是分佈、成本有沒有算進去、要你做什麼才能拿到「系統」。
2026-10-25,IG 帳號 @denghao.0304 發了一支影片,封面字幕寫「$2,500 → 22 小時後變成 $8,750 美元?這套 6 Agent 系統到底做了什麼?」。我 10/29 看到時是 696 個讚、3,000 多則留言。
我想知道這個數字在這套流程裡有多常出現,所以把面板上的流程寫成模擬器,跑了 1 萬次。這篇記錄面板上寫了什麼、我怎麼復刻、跑出來的分佈長什麼樣子,以及模擬本身的限制。
影片裡的 GROK BOT 面板寫了什麼?
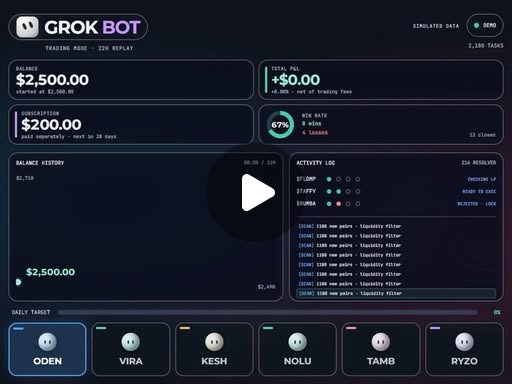
這是影片的預覽畫面(Instagram 公開的 og:image)。把畫面上的字一格一格讀出來:
| 位置 | 字樣 | 意思 |
|---|---|---|
| 右上角 | SIMULATED DATA、DEMO | 資料是模擬的,這是展示模式 |
| 標題下方 | TRADING MODE · 22H REPLAY | 播的是一段 22 小時的回放 |
| SUBSCRIPTION 卡 | $200.00 paid separately · next in 25 days | 有一筆另外付的月費 |
| Activity log | 1180 new pairs – liquidity filter、CHECKING LP、READY TO EXEC、REJECTED – LOCK | 掃新交易對、查流動性池、檢查 LP 鎖倉 |
| 底部 | ODEN、VIRA、KESH、NOLU、TAMB、RYZO | 6 個 Agent |
面板上也沒有任何 xAI 的標示。xAI 在 2026-08 推出的官方產品也叫 Grok Bot,但那是幫你處理 Gmail、CRM 的工作 agent,跟交易無關,兩者的差別我在〈Grok bot 是什麼〉整理過。
6 個 Agent 各自在做什麼?
影片只給了名字。我照 Activity log 的流程,把這 6 個 Agent 對應成狙擊機器人的 6 個步驟。分工是我依畫面推的,不是影片作者公布的規格。log 字樣跟 Agent 的對應也是我配的;標「—」的步驟在 log 裡沒看到,是我依狙擊機器人的常見步驟補上。面板上的排列是 ODEN、VIRA、KESH、NOLU、TAMB、RYZO,我把風控 TAMB 放在下單 NOLU 前面,因為部位大小要在下單前決定:
| 順序 | Agent | 我推的職責 | 對應的 log 字樣 |
|---|---|---|---|
| 1 | ODEN | 掃新池、過流動性門檻 | 1180 new pairs – liquidity filter |
| 2 | VIRA | 檢查 LP 鎖倉,擋掉 rug | CHECKING LP、REJECTED – LOCK |
| 3 | KESH | 社群熱度打分,低於門檻不買 | — |
| 4 | TAMB | 決定部位大小、限制同時持倉數 | — |
| 5 | NOLU | 下單,付手續費和滑價 | READY TO EXEC |
| 6 | RYZO | 停損、停利、移動停利 | — |
我怎麼復刻這個 22 小時回放?
我用 JavaScript 寫了一個純函式模擬器,一分鐘走一步,跑滿 22 × 60 = 1,320 步。每個 seed 產生一段固定的行情,同一個 seed 每次跑出一樣的結果,方便重播「最好那一次」。
參數全部是我設的示意值,沒有拿真實鏈上資料校準:
| Agent | 參數 | 值 |
|---|---|---|
| ODEN | 每分鐘新池數 | 平均 0.9 個(Poisson) |
| ODEN | 通過流動性門檻 | 12% |
| — | 通過門檻後仍是 rug | 55% |
| VIRA | 抓到 rug 的機率/誤殺正常幣 | 70%/15% |
| KESH | 社群熱度門檻 | 0.55 |
| TAMB | 每筆部位/最多同時持倉 | 總資產 8%/3 檔 |
| NOLU | 手續費+滑價 | 每邊 1%+3% |
| RYZO | 停損/停利/移動停利/最長持有 | -35%/+150%/回落 30%/4 小時 |
模擬器的蒙地卡羅函式只有幾行:
function monteCarlo(runs, opt = {}, seed0 = 1) {
  const finals = [];
  let best = null;
  for (let i = 0; i < runs; i++) {
    const res = run(seed0 + i * 7919, opt);
    finals.push({ seed: res.seed, final: res.final });
    if (!best || res.final > best.final) best = { seed: res.seed, final: res.final };
  }
  // 排序後算中位數、P10、P90、賺錢比例
}
同一套流程跑 1,000 次,$8,750 出現幾次?
node run-mc.js 1000 的實際輸出:
runs=1000 start=$2500 hours=22
median=$2102 mean=$2319 p10=$1282 p90=$3595
profitable=33.9%  >=3.5x(≈$8,750)=0.0%
best seed=1005714 final=$8046
best-run stats={"scanned":1223,"passLiq":155,"rejectedRug":67,"rejectedSent":45,"trades":23,"wins":10,"losses":13,"rugged":4,"fees":832}| 指標 | 數值 |
|---|---|
| 中位數 | $2,102(-16%) |
| 平均 | $2,319 |
| P10/P90 | $1,282/$3,595 |
| 有賺的比例 | 33.9% |
| 到 $8,750 的比例 | 0% |
| 最好一次 | $8,046(seed 1005714) |
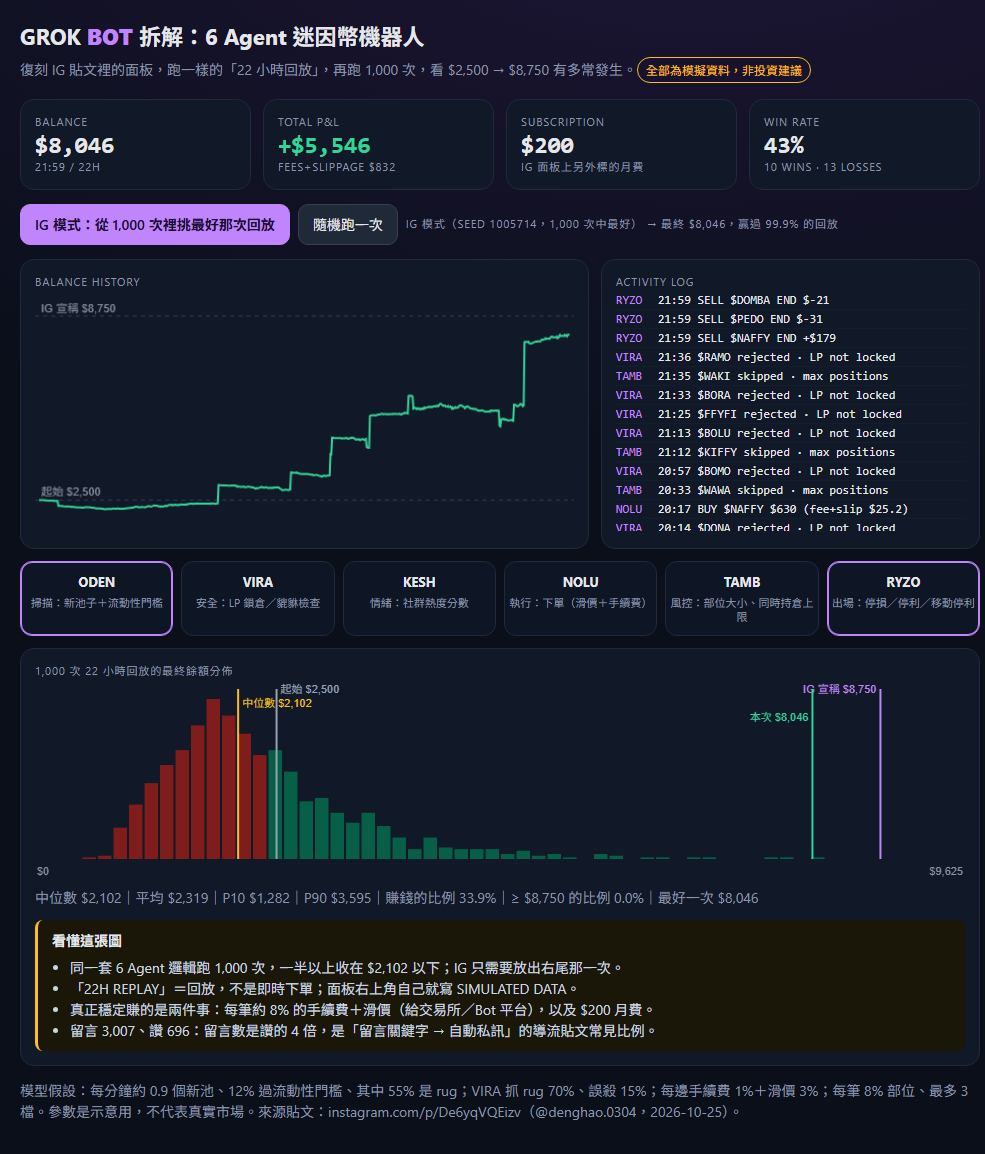
把這次放進面板,餘額曲線一路往上,看起來跟影片很像。下面的直方圖是另外 999 次:紅色是虧錢的,佔了三分之二。
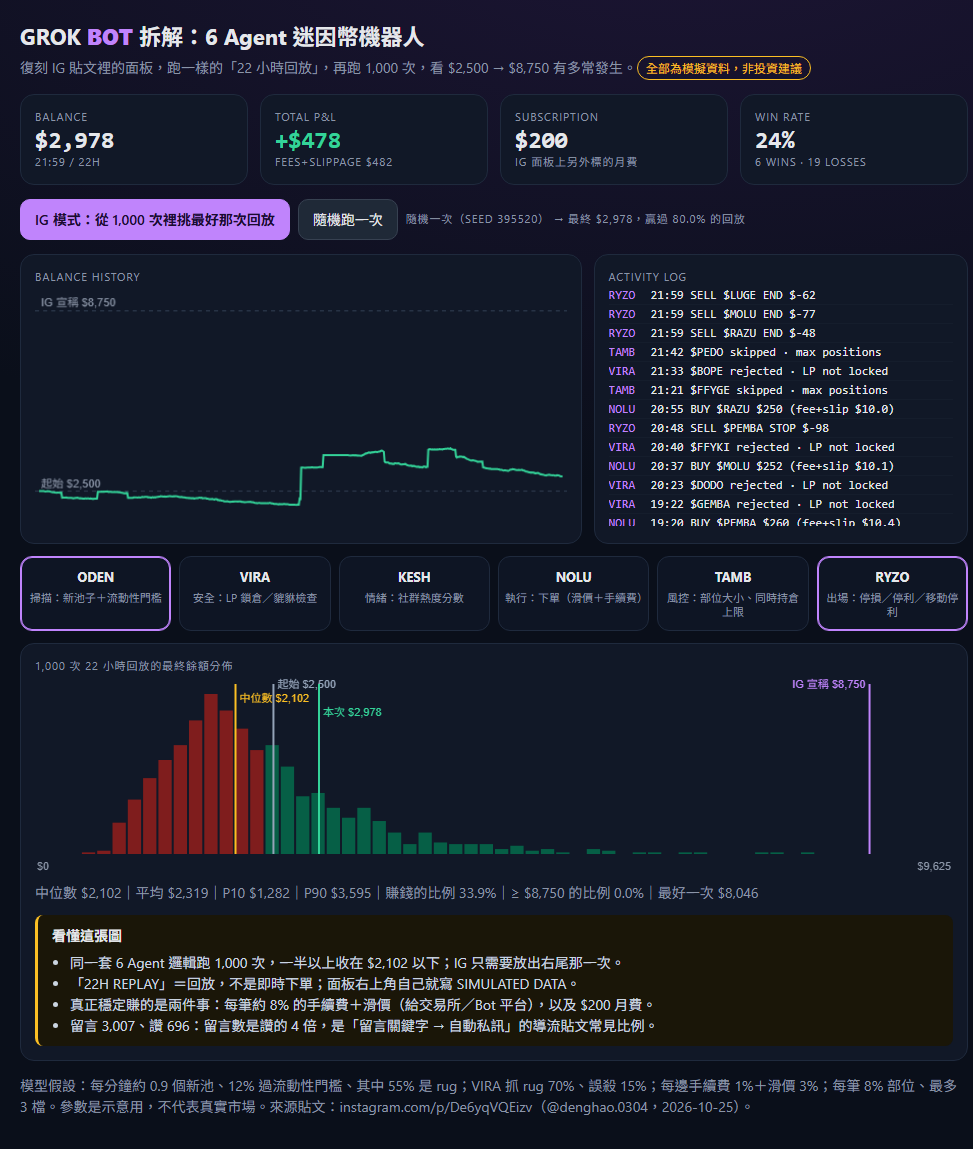
隨機挑一個 seed(395520)跑一次,結果是 $2,978,贏過 80% 的回放。這已經算運氣不錯的一次,勝率 24%,6 勝 19 敗:
要挑幾次,才挑得出影片那種結果?
1,000 次沒有一次到 $8,750,我把次數拉到 10,000:
runs=10000 median=$2103 mean=$2312 p1=$868 p99=$5631
profitable=33.3%  >=$8,750: 4 runs (0.04%)  best=$11349 seed=66369140
pick-best-of-10 median=$4022 pick-best-of-100 → $5888- 10,000 次裡有 4 次到 $8,750 以上,最好的一次是 $11,349。
- 「跑 10 次、挑最好看的那次」重複 1,000 回,挑出來的中位數是 $4,022,已經是起始資金的 1.6 倍。
- 跑 100 次挑最好的,中位數是 $5,888。
手續費和滑價吃掉多少?
同樣 1,000 個 seed,只把手續費和滑價設成 0:
no-fee runs=1000 median=$2467 profitable=48.9% best=$11645 >=3.5x=0.2%| 有成本(每邊 4%) | 零成本 | |
|---|---|---|
| 中位數 | $2,102 | $2,467 |
| 有賺的比例 | 33.9% | 48.9% |
| 到 3.5 倍的比例 | 0% | 0.2% |
看到 AI 交易機器人的獲利影片,先看哪四件事?
- 畫面有沒有寫 SIMULATED、DEMO、REPLAY、BACKTEST。 這支影片三個都寫了,字很小,在右上角和標題下方。
- 給的是一次結果還是一個分佈。 只給一條曲線時,問它是第幾次、總共跑了幾次。我的模擬裡,挑 10 次中最好的就能拿出 1.6 倍。
- 成本有沒有算進去。 手續費、滑價、訂閱費,這三項在我的模擬裡決定了中位數是賺還是賠。
- 要你做什麼才拿得到「系統」。 這支影片是 3,000 多則留言、696 個讚,留言比讚多 4 倍多,前一輪研究時看到的留言多是 emoji、「想要」「給我指南」這類短字。我沒有留言去換,所以不知道私訊送的是什麼。
這個模擬能證明什麼、不能證明什麼?
能證明的:一套有正常篩選流程、但沒有真實優勢的狙擊機器人,跑夠多次就會出現 3 倍以上的回放,而且這些回放本身是照規則產生的。
不能證明的:
- 不能證明影片裡的機器人會虧錢。 我沒有它的程式、參數或交易紀錄,模擬的是「面板描述的流程」,不是那個產品。
- 參數沒有校準。 rug 比例、暴衝機率、滑價都是示意值。換一組參數,中位數可以是賺的,也可以虧得更多。要更接近真實,得用 DexScreener 或 Birdeye 的新池資料去校準,這次沒有做。
- 真實行情的尾巴更胖。 迷因幣有一天 100 倍的,也有開盤一分鐘就歸零的,我的暴衝上限是單分鐘 +150%。
自己跑一次
我把模擬器做成單一 HTML 頁,放在 html.yanchen.app/grok-bot-mc。按「IG 模式」會從 1,000 次裡挑最好的那次回放,按「隨機跑一次」會隨機挑一個 seed。每次都會在底部的直方圖標出這次落在哪裡。
整頁沒有外部依賴,模擬器原始碼就內嵌在頁面裡,用瀏覽器「檢視原始碼」就能讀到所有參數。想改參數,存成本機檔案,把 DEFAULTS 裡的數字改掉再開。
常見問題
影片裡的 GROK BOT 是 xAI 的產品嗎?
我在面板上找不到 xAI 或 SpaceXSI 的標示。xAI 官方 2026-08 推出的 Grok Bot 是處理 Gmail、CRM 等工作的 agent,不是交易機器人。
22H REPLAY 是什麼意思?
字面是「22 小時的回放」,也就是把一段已經跑完(或模擬完)的過程重播,不是即時下單。同一個面板右上角標著 SIMULATED DATA,表示播放的資料是模擬的。
我的模擬可以拿來決定要不要用交易機器人嗎?
不行。參數是示意值,沒有用真實鏈上資料校準。它只示範「挑最好的一次」能讓一套沒有優勢的流程看起來多好。
資料來源
- IG 原影片(@denghao.0304,2026-10-25;讚數與留言數為 2026-10-29 讀取)
- 互動模擬器(本文所有數字的來源,參數與程式碼內嵌於頁面)
- Grok bot 是什麼?X 上的 @grok 跟 2026 新出的 Grok Bot 差在哪(xAI 官方 Grok Bot 的整理)