懶人包
- i-have-adhd 是 GitHub 上 ayghri 做的開源 skill(MIT,2026-11-01 查 59,667 星),本體是一份 10 條規則的 SKILL.md,不是程式;它不讓模型變聰明,只改回答的形狀。
- 我用 6 題中文開發題在 Claude Sonnet 上跑 A/B,每組 2 次共 24 次:平均字數 1578 → 910(少 42%),開場白 17% → 0%,結尾給「下一步:」0% → 100%。
- 答案本身都還在。砍掉的是延伸內容,例如 AbortController、預防措施,還有「需要我幫你…嗎?」這種收尾(12 次裡 8 次 → 0 次)。
- 「解釋型」題目砍得最少:JWT 對 session 只少 28%,因為 skill 自己規定被要求解釋時要講完整。
- Claude Code 安裝是兩行
claude plugin指令,我在隔離的設定目錄裝到 0.4.1 並實際用/i-have-adhd觸發過;它預設不會自動套用,要手動打指令或建旗標檔。- 已經在 CLAUDE.md 寫了「結論先行、禁開場白」的人不用整包裝,挑「發送前自查」「時間估算用分鐘」「清單最多 5 項」三條進去就好。
2026-10-19,IG 帳號 @kwons_en 發了一支 Reel:Claude 回答老是先講一堆廢話,最後才告訴你要做什麼;有人做了一個叫 I have ADHD 的 skill,GitHub 上 5.7 萬顆星,裝完之後第一句就告訴你下一步。完整安裝方法要留言「廢話」才私訊給你。
星數我查了,屬實。安裝方法不用留言,官方 repo 的 INSTALL.md 就寫著。我比較想知道的是另一件事:它對中文的開發問題到底改了什麼。所以我拿自己會問的 6 題跑了一次 A/B,下面是數字、原文對照和裝法。
i-have-adhd 是什麼?
ayghri/i-have-adhd 是 2026-05-13 建立的開源專案,MIT 授權。2026-11-01 用 gh repo view 查到 59,667 星、3,471 fork,最後一次 push 是 2026-10-19。
它的核心只有一個檔案:skills/i-have-adhd/SKILL.md。裡面是 10 條輸出規則,加上「什麼時候可以破例」和「發送前自查」兩段。repo 另外包了 Claude Code plugin、Codex、Cursor、Gemini CLI 等工具的安裝殼,規則本身都是同一份。
10 條規則:
| # | 規則 | 實際效果 |
|---|---|---|
| 1 | Lead with the next action | 第一行就是能動手做的事,不是背景 |
| 2 | Number multi-step tasks | 超過一步就編號,每步只做一件事 |
| 3 | End with one concrete next action | 結尾留一個兩分鐘內做得完的動作 |
| 4 | Suppress tangents | 第二個問題做完第一個再問,不夾在中間 |
| 5 | Restate state every turn | 每輪重講「5 步做到第 3 步」 |
| 6 | Specific time estimates | 時間用分鐘,不說「要花點工夫」 |
| 7 | Make completed work visible | 做完講「現在什麼能用了」 |
| 8 | Matter-of-fact tone for errors | 錯誤只講位置、原因、修法 |
| 9 | Cap lists to 5 items | 一組清單最多 5 項,其餘留著不丟 |
| 10 | No preamble, no recap, no closing pleasantries | 禁「好問題」「希望有幫助」 |
rm -rf、force push 這類破壞性動作要先確認;同一個 bug 連續三輪沒修好,就停下來指出可能錯的假設。
作者在 repo 的 evals/RESULTS.md 放了自己的評測:claude-opus-4-8、14 題各跑 3 次、同模型盲評。加權分數 4.045 → 4.473,Concision +1.14、Actionability +0.71,Correctness 4.333 → 4.524,沒有因為變短而變錯。那是英文題,所以我補了中文的。
我怎麼測?
6 題都是我平常會問的開發問題:
| 題目 id | 問的事 |
|---|---|
| springboot-datasource | Spring Boot 4 啟動噴 Failed to configure a DataSource |
| react-infinite-loop | useEffect 依賴 [user] 造成無限重新渲染 |
| vite-gh-pages | Vite + React 用 GitHub Actions 部署到 GitHub Pages |
| leaked-env | .env 裡的 OpenAI key 被 push 到公開 repo |
| mssql-slow | 500 萬筆表用 CONVERT(varchar, CreatedAt, 112) 查詢很慢 |
| explain-jwt | 解釋 JWT 跟 server-side session 差在哪 |
claude -p --model sonnet:
- baseline:system prompt 只有
You are a helpful assistant. - adhd:同一句後面接上 SKILL.md 本文(去掉 frontmatter)
sp = BASE if cond == "baseline" else BASE + "\n\n" + SKILL_BODY
subprocess.run(["claude", "-p", "--model", "sonnet", "--tools", "",
                "--setting-sources", "", "--system-prompt", sp],
               input=case["prompt"], capture_output=True, text=True, encoding="utf-8")
--setting-sources "" 加上 --system-prompt 是為了不讓我自己的 CLAUDE.md 混進來。我的全域設定本來就寫了「結論先行」,不隔離的話兩組都會被它影響。跑之前我先用一題探針確認過,回答裡沒有出現只有我的 CLAUDE.md 才會有的稱呼。
開場白、結尾、下一步用 regex 判斷,不是人工或 LLM 評分。
結果:字數少 42%,第一行換成動作
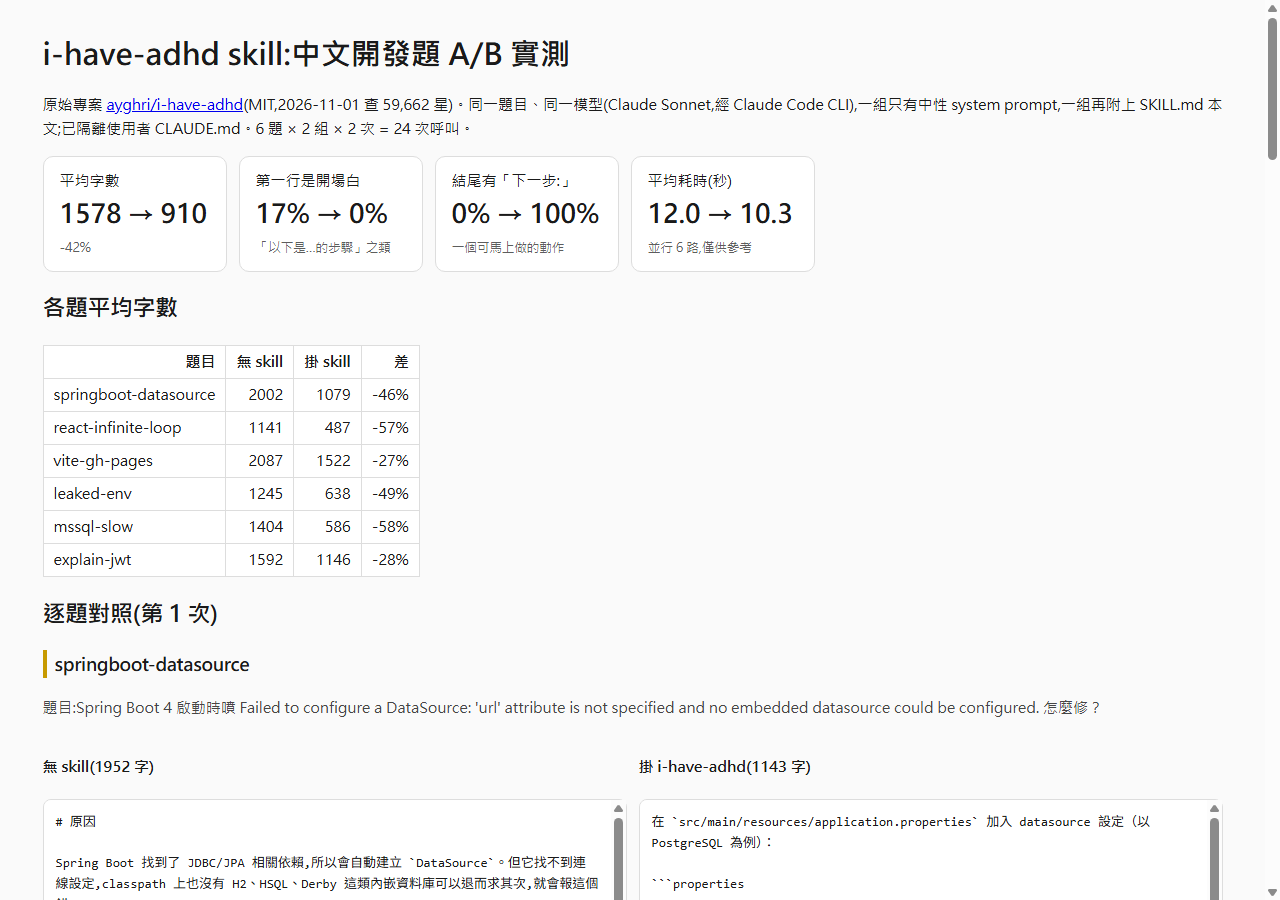
| 指標(各 12 次) | baseline | adhd |
|---|---|---|
| 平均字數 | 1578 | 910 |
| 第一行是開場白 | 17% | 0% |
| 結尾有「下一步:」 | 0% | 100% |
| 最後一行是「我可以幫你/需要我…」 | 8 次 | 0 次 |
| 題目 | baseline | adhd | 差 |
|---|---|---|---|
| mssql-slow | 1404 | 586 | -58% |
| react-infinite-loop | 1141 | 487 | -57% |
| leaked-env | 1245 | 638 | -49% |
| springboot-datasource | 2002 | 1079 | -46% |
| explain-jwt | 1592 | 1146 | -28% |
| vite-gh-pages | 2087 | 1522 | -27% |
第一行長怎樣?
同一次跑(第 1 次)的第一行:
| 題目 | baseline 第一行 | adhd 第一行 |
|---|---|---|
| react-infinite-loop | ## 原因 | 把依賴陣列 [user] 改成 []: |
| mssql-slow | 問題原因:對欄位套用函數… | 改成範圍查詢,讓索引可以被使用: |
| leaked-env | # 先做最重要的:立刻撤銷 (revoke) 金鑰 | 現在先做:到 https://platform.openai.com/api-keys 刪除(Revoke)那把 key。 |
| vite-gh-pages | 以下是把 Vite + React 專案…部署到 GitHub Pages 的步驟。 | 在 vite.config.ts 加上 base(值是你的 repo 名稱)。全部做完約 10 分鐘。 |
砍掉的是什麼?
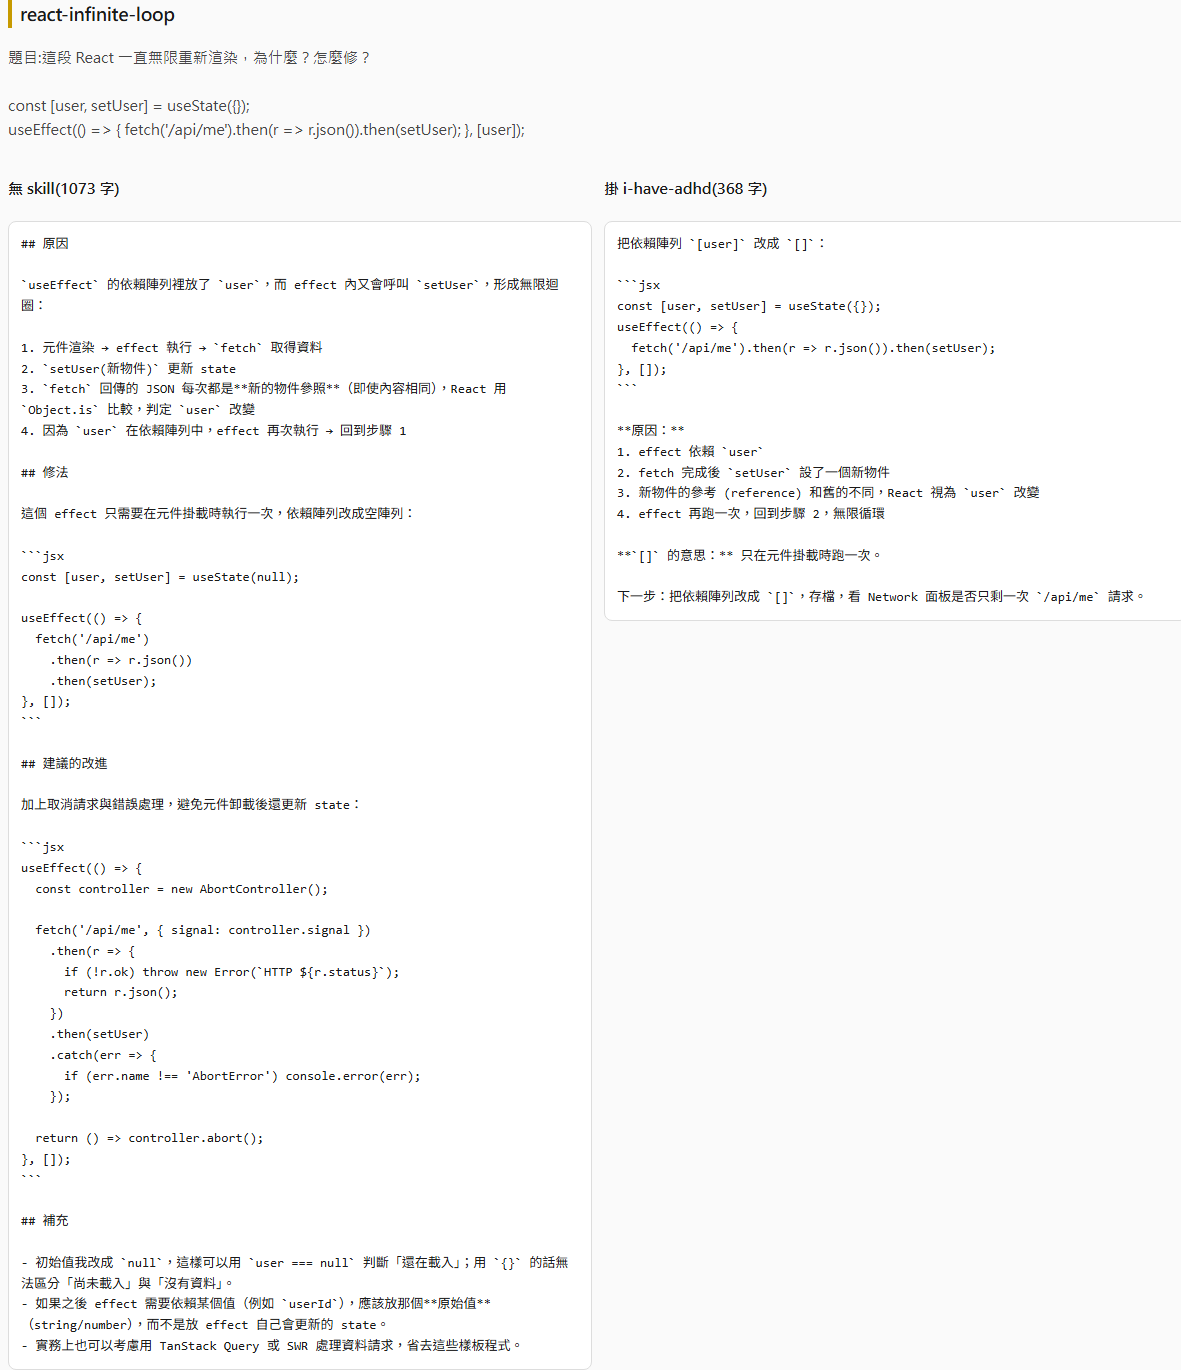
React 這題,baseline 1073 字:原因、修法、加 AbortController 的改進版、初始值改 null 的建議、推薦 TanStack Query。adhd 368 字:改依賴陣列、四步說明為什麼會無限循環、最後一行「下一步:把依賴陣列改成 [],存檔,看 Network 面板是否只剩一次 /api/me 請求」。
修法兩邊一樣。adhd 版少的是你沒問的東西。要不要那些延伸,看你當下是在救火還是在學習。
結尾也換了。baseline 12 次裡有 8 次最後一行是「如果你貼上 pom.xml…我可以幫你判斷」「需要我幫你檢查目前專案的設定嗎?」這類提議;adhd 12 次都換成一個具體動作,例如「把新查詢貼到 SSMS 跑一次,告訴我執行計畫是 Seek 還是 Scan」。
Claude Code 怎麼安裝?
官方 INSTALL.md 的 Claude Code 段落是兩行。我用一個空的 CLAUDE_CONFIG_DIR 照著跑,避免動到自己平常的設定:
claude plugin marketplace add ayghri/i-have-adhd
claude plugin install i-have-adhd@i-have-adhd
claude plugin list
輸出(Claude Code 2.1.316):
✔ Successfully added marketplace: i-have-adhd (declared in user settings)
✔ Successfully installed plugin: i-have-adhd@i-have-adhd (scope: user)
Installed plugins:
  ❯ i-have-adhd@i-have-adhd
    Version: 0.4.1
    Scope: user
    Status: ✔ enabled
裝完要在對話裡打 /i-have-adhd 才會生效。SKILL.md 的 frontmatter 是 disable-model-invocation: true,模型不會自己決定套用。之後整個 session 都會維持,說「stop adhd mode」或「normal mode」關掉。
想每次開新 session 都自動套用,建一個旗標檔,plugin 帶的 SessionStart hook 看到它就會注入整份規則:
touch ~/.claude/.i-have-adhd-always刪掉這個檔就恢復手動模式。
驗證有沒有生效
我用 --plugin-dir 只在單次呼叫載入這個 plugin,再丟同一題 React:
claude -p --model sonnet --setting-sources "" \
  --plugin-dir ~/.claude/plugins/cache/i-have-adhd/i-have-adhd/0.4.1/ \
  "/i-have-adhd 這段 React 一直無限重新渲染怎麼修? ..."
回答第一行是「修法:把依賴陣列改成 []。」,最後一行是「Next: 把 [user] 改成 [],存檔,看 Network 面板是否只剩一次 /api/me。」。這次它把 AbortController 留下來了,但標成「可選改進(2 分鐘)」放在修法後面,沒有擠到前面。
Codex、Gemini CLI、GitHub Copilot、OpenCode、Cursor 等 15 種工具的裝法在 INSTALL.md 各有一段,我只測了 Claude Code。
有什麼限制和踩坑?
數字是小樣本。 每組 12 次、單一模型(Sonnet),開場白和下一步是 regex 判斷。方向可信,-42% 這個數字換一批題目一定會變。
closer 指標量不到中文的收尾。 我原本的 regex 抓「希望有幫助」「如果還有」,兩組都是 0%。Sonnet 的中文收尾長得像「需要我幫你…嗎?」,要另外用「我可以/需要我/要我」去抓,才看得出 8 次對 0 次的差別。自己測的時候,regex 要照實際輸出調。
延伸內容是真的被砍掉。 學新東西時,baseline 那段「為什麼初始值要用 null」可能才是你要的。skill 的破例條款只認「explain」「walk me through」這類明確要求,想要完整背景就直接說「解釋給我聽」。
跟既有的 CLAUDE.md 可能重疊或衝突。 我自己的全域設定已經有「結論先行」「不寫開場白」,跟規則 1、10 重複。規則 3「結尾一定給一個下一步」則跟我「做完一句話回報就停」的設定方向相反。兩份規則同時載入時,模型要自己取捨,結果比只載一份難預測。
它沒有讓模型更會解題。 6 題的修法在兩組裡都一樣,差別只在排列順序和取捨。
要不要裝?
| 你的狀況 | 建議 |
|---|---|
| 沒寫過 CLAUDE.md,常覺得回答太長 | 裝,開 always-on |
| 已經在 CLAUDE.md 寫了輸出風格 | 不整包裝,挑規則抄進去 |
| 主要拿 Claude 學新技術 | 只在救火時手動 /i-have-adhd |
| 想評估自己寫的 skill | 看它的 evals/,有 rubric、盲評和 release gate 可以照抄 |
- 發送前自查:刪掉預告式的第一句、問「還有別的嗎」的最後一句、by the way 旁支、沒有資訊量的 hedge。
- 時間估算用具體單位:「約 15 分鐘」,不說「要一點時間」。
- 清單一組最多 5 項:多的留著,等被問或輪到時再列。
延伸資源
- ayghri/i-have-adhd:原始 repo,SKILL.md 全文、各工具安裝法、
evals/評測工具 - i-have-adhd A/B 對照頁:本文 6 題 24 次的完整原文,左右並排
- Matt Pocock 的 skills 怎麼約束 AI agent:另一組用 skill 規範 agent 行為的做法
- find-skills:在 Claude Code 裡搜尋可用的 skill:裝之前先找有沒有更合適的