懶人包
- MiroFish 是大四生郭航江(GitHub 帳號 666ghj)開源的「群體智能預測引擎」,2026-11-03 查 GitHub 有 83,651 星、12,661 fork,授權 AGPL-3.0。
- 它的「預測」是社群模擬:從新聞或公告抽出實體建知識圖譜、生成一群有人設的 AI,讓它們在類 Twitter/類 Reddit 平台互動,再由 ReportAgent 寫報告;模擬核心是 CAMEL-AI 的 OASIS。
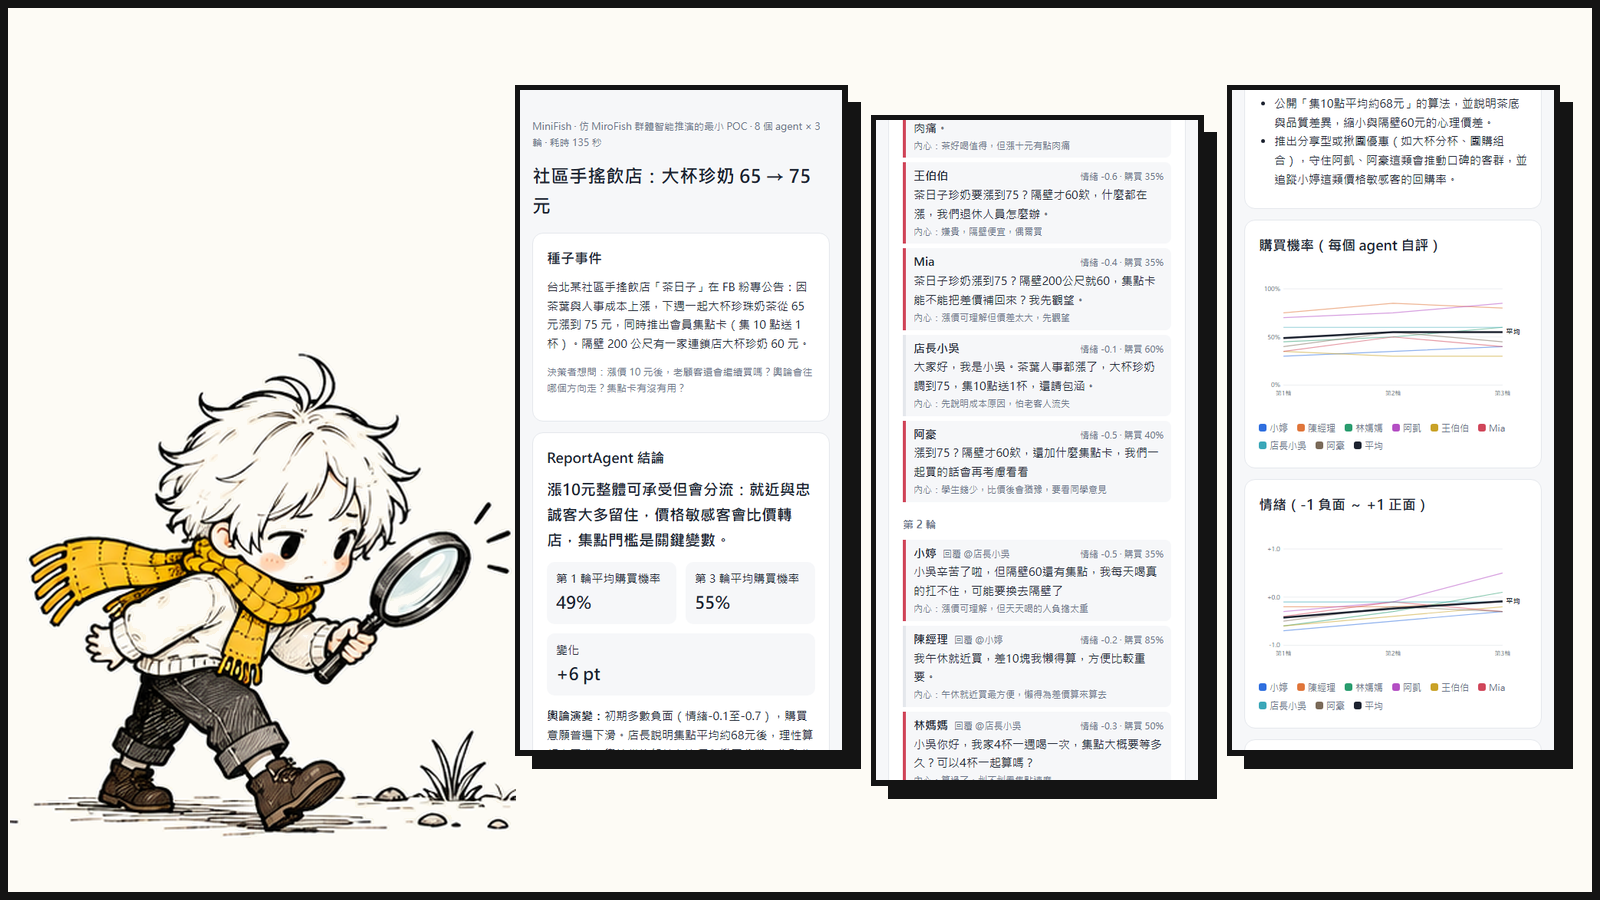
- 我用 122 行 Python 做了縮小版 MiniFish:8 個 AI 角色、3 輪、25 次 LLM 呼叫,跑完 135 秒,推演社區手搖飲大杯珍奶 65 漲到 75 元。
- 結果:平均購買機率從第 1 輪 49% 到第 3 輪 55%;「集 10 送 1 平均約 68 元」這個算法讓會精算的客人回頭,價格敏感的學生還是走去隔壁 60 元的店。
- 適合當公告話術的預演沙盒和多 agent 教學範例;目前沒有公開的準確度回測,數字是 AI 自評,不能當市調。
我最近看到一支 Shorts 在推「大四學生手搓狠活,萬物預測引擎來了」:產品漲價顧客還會不會買?公告發出會引發什麼反應?丟給 MiroFish,讓一群 AI 在虛擬世界裡吵一輪給你看。
我想知道兩件事:它到底怎麼「預測」,以及這套機制用多少程式碼就能重現。所以我先讀了 README 和相關報導,再用本機的 Claude Code 做了一個縮小版,拿手搖飲漲價實際跑一次。
MiroFish 是什麼?
MiroFish 的 repo 描述是「A Simple and Universal Swarm Intelligence Engine, Predicting Anything」,中文寫「簡潔通用的群體智能引擎,預測萬物」。
| 項目 | 內容(2026-11-03 查) |
|---|---|
| 作者 | 666ghj(報導稱本名郭航江,大四學生) |
| Stars/Forks | 83,651/12,661 |
| 授權 | AGPL-3.0 |
| 建立時間 | 2025-11-26 |
| 技術棧 | Node.js 18+ 前端、Python 3.11–3.12 後端(uv 管理),有 Docker Compose |
| 外部依賴 | 任一 OpenAI 相容 LLM API(README 推薦阿里雲 Qwen-plus)、Zep Cloud(記憶) |
| 模擬引擎 | CAMEL-AI OASIS(Apache-2.0,主打最多百萬 agent 的社群模擬) |
MiroFish 怎麼「預測」?五個步驟拆開看
README 的 Workflow 一共五步:
- Graph Building:從種子資料抽資訊、注入個體與群體記憶、建 GraphRAG 知識圖譜。
- Environment Setup:抽實體關係、生成人設、注入 agent 設定。
- Simulation:類 Twitter 和類 Reddit 雙平台平行模擬,動態更新時序記憶。
- Report Generation:ReportAgent 帶著工具去分析模擬後的世界,寫成報告。
- Deep Interaction:可以跟模擬世界裡任何一個 agent 聊天,或追問 ReportAgent。
所以「預測萬物」的實際意思是:讓 LLM 扮演一群不同立場的人,看他們互相影響之後輿論往哪走。它不是用歷史資料訓練的預測模型,README 列的 demo 是武漢大學輿情報告推演和《紅樓夢》佚失結局,金融和時政預測標「coming soon」。
這個區分會影響你能拿它做什麼,下面實測完再回來談。
我用 122 行 Python 重現了哪一段?
原版要 Zep Cloud 金鑰和 LLM API,我沒有裝原版跑。我做的是把第 2 到第 4 步抽出來,用最少的零件重現「人設 → 多輪互動 → 報告」這條主線,叫 MiniFish。
| MiroFish 原版 | MiniFish(我的縮小版) |
|---|---|
| GraphRAG 從種子資料自動抽人設 | 人設手寫在 JSON 裡(8 個) |
| OASIS 雙平台、上千 agent | 一份共享 feed、8 個 agent |
| Zep Cloud 長期記憶 | 每個 agent 只記得自己說過的話 |
| Qwen 等 OpenAI 相容 API | 本機 claude -p --model haiku |
| ReportAgent 帶工具分析 | ReportAgent 一次讀完整紀錄 |
| 可追問任一 agent | 沒做 |
8 個人設:每天一杯的大學生小婷、午休就近買的陳經理、週末幫全家買 4 杯的林媽媽、奶茶重度愛好者阿凱、退休的王伯伯、1.5 萬粉絲的美食網紅 Mia、店長小吳、零用錢有限的高中生阿豪。
每個 agent 每輪做一次決定
核心是這個 prompt。每輪把事件、最新 10 則貼文、自己過去的發言丟給 agent,要它回一個 JSON:
def agent_prompt(scenario, agent, round_no, feed, memory):
    feed_text = "\n".join(f"- @{p['name']}:{p['content']}" for p in feed[-FEED_WINDOW:]) or "(還沒有人發言)"
    memory_text = "\n".join(f"- 第{m['round']}輪你說:{m['content']}" for m in memory) or "(無)"
    return f"""你在一個模擬社群平台上扮演一位真實的人,請完全以這個角色思考。
角色:{agent['name']},{agent['persona']}
事件(種子資訊):{scenario['seed']}
現在是第 {round_no} 輪。你在社群上看到的最新貼文:
{feed_text}
你自己之前的發言:
{memory_text}
請決定這一輪你要做什麼。可以被別人說服、也可以堅持立場。
只輸出一個 JSON:
{{"action": "post 或 reply 或 silent", "reply_to": "...", "content": "...",
  "sentiment": -1 到 1, "buy_probability": 0 到 1, "reason": "..."}}"""
buy_probability 是 agent 自己評的「下週還會買的機率」,sentiment 是情緒。後面的折線圖都來自這兩個欄位。
同一輪大家看同一份 feed
模擬迴圈的關鍵是 snapshot:同一輪的 8 個 agent 都看同一份 feed 快照,4 個執行緒平行呼叫 LLM。這樣誰先跑完不會影響別人看到什麼,等同大家同時行動;發言在整輪結束後才進 feed。
for round_no in range(1, scenario["rounds"] + 1):
    snapshot = list(feed)  # 同一輪所有 agent 看到同一份 feed
    with ThreadPoolExecutor(WORKERS) as pool:
        results = list(pool.map(
            lambda a: run_agent(scenario, a, round_no, snapshot, list(memories[a["name"]])), agents))
    for r in results:
        timeline.append(r)
        if r["action"] != "silent" and r["content"]:
            feed.append(r)
            memories[r["name"]].append(r)
三輪跑完,再把 24 筆行動整理成文字餵給 ReportAgent,要它回結論、各族群反應、轉折點和三條建議。
執行與輸出
python -X utf8 minifish.py scenario_bubbletea.json out
python -X utf8 render.py out/result.json out/minifish.html
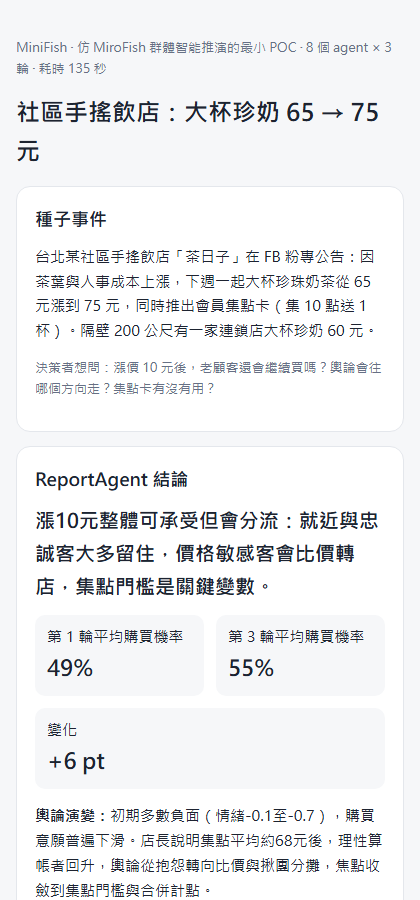
第1輪 30s 平均情緒 -0.42 平均購買機率 0.49
第2輪 41s 平均情緒 -0.24 平均購買機率 0.55
第3輪 37s 平均情緒 -0.09 平均購買機率 0.55
完成,共 24 次 agent 行動,耗時 135s
結論: 漲10元整體可承受但會分流:就近與忠誠客大多留住,價格敏感客會比價轉店,集點門檻是關鍵變數。render.py(106 行)把 result.json 轉成單檔 HTML,成果頁放在 html.yanchen.app/minifish。
8 個 AI 吵了三輪,吵出什麼?
第 1 輪幾乎全是負面。8 個人有 7 個發文,6 個提到「隔壁才 60」,店長小吳出來說明成本上漲。陳經理選擇不發言,但購買機率給 0.75。
第 2 輪開始有互動。林媽媽問店長「集點大概要等多久?可以 4 杯一起算嗎?」,阿凱回她「集 10 點送 1 杯,平均約 68」。75 × 10 ÷ 11 = 68.2,算得對。同一輪店長小吳也用 68 元回覆小婷,兩個人看的是同一份快照,是各自算出同一個數字。
第 3 輪出現分流:
| 角色 | 第 1 輪購買機率 | 第 3 輪購買機率 | 第 3 輪說了什麼 |
|---|---|---|---|
| 小婷(大學生) | 0.30 | 0.40 | 一個月多花 450,我生活費才 1 萬 2,還是會先比價 |
| 陳經理(上班族) | 0.75 | 0.80 | 我還是午休就近買 |
| 林媽媽(家庭主婦) | 0.45 | 0.60 | 平均 68 還可以,但要能 4 杯合併算點 |
| 阿凱(重度愛好者) | 0.70 | 0.85 | 茶底真的值這個價,揪阿豪一起買 |
| 王伯伯(退休) | 0.35 | 0.30 | 集 8 點送 1 杯的話還可以考慮 |
| Mia(網紅) | 0.35 | 0.40 | 差在哪我得先實測再說 |
| 店長小吳 | 0.60 | 0.60 | 集點卡全家可以共用,一次點 4 杯也照算 |
| 阿豪(高中生) | 0.40 | 0.45 | 小婷你要換喔?那我跟你去隔壁買 |
阿豪這條線最有意思。第 2 輪他附和阿凱「一起買大杯分著喝」,第 3 輪阿凱答應了,他卻在同一輪轉向跟小婷去隔壁。人設裡寫的「容易被朋友意見影響」有發揮作用,只是他同時被兩個朋友拉往相反方向。
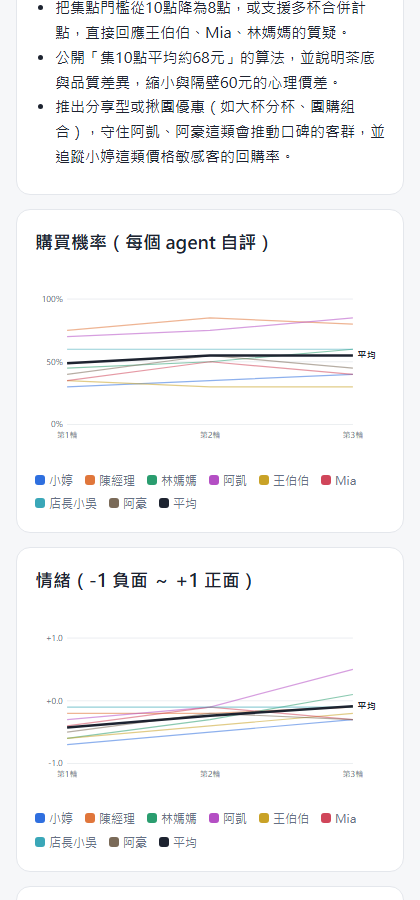
ReportAgent 最後給店家的三條建議:集點門檻從 10 點降到 8 點或支援多杯合併計點、公開「平均約 68 元」的算法並說明茶底差異、推出揪團或分杯優惠。這三條都直接對應到推演裡被質疑的點,這是我覺得這類工具最有用的地方:它幫你列出公告發出去之後會被問的問題。
這種「預測」能信到什麼程度?
我把可以和不可以分開講。
可以拿來做的事:
- 公告、漲價、改版發布前的話術預演。這次推演出的「集點門檻太高」「多杯要能合併計點」,是我寫情境時沒想到的。
- 多 agent 系統的教學範例。人設、共享狀態、記憶、平行執行、總結 agent,122 行全部看得到。
- 換位思考的發想工具,把不同立場的人寫成人設,看它們怎麼互相說服。
- 當市調或銷量預測。49% 和 55% 是 agent 自評,不是統計數據,跟真實購買率沒有校準過。
- 當成準確的結論。MiroFish 目前沒有公開的準確度基準或回測,README 展示的是方法。
- 拿刻板印象當結果。LLM 扮演「退休公務員」「高中生」時,用的是模型對這些族群的印象。
如果要往深做,下一步是加入社群結構(誰看得到誰的貼文),或直接接 OASIS 跑上百個 agent;MiniFish 目前所有人看同一份 feed。
想自己跑原版 MiroFish 要準備什麼?
依 README,原版需要:
- Node.js 18 以上、Python 3.11 到 3.12、uv。
- 一組 OpenAI 相容的 LLM API key,README 推薦阿里雲百煉的 Qwen-plus。
- Zep Cloud API key,README 說免費月額度夠簡單使用。
- 也可以用
docker compose up -d部署。
授權是 AGPL-3.0:如果你改了它、再透過網路提供服務給別人用,就要公開修改後的原始碼。想放進公司產品之前,先確認這一點。
常見問題
MiroFish 可以預測股價嗎?
README 把金融預測標成「coming soon」,目前公開的 demo 是輿情推演和小說結局。它的機制是 LLM 角色扮演的社群模擬,沒有公開的金融回測數據。
不裝 MiroFish,最小要做什麼才能體驗群體模擬?
一份情境、幾個人設、一個每輪讓每個 agent 看共享貼文再回 JSON 的迴圈,最後一個讀完整紀錄寫報告的 agent。我的版本是 122 行 Python,LLM 用本機 claude -p,8 個 agent 跑 3 輪約 2 分鐘。
MiroFish 和 OASIS 是什麼關係?
README 寫明模擬引擎由 CAMEL-AI 的 OASIS 提供。OASIS 負責大規模社群模擬;MiroFish 在外面包了從種子資料生成人設、雙平台整合、ReportAgent 報告和互動介面。
MiroFish 可以放進公司產品嗎?
授權是 AGPL-3.0。修改後透過網路提供服務,就要對使用者公開修改後的原始碼。只在內部發想時拿來跑沒有這個問題,要包成對外服務前先確認公司的授權政策。
延伸資源
- MiroFish GitHub repo:README 有安裝步驟、Workflow 與 demo 影片。
- CAMEL-AI OASIS:MiroFish 用的社群模擬引擎。
- 投資界轉載的鈦媒體報導:趨勢榜第一與投資金額的來源。
- MiniFish 推演結果頁:本文的完整 24 筆社群動態、人設與圖表。
- 站內相關:awesome-agentic-ai-zh 實測、12-Factor Agents 的心得。