懶人包
- Threads 上 Jerry T 拿同一張平面圖給 ChatGPT Pro-6 和 Claude Sonnet 5.5 做 3D:ChatGPT 來回三次還改了格局,Claude 一次就把位置做對。貼文 794 讚、10 萬瀏覽。
- 兩邊交出來的東西本質不同。ChatGPT 生的是一張新的渲染圖,格局是模型重新畫出來的;Claude 寫的是建模程式,牆和門的位置直接從平面圖座標算出來。
- 我把「讀圖」這一步拆出來做盲測:程式隨機產生平面圖、答案鎖在 JSON 裡,Claude 只看圖片寫出座標,再交給 three.js 長成 3D。三輪共 18 間房 IoU 全部 1.000,35 個門窗誤差 0 cm。
- 第三輪把圖縮成 510 × 460 的低畫質 JPEG(1 像素 = 2 公分)照樣全對,關鍵是比例尺和「10 公分格線、門寬 90 公分」這類製圖慣例讓讀值可以對齊。
- 限制寫在前面:測試圖是我自己程式畫的乾淨圖,沒有尺寸線、門弧和家具符號;ChatGPT 那一邊我沒有實測。要的是正確格局就讓 AI 寫程式建模,要的是好看的示意圖才用生圖。
Threads 帳號 @jerry1995 的貼文:平常 ChatGPT 用得比較多,這次拿同一張平面圖請 ChatGPT Pro-6 和 Claude Sonnet 5.5 做 3D 建模。ChatGPT 來回三次還做不出正確的東西,而且自己改了平面圖;Claude 一次完成,全部位置正確。左邊放 Claude 的 3D 模型影片,右邊放 ChatGPT 的四格渲染圖。
留言區有一則問得很準:「但左邊是模型,右邊是已完成的渲染?」作者回覆,兩邊都是他請 AI 做 3D 模型給他,Claude 做的是正確的位置和擺設,ChatGPT 則是改了平面圖之後再渲染。
這篇要回答的是:為什麼一邊會改格局、一邊不會。我的答案是兩邊走的是兩條不同的路,而 Claude 那條路的準確度可以被量測。我做了三輪盲測來量它。
原文比的兩種輸出差在哪?
看原文的兩張圖就知道,這不是同一種產出:
| Claude(左) | ChatGPT(右) | |
|---|---|---|
| 交出來的東西 | 可以旋轉的 3D 模型(影片) | 四格 2D 渲染圖加一欄文字說明 |
| 格局從哪來 | 平面圖上的座標 | 模型看完平面圖後重新畫 |
| 外觀 | 方塊牆、家具,偏示意 | 有材質、光影,像室內設計提案 |
| 改錯的方式 | 改 JSON 或程式裡的數字 | 再下一次 prompt,重畫一次 |
為什麼生圖會改格局、寫程式不會?
兩條路的差別畫出來是這樣:
生圖這條路,格局在每次生成時都會被重新決定。OpenAI 自己的 GPT Image 提示指南 寫得很直白:「Repeated edits can still change details you intended to preserve」,重複修改仍可能改掉你想保留的細節,要每次重申限制並逐張檢查;真的不能動的區域,建議把通過的修改合成回原圖,不要只靠 prompt。作者「來回三次」的經驗,正好落在這段說明描述的情況裡。
寫程式這條路,3D 只是把數字擠成方塊。three.js 不會「想像」牆該在哪,JSON 寫 390 公分就蓋在 390 公分。所以準確度只取決於一個環節:LLM 把圖讀成數字時有沒有讀對。
我怎麼驗「讀圖」這一步準不準?
既然整條管線的風險集中在讀圖,我就只測讀圖。設計如下:
- 用 Python 寫一支
gen_blind.py,以 BSP(二元空間切割)把長方形外框隨機切成 5 到 7 間房,每道隔間牆開一扇門,靠上下外牆的房間開窗,左牆開大門。 - 腳本把標準答案寫進
blind_<seed>.json,另外畫一張 PNG。執行時只印出檔名,不印任何座標。 - Claude(這次是我在 Claude Code 裡用的 Claude Opus 5.5,直接看圖,沒有呼叫 API)只看 PNG,寫出
extracted_<seed>.json。 compare.py拿兩份 JSON 比:房間算 IoU(兩個矩形重疊面積除以聯集面積,1.000 代表完全重合),門窗算四個端點裡最大的誤差。
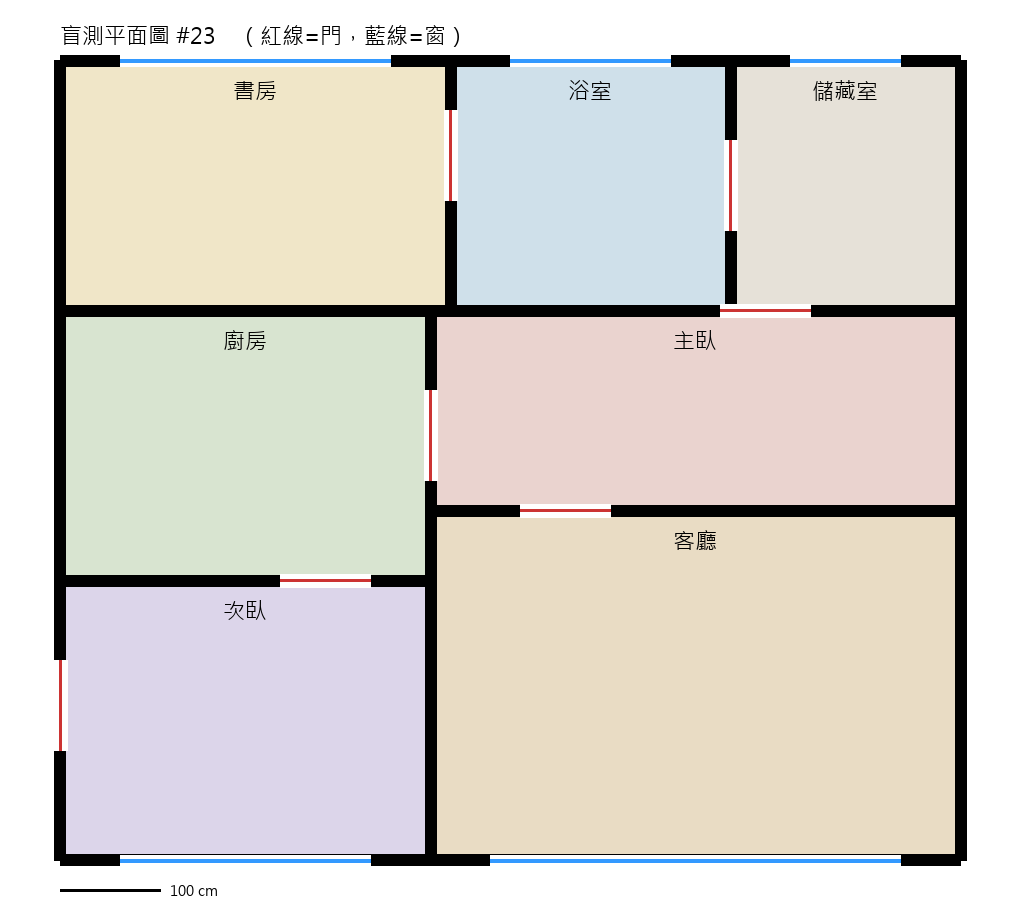
讀法是先用比例尺定比例:比例尺從 x=60 到 x=160 像素是 100 公分,所以 1 像素等於 1 公分,外框左上角在 (60, 60)。之後每條牆、每段紅線、藍線的像素位置減掉 60,就是公分座標。
抽出來的 JSON 節錄:
{
  "size": [900, 800],
  "rooms": [
    {"name": "書房", "x": 0, "y": 0, "w": 390, "h": 250},
    {"name": "主臥", "x": 370, "y": 250, "w": 530, "h": 200}
  ],
  "openings": [
    {"type": "door", "x1": 390, "y1": 50, "x2": 390, "y2": 140},
    {"type": "window", "x1": 60, "y1": 0, "x2": 330, "y2": 0}
  ]
}
三輪盲測的結果
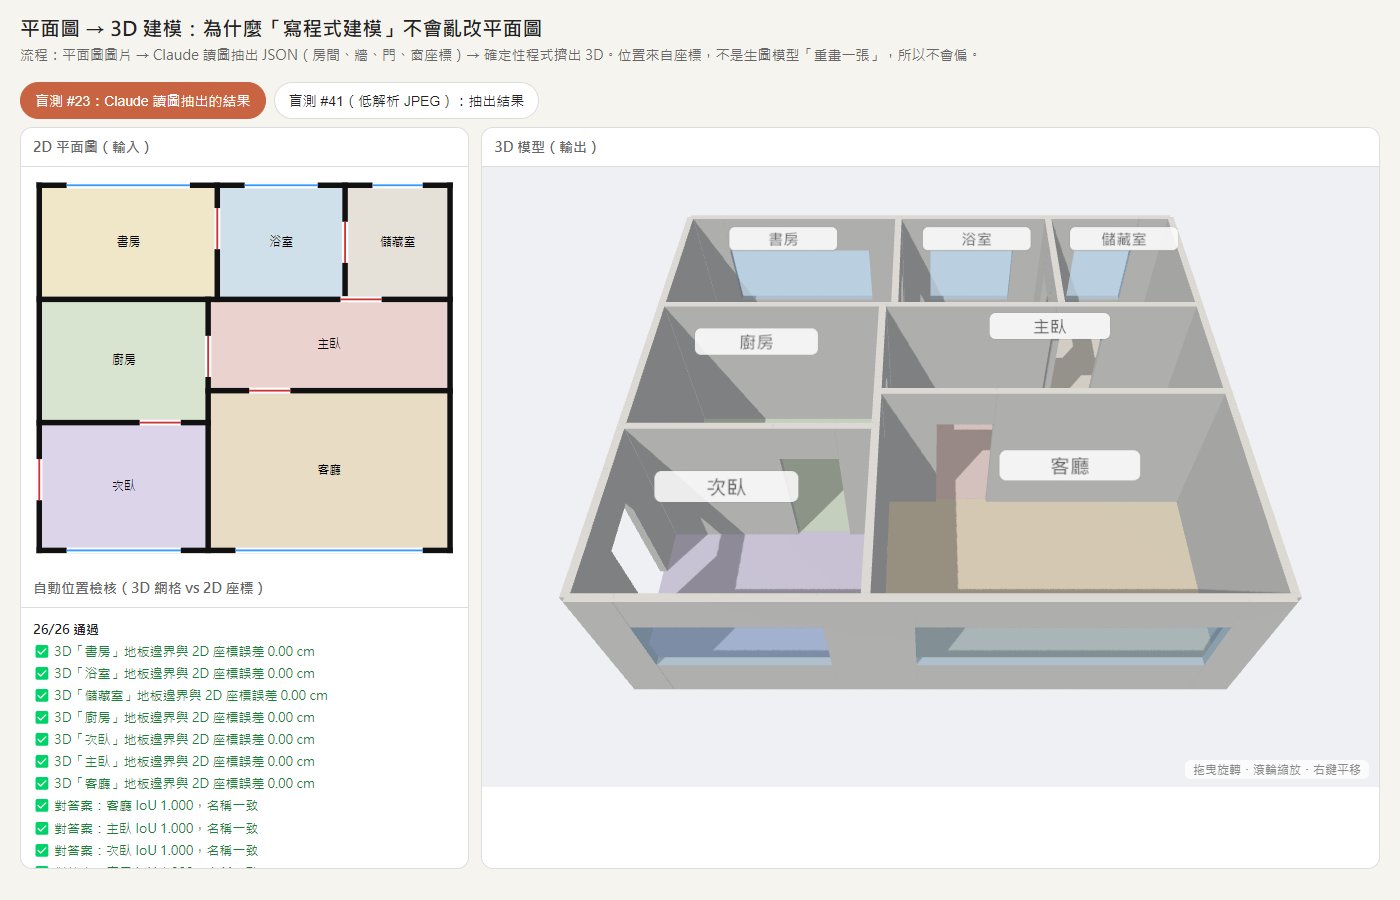
compare.py 對 #23 的實際輸出(節錄):
size gt=[900, 800] ex=[900, 800]
rooms gt=7 ex=7
  客廳   IoU=1.000  name_match=True
  主臥   IoU=1.000  name_match=True
  儲藏室  IoU=1.000  name_match=True
doors gt=7 ex=7
windows gt=5 ex=5
MAX opening error = 0 cm, mean = 0.0 cm
三輪彙總:
| 題目 | 輸入圖 | 房間/門窗 | 房間 IoU | 門窗誤差 | 3D 檢核 |
|---|---|---|---|---|---|
| #7 | 1 px = 1 cm PNG | 6/12 | 1.000 | 0 cm | 24/24 |
| #23 | 1 px = 1 cm PNG | 7/12 | 1.000 | 0 cm | 26/26 |
| #41 | 510 × 460 JPEG,品質 35 | 5/11 | 1.000 | 0 cm | 21/21 |
抽出的 JSON 交給 three.js 後,#23 長成這樣:
低解析 JPEG 也全對,靠的是什麼?
第三輪我故意把圖弄差:原圖 1020 × 920 縮成一半,再存成品質 35 的 JPEG。這時 1 像素等於 2 公分,牆線邊緣也被壓縮糊掉。
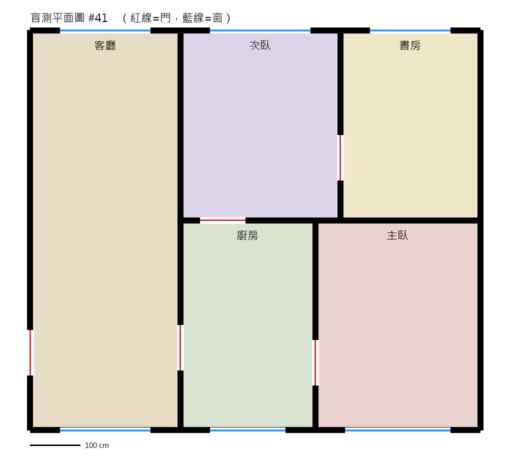
結果仍是 5 間房 IoU 1.000、11 個門窗 0 cm:
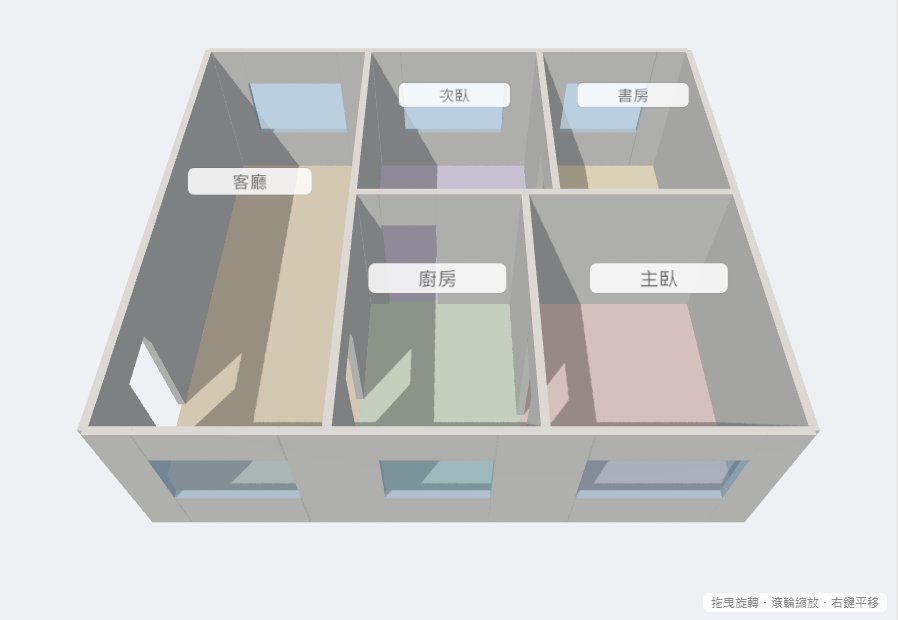
這裡要把功勞分清楚。在 2 公分一格的圖上,單看像素讀值本來就會有一兩格的誤差;能讀到 0 cm,是因為讀的時候套了這套圖的製圖慣例:座標對齊 10 公分格線、門寬 90 公分、牆從外框一路切到底。例如讀值落在 588 就對齊成 590,門的起點讀出來,終點直接加 90。
這也說明了真實圖面要準該靠什麼:尺寸標註和模數。建案平面圖上的尺寸線,扮演的就是這裡「10 公分格線」的角色。讓 LLM 優先讀標註數字、再用像素位置做檢查,比單純量像素可靠。
這個盲測的限制和坑
這組數字證明的是架構可行,不代表真實平面圖也能 0 誤差。我自己知道的限制:
- 圖太乾淨:題目是我程式畫的,只有矩形房間、單一顏色的門窗線,沒有門弧、尺寸線、家具符號、柱子、斜牆,也沒有掃描造成的歪斜。
- 出題者知道規則:生成腳本是我寫的,所以「10 公分格線、門寬 90」這些慣例讀的人事先就知道。換一張不知道模數的陌生圖,就要靠圖上的尺寸標註來補這個資訊。
- 模型不是原文那支:讀圖的是 Claude Opus 5.5,不是原文的 Sonnet 5.5,也沒有走 API 批次跑。
- ChatGPT 沒有實測:「生圖會改格局」來自原文的實際經驗和 OpenAI 官方文件對重複修改的說明,我沒有自己拿 ChatGPT 跑同一組題目。
- 樣本小:三張圖、18 間房、35 個門窗,夠證明管線可行,不夠拿來算準確率的信賴區間。
color 欄位時,我的 2D 預覽 canvas 整片畫成黑色,3D 地板也變成灰白。座標本身沒錯,檢核照樣全過,只看綠勾會漏掉這個問題,要看截圖才發現。
什麼時候用生圖、什麼時候讓 AI 寫程式?
| 你要的是 | 適合的路 | 理由 |
|---|---|---|
| 格局正確、尺寸可量的 3D | 讓 LLM 讀圖成 JSON,再用程式建模 | 位置由座標決定,可以逐項比對驗證 |
| 給客戶看氛圍的室內提案圖 | 生圖模型 | 材質、光影、軟裝是它的強項 |
| 兩者都要 | 先建正確的 3D,再拿 3D 截圖當生圖的構圖參考 | 格局由模型鎖住,外觀交給生圖 |
| 需要修改格局 | 程式建模 | 改一個數字重跑,其他房間不會跟著變 |
想自己試,最短的做法
- 準備平面圖,最好有比例尺或尺寸標註。
- 請 Claude 只輸出 JSON,格式先講定:外框尺寸、每間房的矩形、每扇門窗的兩個端點,單位公分。
- 叫它先說明比例怎麼換算(例如「比例尺 100 像素 = 100 公分」),再給數字。換算邏輯寫出來,錯了才看得出錯在哪。
- 用 three.js 讀 JSON:每面牆依門窗端點切段擠出,門上留門楣、窗下留窗台。
- 拿已知尺寸的一兩間房驗算,對得上再相信其他數字。
?v=blind 會切到盲測 #7。想看做成可以走進去的導覽版本,我另一篇平面圖變可走的 3D 房子有完整的牆體擠出與第一人稱走動做法。