懶人包
- IG 上有一支 Reel 說三個工具就能讓 Claude 自己配音效:Openverse 找素材、MMAudio 看畫面生聲音、earshot 讓 AI「聽」成品。我在 Windows 上把三個都跑了一遍。
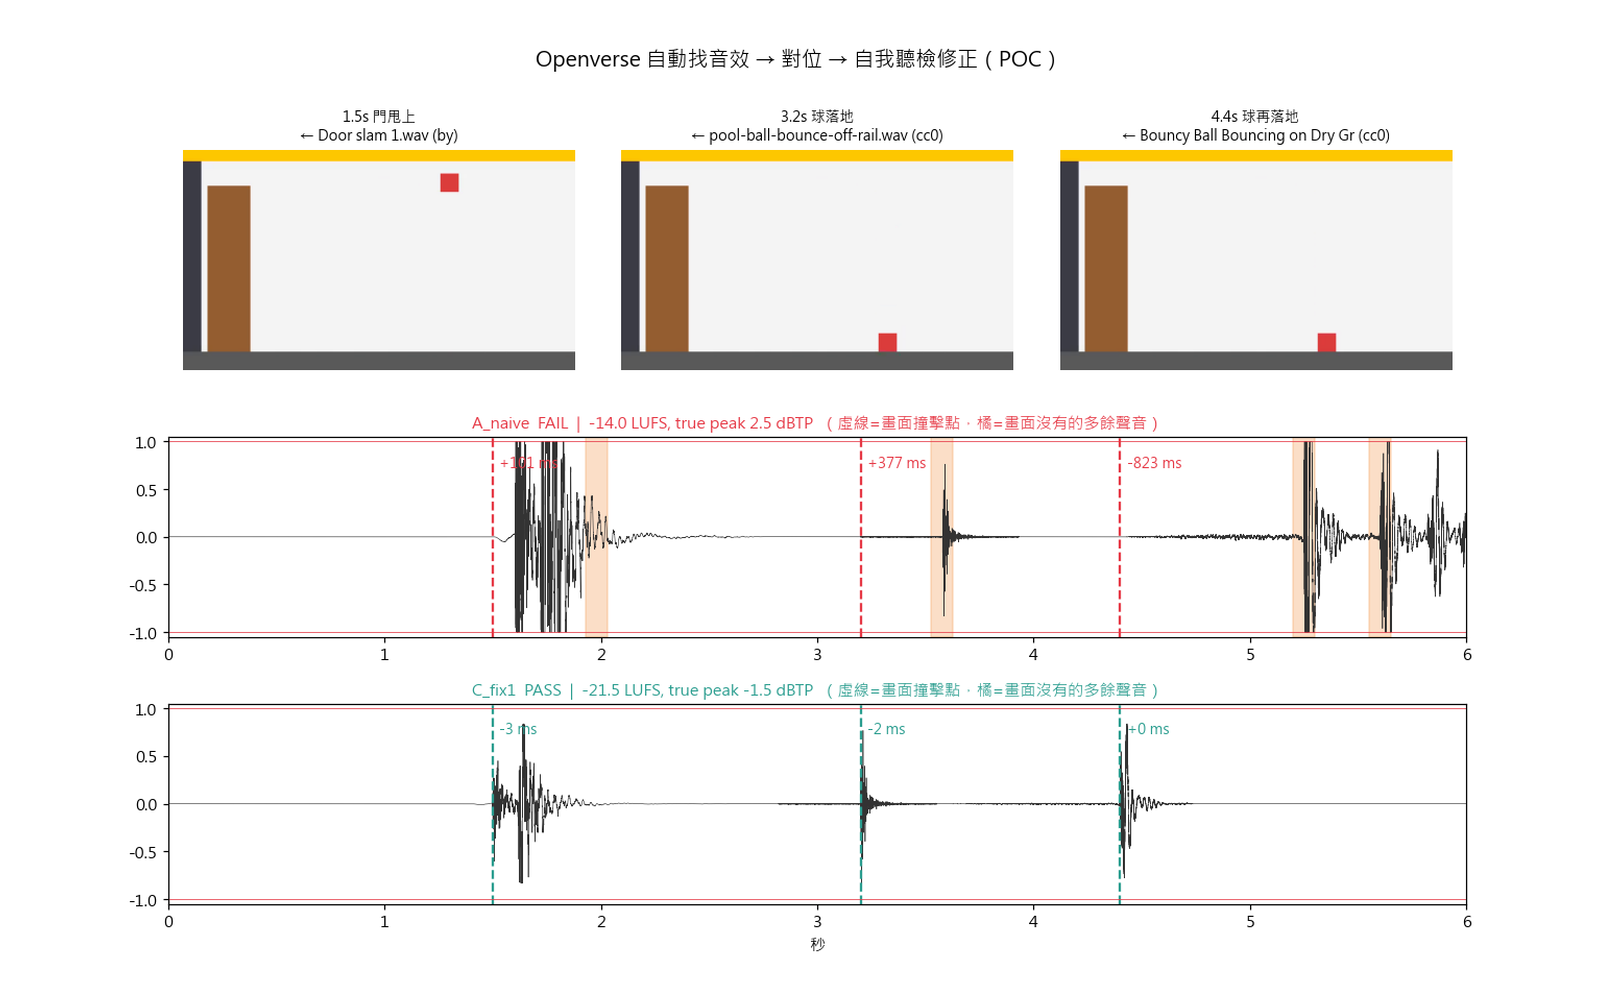
- Openverse 素材直接疊上影片會歪:三個撞擊點偏差 +101、+377、-823 毫秒,true peak +2.5 dBTP 爆音。扣掉素材檔頭靜音再對位,偏差降到 0 到 3 毫秒。
- 能修好靠的是「配完自己檢查、讀結果、對症修」的迴圈:檢查器抓到多餘撞擊和音量過小,自動裁掉多餘那下、加 4.5 dB,修一輪就 PASS。
- earshot 當第二意見很好用,它多抓到兩個我的檢查器漏掉的問題;但每次 CLI 呼叫要 20 到 40 秒,CLAP 標籤會把門聲認成鍵盤聲。
- MMAudio 看畫面生成的聲音三個撞擊點只有一個對到,還多生一串敲門聲,生成的東西一樣要過檢查。
- 「五百多萬個音效」要打折:2026-11-03 查 Openverse 音訊共 522 萬筆,大宗是 Wikimedia 的 399 萬筆,音效主力 Freesound 約 59 萬筆。
我在 IG 看到 kwons_en 的一支 Reel,文案是「剪好一支片,最累的常常不是剪,是找音效」,接著介紹三個工具:Openverse、MMAudio、earshot,說交給 Claude 之後「你要做的,只剩下看成品」。
我想知道的是:Claude 真的能自己判斷「這個關門聲慢了半拍」嗎?如果判斷不了,自動配音效只是把找素材的時間換成檢查的時間。所以我做了一個已知答案的測試:撞擊時間點由我決定,看整條流程能不能自己對到。
三個工具各做什麼?🧰
| 工具 | 做什麼 | 授權 | 跑在哪 |
|---|---|---|---|
| Openverse | 開放授權媒體搜尋引擎,有免登入的 音訊 API | 素材各自標授權(CC0、CC BY 等) | 雲端 API |
| MMAudio | 給影片和提示詞,生成跟畫面對應的聲音(CVPR 2025 論文) | MIT | 本機 GPU |
| earshot | 讓 coding agent「聽」音檔:標記事件、量響度、檢查跟畫面同步 | MIT | 本機 CPU,可當 CLI 或 MCP |
curl -s https://api.openverse.org/v1/audio/stats/| 來源 | 筆數(2026-11-03 查) |
|---|---|
| wikimedia_audio | 3,986,828 |
| jamendo | 644,709 |
| freesound | 591,898 |
| 全部來源合計 | 5,223,435 |
測試怎麼設計?
我用 numpy 畫一支 6 秒、640×360 的影片,裡面有三個撞擊點,時間由程式決定:
- 1.5 秒:門滑到左邊撞牆
- 3.2 秒:球落地
- 4.4 秒:球彈起後第二次落地
合格條件我定成:
| 檢查 | 標準 |
|---|---|
| 同步 | 每個撞擊點 ±45 毫秒內有聲音起點(30fps 約一格半) |
| 多餘聲音 | 離所有撞擊點 150 毫秒以外不能有新的撞擊聲 |
| 峰值 | true peak ≤ -1 dBTP |
| 響度 | -24 到 -12 LUFS |
[1.5, 3.2, 4.4]。
怎麼讓 Claude 從 Openverse 找音效?
Openverse 的音訊 API 不用 API key,直接 GET 就有結果。我篩兩件事:授權只收 CC0、CC BY、Public Domain Mark;長度 0.3 到 4 秒。
API = "https://api.openverse.org/v1/audio/"
OK_LICENSES = {"cc0", "by", "pdm"}

def openverse_pick(query, dl_dir, used):
    qs = urllib.parse.urlencode({"q": query, "page_size": 20})
    req = urllib.request.Request(f"{API}?{qs}", headers={"User-Agent": "line-lab-sfx-poc/0.1"})
    data = json.load(urllib.request.urlopen(req, timeout=30))
    for r in data["results"]:
        dur = (r.get("duration") or 0) / 1000  # duration 單位是毫秒
        if r["license"] in OK_LICENSES and 0.3 < dur < 4 and r["id"] not in used:
            used.add(r["id"])
            out = dl_dir / f"{r['id']}.{r.get('filetype') or 'mp3'}"
            urllib.request.urlretrieve(r["url"], out)
            return {"file": out, "title": r["title"], "creator": r.get("creator"),
                    "license": r["license"], "source_url": r.get("foreign_landing_url")}
兩個實際踩到的點:
duration回傳的是毫秒,不是秒。- 我原本想在查詢參數加
category=sound_effect再配授權篩選,結果回 0 筆。改成只用關鍵字查,授權在程式裡過濾。
| 撞擊點 | 素材 | 作者 | 授權 |
|---|---|---|---|
| 1.5s 門 | Door slam 1.wav | bennstir | CC BY 4.0(要署名) |
| 3.2s 球 | pool-ball-bounce-off-rail.wav | mccarthy@bedmas.com | CC0 |
| 4.4s 球 | Bouncy Ball Bouncing on Dry Grass | NathanaelBray | CC0 |
CREDITS.txt,把作者、授權、原始網址列好。CC BY 的素材公開用要署名,這份清單讓這件事不用回頭再找。
直接疊上去會差多少?📏
A 版是「把素材檔頭對準撞擊點、音量放大三倍疊上去」。B 版扣掉每個素材檔頭的靜音(找第一個超過峰值 -20 dB 的位置),再把每個素材峰值統一。
| 版本 | 三點偏差(毫秒) | LUFS | True peak | 多餘撞擊 | 結果 |
|---|---|---|---|---|---|
| A 直接疊 | +101 / +377 / -823 | -14.0 | +2.5 dBTP | 1.98、3.577、5.248、5.602s | FAIL |
| B 扣檔頭靜音 | -3 / -2 / 0 | -27.1 | -6.0 dBTP | 4.749s | FAIL |
| C 自動修一輪 | -3 / -2 / 0 | -21.5 | -1.5 dBTP | 無 | PASS |
自動修正怎麼做?
B 版對位已經對了,但檢查器回報兩件事:4.749 秒有一個畫面上沒有的撞擊(球彈跳素材本身錄了好幾下),還有整體太小聲(-27.1 LUFS)。
修正迴圈讀檢查結果,對每個問題套一個動作,最多跑三輪:
for rnd in range(1, 4):
    last = results[-1]
    if last["pass"]:
        break
    if last["extra_sounds_s"]:
        # 素材第一下之後又有撞擊:在第二下前 30 ms 淡出裁掉
        clips = [trim_after_first_hit(c, o) for c, o in zip(clips, onsets)]
    loud = last["loudness"]
    if not loud["ok"]:
        step_db = min(-16.0 - loud["integrated_lufs"], -1.5 - loud["true_peak_dbfs"])
        gain *= 10 ** (step_db / 20)
    # 重新混音、重新檢查
增益取「拉到 -16 LUFS」和「峰值不超過 -1.5 dBTP」兩者中較小的那個,所以不會為了大聲而爆音。這次實際動作是裁掉 4.749 秒那一下、總增益 +4.5 dB,第一輪就 PASS。
這段是整件事的重點。找素材、混音都是一般的程式工作;讓結果可信的是那個「量得出來的合格條件」。有了它,Claude 才有東西可以讀、可以修。
earshot 讓 Claude「聽」到了什麼?👂
我的檢查器只會看能量起伏。earshot 多了 CLAP 和 AudioSet 兩個模型,會標記每個聲音像什麼,還會把影片畫面、頻譜、響度和同步標記畫成一張圖。
裝法照 README,要 Python 3.10 以上和 ffmpeg:
git clone https://github.com/Leonxlnx/earshot && cd earshot
python -m venv .venv
.venv/Scripts/python -m pip install torch --index-url https://download.pytorch.org/whl/cpu
.venv/Scripts/python -m pip install -e ".[mcp,llm,dev]"
.venv/Scripts/python -m earshot doctor --load
PyPI 上的 earshot 是另一個同名套件(語音活動偵測),直接 pip install earshot 會裝錯,要從 git 裝。我裝起來的版本是 0.4.0。第一次用會下載約 1.1 GB 的模型。
檢查同步只要給音檔、影片和撞擊點(--cues 吃逗號分隔的秒數,也吃 JSON):
earshot timeline out/C_fix1.wav --video out/scene.mp4 --cues "1.5,3.2,4.4"
earshot sheet out/C_fix1.wav --video out/scene.mp4 --cues "1.5,3.2,4.4"
timeline 輸出文字報告,sheet 輸出一張 PNG 分析圖。
C 版的結論跟我的檢查器一致:
Sync to 3 cues: 100% have an onset within 40 ms (chance 12%), 100% within 100 ms, median |offset| 0 ms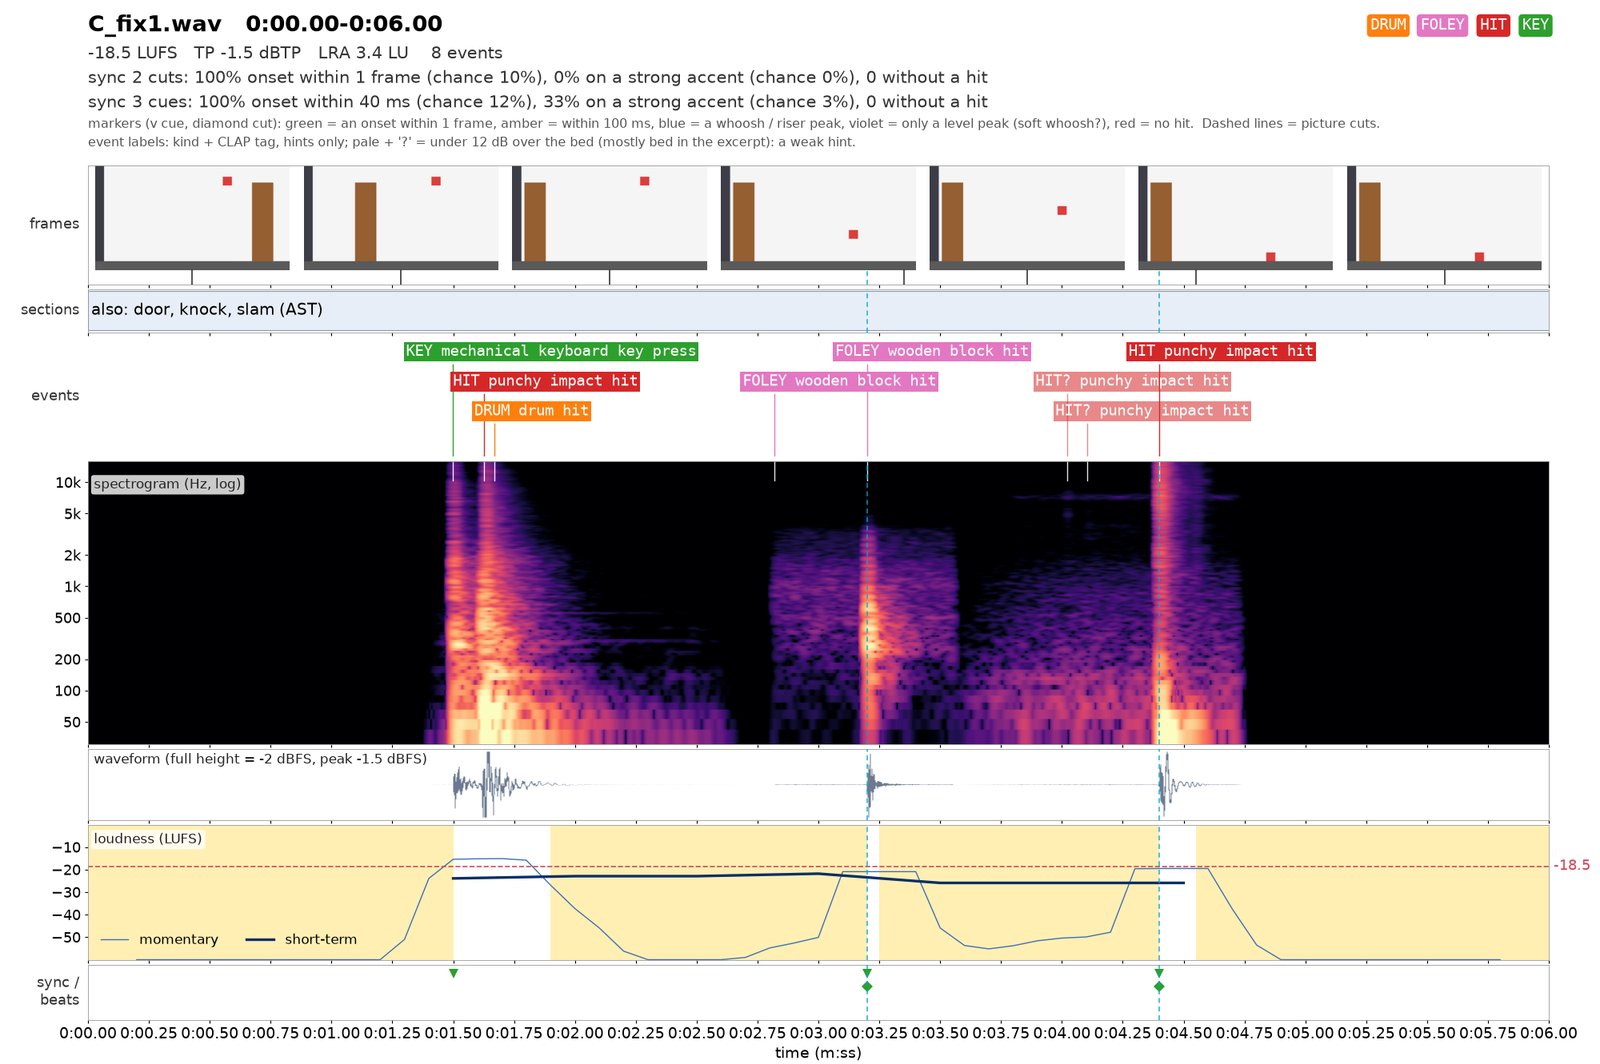
A 版 earshot 抓到 60 段 clipping,三個撞擊點有兩個沒有聲音。
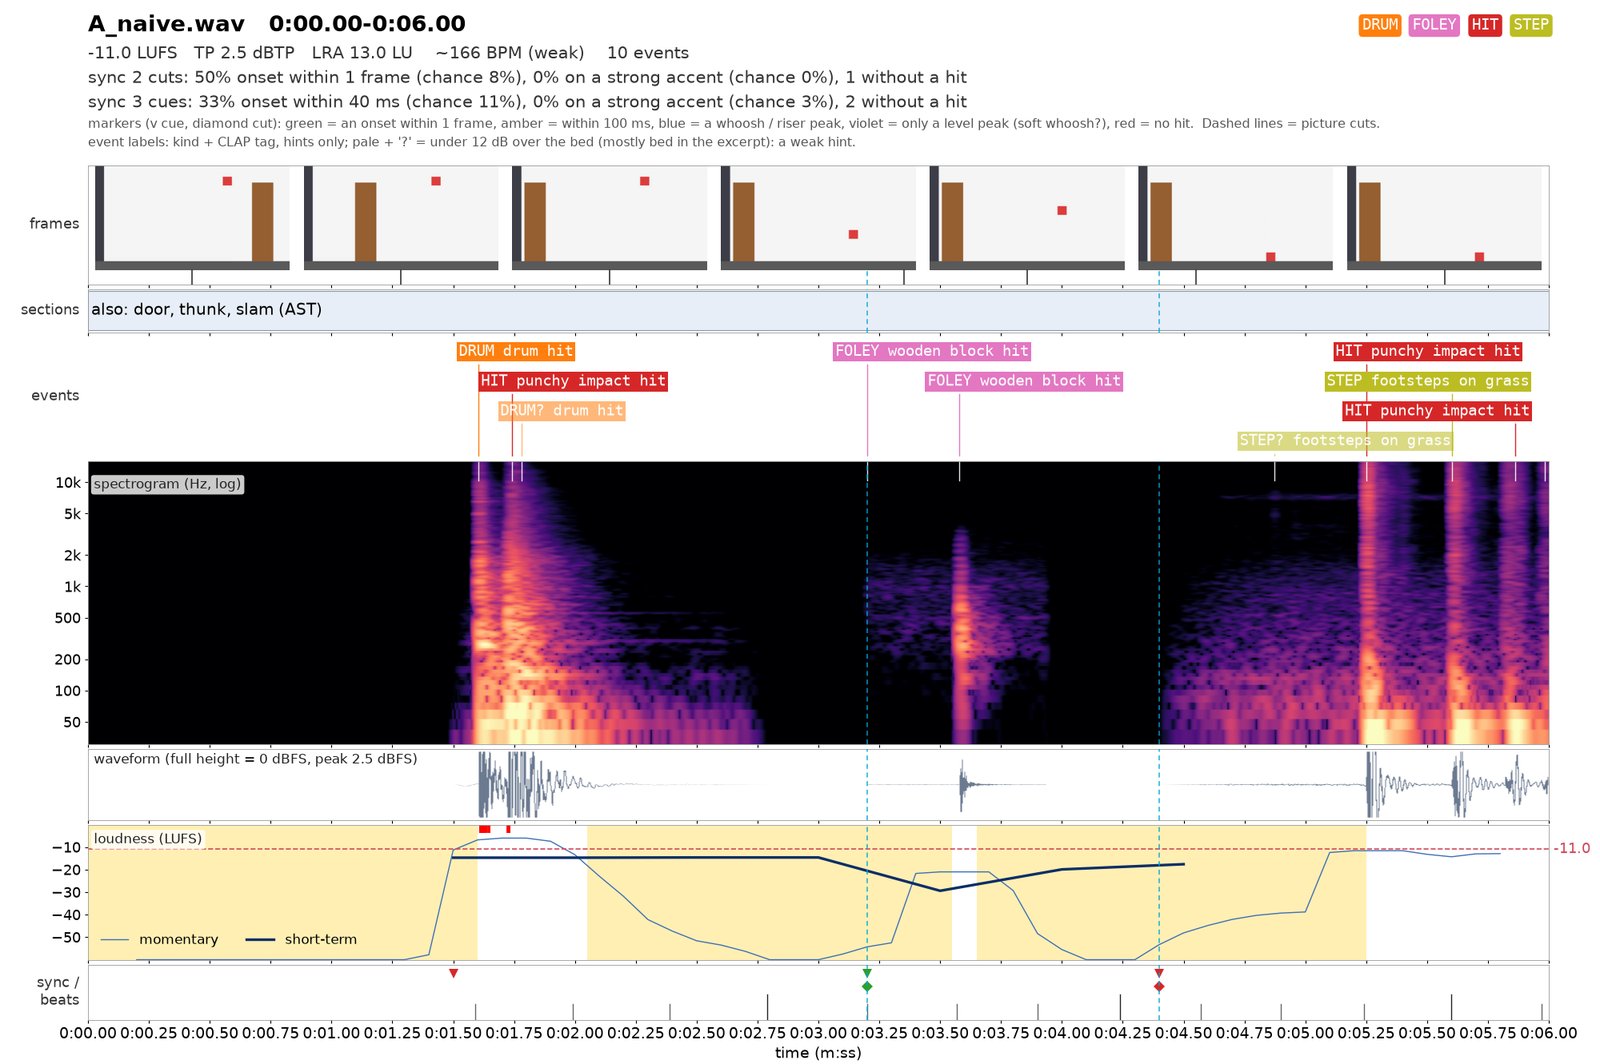
它還多抓到兩件我的檢查器沒抓到的事:
- 門聲素材最響的那一下在 1.67 秒,比畫面晚約 170 毫秒。我的檢查器只看「聲音起點」,起點在 1.497 秒就判定對齊了;但耳朵聽到的重音其實晚了。
- 3.2 秒的球聲素材有約 0.4 秒的底噪,從 2.82 秒就提早進來。
- 第一次跑
timeline含下載模型花 4 分 37 秒,之後每次 CLI 呼叫 20 到 40 秒。README 自己也建議呼叫多次就改用 MCP server,模型會保持載入。 - CLAP 標籤會認錯:1.5 秒的關門聲被標成
mechanical keyboard key press。輸出的 NOTES 自己寫明標籤只是提示。 - 響度跟 ffmpeg 量的不一樣:同一個 C 版,ffmpeg
ebur128是 -21.5 LUFS,earshot 是 -18.5 LUFS。短片大半是靜音,兩邊的 gating 實作不同,不是誰算錯。所以合格條件要固定用同一把尺。
claude mcp add earshot --scope user -e EARSHOT_THREADS=3 -- /path/to/earshot/.venv/bin/python -m earshot mcpWindows 的 python 路徑在 .venv/Scripts/python.exe。我這次是用 CLI 驗的,沒有實際接 MCP。
MMAudio 看畫面生成的聲音對得上嗎?🎬
MMAudio 是另一條路:不找素材,直接看影片生聲音。我用 small_16k 模型,在 RTX 4070 上跑,log 印出的記憶體用量是 3.98 GB:
python demo.py --variant small_16k --duration 6 --video out/scene.mp4 \
  --prompt "a wooden door slams shut, then a rubber ball bounces twice on the floor"
結果 earshot 的判定:
| 撞擊點 | earshot 判定 |
|---|---|
| 1.5s 門 | 對到,-22 毫秒 |
| 3.2s 球 | 100 毫秒內沒有起點,強音在 +151 毫秒 |
| 4.4s 球 | 沒有起點,只有一個平緩的音量上升 |
要說公道話:我的測試影片是純色方塊動畫,不是實拍畫面,對看畫面生聲音的模型很不利。這次的結論只到「生成出來的聲音不保證對位」,不代表 MMAudio 在實拍影片上也是這個表現。它反而說明了檢查那一步不能省,素材是下載的還是生成的都一樣。
模型權重加 CLIP 約 5 GB。
實測踩到哪些坑?🕳️
| 坑 | 現象 | 我的處理 |
|---|---|---|
| 素材檔頭有靜音 | 三個素材分別有 0.105、0.379、0.851 秒靜音,直接對齊檔頭就晚半拍 | 找第一個超過峰值 -20 dB 的位置當起點再對位 |
| 素材裡錄了好幾下 | 球彈跳素材自己彈了好幾下,多出畫面上沒有的撞擊 | 在第二下前 10 毫秒處切斷,淡出 30 毫秒 |
Openverse duration 單位 | 回傳毫秒,當秒用會把所有素材篩掉 | 除以 1000 |
category=sound_effect 加授權篩選 | 回 0 筆 | 只用關鍵字查,授權在程式裡過濾 |
| PyPI 同名套件 | pip install earshot 裝到語音活動偵測套件 | 從 GitHub clone 後 pip install -e |
| MMAudio 在 Windows 的 torch | pip install 把 CPU 版 torch 2.15 和不相容的 torchvision 0.29.2 裝進 venv | venv 加 --system-site-packages,移除那兩個套件,改用系統的 torch 2.7 cu128、torchvision 0.22 |
| 兩把尺量的響度不同 | 同一檔 ffmpeg -21.5 LUFS、earshot -18.5 LUFS | 合格條件固定用 ffmpeg ebur128 判 |
這套流程適合誰?
適合:
- 用程式產影片(Remotion、Kinetograph 這類)的人,撞擊點時間本來就在程式裡,直接當 cue 餵給檢查器。
- 要大量做短片、音效需求是「關門、落地、點擊」這種短撞擊聲的人。
- 需要情緒、氛圍、配樂層次的片子。這次的檢查只量得出「有沒有對到、會不會爆」,量不出「好不好聽」。
- 不想處理授權的人。CC BY 素材公開用要署名,流程要把
CREDITS.txt一路帶到影片說明欄。
我的結論
Reel 說「你要做的,只剩下看成品」,在我這次的測試裡,前提是先把「什麼叫對」寫成程式量得出來的條件。有了合格條件,Claude 能自己找素材、自己發現偏了 823 毫秒、自己裁掉多餘的撞擊聲,再修到 0 到 3 毫秒。沒有合格條件,三個工具串起來也只是更快地產出一支沒人檢查過的片。
我的建議順序:先用 Openverse 加一支自己的檢查程式跑通,earshot 當第二意見接成 MCP,MMAudio 留給找不到素材的特殊聲音。
延伸資源 🔗
- 我的成果頁,A、C 版和 MMAudio 版的影片可以直接聽:claude-sfx-poc
- Openverse 音訊 API 文件:api.openverse.org/v1
- earshot:Leonxlnx/earshot
- MMAudio:hkchengrex/MMAudio
- 用程式產影片的另一篇實測:Kinetograph,用程式產的影片撞擊點時間本來就寫在程式裡,可以直接當 cue 餵給檢查器。
常見問題
Openverse 的音效可以商用嗎?
看每個素材自己的授權。CC0 和 Public Domain Mark 可以直接用;CC BY 可以商用但要署名作者;有 NC 的不能商用。API 每筆結果都有 license 和 license_url,在程式裡篩掉不要的授權最穩。
earshot 需要 GPU 嗎?
不需要,README 寫明只用 CPU。代價是速度:我實測每次 CLI 呼叫 20 到 40 秒,多次呼叫建議用 MCP server 讓模型保持載入。
為什麼不全部交給 MMAudio 生成?
我測的那次三個撞擊點只對到一個,還多生了畫面上沒有的聲音。生成的聲音一樣需要檢查和修正,而生成結果比下載的素材更難局部修改。
PyPI 上的 earshot 跟這個是同一個嗎?
不是。PyPI 的 earshot 是語音活動偵測套件,我 2026-11-03 查到的版本是 1.2.2。讓 agent 聽音檔的 earshot 要從 GitHub clone 後安裝,裝起來版本是 0.4.0。